服务器维护并不是一个单一动作,而是围绕硬件健康、系统稳定、数据安全和业务连续性的一套周期性操作体系。 无论你的服务器是自建机房、托管在IDC还是跑在云上,维护的核心目标都一样:提前发现问题,避免业务中断,在故障发生时能快速恢复。
很多初次接触服务器维护的朋友,第一反应是“就是重装系统、清清灰吧”,真实情况远比这复杂,下面按维护对象的权重,拆解成四个核心模块。
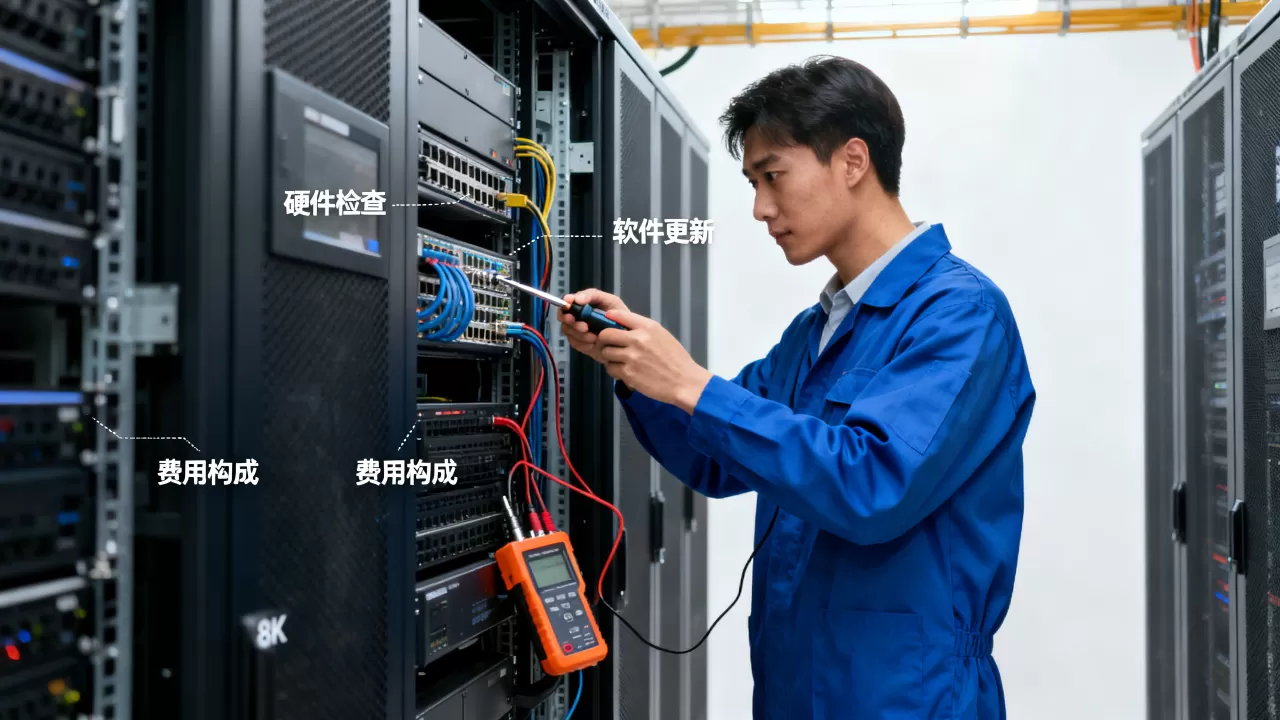
服务器维护工作内容有哪些:硬件层面的“望闻问切”
硬件维护是地基,地基不稳,上层软件再优化也白搭,这部分工作,自有服务器和托管服务器尤其要做,云服务器则可以省掉一部分物理巡检精力。
物理环境巡检(针对机房或托管)
- 机房温湿度是命门,行业共识认为,服务器进风温度建议控制在18℃-27℃之间,相对湿度在40%-60%,超出这个区间,电子元器件寿命会加速衰减,维护时要看空调运转是否正常,有没有备机自动切换机制。
- 供电线路检查,查看UPS(不间断电源)负载率是否超过70%,电池组有没有鼓包漏液,配电柜的接线端子是否有发热变色现象,红外测温枪在这里比手摸靠谱得多。
- 除尘与防尘网清洗,灰尘是静电和短路的温床,根据机房环境,每季度或半年进行一次深度除尘,重点清理CPU散热器鳍片、电源进风口和PCIe插槽区域。
核心部件健康状态监测
这一步需要登录系统查看,重点看三块盘的“脸色”,在Linux系统下,可以用 smartctl -a /dev/sda 查看硬盘SMART信息,关注 Reallocated_Sector_Ct(重映射扇区计数)和 Pending_Sector 这两个数值,只要非零,就该准备换盘了,内存方面,ECC错误虽然可以被纠错,但如果 Corrected ECC Errors 在持续增长,说明内存颗粒不稳,需要尽早更换,CPU健康主要看散热硅脂是否干裂,在负载测试下,如果核心温度超过85℃,就得重新涂抹硅脂或检查散热器扣具压力。
硬件故障替换预案
不要等硬盘红灯报警才动手,维护高手都会提前准备热备盘,所谓热备,就是闲置接口上插着一块同型号同容量的硬盘,一旦RAID阵列里某块盘挂了,系统自动开始重建数据,这一步尤其适合数据库服务器和企业服务器日常维护场景,能极大缩短故障窗口期。
操作系统与软件环境维护:系统层面的“瘦身与加固”
系统跑久了,就会产生日志垃圾、临时文件、陈旧内核,这些都是拖慢响应速度的元凶。
系统补丁与版本更新策略
- 安全补丁必须第一时间打,特别是针对内核漏洞、SSH远程执行漏洞这类高危风险,建议每月最后一周的周末窗口期进行更新操作。
- 大版本升级要克制,切忌在生产环境上追新,业务还在用的旧版本,比如PHP 7.4或CentOS 7,即使官方停止维护,也应通过第三方源或容器化方案继续维持安全补丁覆盖,而不是贸然升到8.0或AlmaLinux 9。稳定压倒一切。
日志分析与存储空间管理
日志文件是排障的北斗导航,维护核心动作有两个:第一是配置 logrotate 日志轮转,确保单个日志文件不超过100MB,保留周期为90天,第二是重点排查 /var/log/messages 或 /var/log/syslog 里的 I/O error、segfault、oom-killer 字样,看到 oom-killer 说明内存不够用了,得考虑扩容或优化应用内存占用;看到 I/O error 则必须立刻检查磁盘线缆和健康状态。
系统性能基线配置
很多维护问题出在初始配置就埋了雷:
- 文件描述符限制:
ulimit -n建议调整为65535以上,否则高并发下服务会报“Too many open files”。 - 内核参数优化:在
/etc/sysctl.conf中设置net.ipv4.tcp_tw_reuse = 1和net.ipv4.ip_local_port_range = 1024 65535,可有效解决高连接数下的端口耗尽问题。 - 定时任务审查:用
crontab -l查看所有用户的计划任务,不少服务器卡顿是因为跑了过于频繁的备份脚本或者日志切割脚本,时间点全挤在同一刻。
服务器维护包括哪些安全加固动作:权限与漏洞的“严防死守”
安全维护不是装个杀毒软件那么简单,对于暴露在公网上的服务器,端口暴露面决定了风险等级。
账号与权限清理
- 重点审查登录用户列表,禁用
root远程SSH登录,修改默认SSH端口(不建议用22)。 - 配置公钥认证,并私钥加密保存,强制关闭密码登录方式,杜绝暴力破解。
- 清理僵尸账号,员工离职后,对应账号需立即注销或禁用,避免出现“幽灵权限”。
基础防火墙与入侵检测
- 使用
iptables或firewalld管理端口访问,生产环境原则是白名单制,只放行业务需要的端口入站,例如仅放通80、443和数据库指定的管理IP端口。 - 开源安全防护软件可以安排上,例如解决暴力破解的
Fail2ban,运行fail2ban-client status sshd即可查看当前封禁的IP列表。 - 定期用
nmap对服务器公网IP做一次外部扫描,行业专家指出,每月一次端口扫描能够发现大量被遗忘的管理端口和高危服务暴露。
应用层安全补丁
使用 wpscan 扫描WordPress插件漏洞,使用 composer audit 检查PHP依赖包漏洞,很多人觉得安全维护费时间,但漏扫一次的成本远低于被勒索病毒加密数据后的损失。
数据备份与容灾演练:最后一道“后悔药”
这一部分是服务器维护的重头戏,也是最容易被忽视的环节,数据丢失时再谈恢复,往往是徒劳。
备份策略的3-2-1原则
行业共识认为,异地容灾必须遵循“3-2-1原则”:数据保留3份拷贝,存储于2种不同介质,其中1份存放在异地,具体应用在自建服务器上可以是:
- 主存储一份(磁盘阵列)
- 近线备份一份(NAS或磁带库)
- 异地冷备一份(对象存储OSS或第三方云存储)
备份验证机制
很多维护事故是“备份一直在跑,但从没恢复成功过”,维护清单里必须包含季度恢复演练:随机抽取一个月度全量备份,在隔离的虚拟机环境里恢复数据库和应用,确认能正常对外提供服务,建议使用 xtrabackup 或 mysqldump 备份MySQL时,同时备份 binlog 日志,确保可以做到时间点恢复(Point-In-Time Recovery)。
自动化备份脚本要点
- 每日增量备份:凌晨低峰期执行。
- 每周全量备份:周日凌晨执行。
- 备份文件命名需包含日期和保留周期,建议脚本中加入“清理30天前过期备份文件”的逻辑,避免备份磁盘被写满导致系统崩溃。
自建与外包的账本:服务器维护怎么收费才划算
聊完技术动作,很多团队在规划时都会问:是自己招运维划算还是找外包服务商更省心?这里给一个预算估算逻辑。
| 维护模式 | 适用场景 | 成本结构 | 响应时效 | 适合规模 |
|---|---|---|---|---|
| 自行维护 | 有专职运维,技术能力强 | 人力工资+硬件备件库 | 分钟级到小时级 | 大型企业/互联网公司 |
| 第三方托管运维 | 无专职运维,但业务依赖IT | 按月服务费,约数百至数千元不等 | 小时级 | 中小企业 |
| 云厂商代维 | 全云上业务,按量付费 | 资源包+技术支持包 | 平台SLA保障 | 初创团队/项目型公司 |
对于小型公司服务器维护需要多少钱这个问题,建议按“每月一台服务器的维护预算不应低于云资源费用的20%”来匡算,如果低于这个数,大概率维护动作是缺失的,考虑到一次业务中断的损失动辄数万元,这笔预算花得绝对不冤。
Q&A:关于服务器维护的高频疑问
问:服务器维护好做吗?需要具备哪些技能?
答:入门不难,但精通需要系统知识,基础维护,如重启服务、清理磁盘、查看日志,掌握Linux常见命令即可上手,真正难的是性能调优和故障预测,这需要理解内核参数、存储原理、网络协议栈,建议从处理告警信息开始积累经验,多复盘故障案例,逐步建立自己的排障清单。
问:服务器日常维护频率多久一次合适?
答:常规巡检建议每周一次,重点查看磁盘占用率、内存余量、CPU平均负载和硬件报错日志,深度维护,包括系统小版本升级、安全补丁批量安装、硬件灰尘清理,建议每月执行一次,核心业务系统需要配合变更管理窗口,避开业务高峰。
问:服务器维护包括哪些应急处理动作?
答:核心三件事,第一是切断故障源,比如看到RAID盘闪红灯,有热备盘就触发重建,没有就立即隔离故障盘槽位,第二是保留现场证据,等待RAID自动同步完成后,再抓取日志截图,切忌慌乱中反复重启加重故障,第三是启动预案,优先恢复读业务,其次恢复写业务,数据一致性永远是第一位。
服务器维护的终极目标不是“不出事”,而是“出了事能快速站起来”,回归本质,硬件是骨架、系统是肌肉、安全是免疫系统、备份是造血干细胞,四者兼顾,这台服务器才算真正上了保险。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/760351.html