行情峰值前的带宽预扩容,核心在于“提前两周测算、提前一周压测、提前三天完成扩容”,这三步走完,大促当天带宽瓶颈基本可控。
带宽预扩容的黄金时间窗口
带宽资源不像服务器内存,说加就加,运营商那边有工单流程,机房上架也有物理操作时间,多数情况下,从提交扩容申请到线路真正生效,需要3到7个工作日,行业共识认为,大促或行情发布前第14天是启动预扩容的最晚时间节点,这能留出足够的缓冲期应对突发状况。


为什么不能等流量涨了再扩容
流量增长是陡峭的曲线,不是缓坡,当用户访问量突然翻倍时,带宽打满的那一瞬间,丢包、延迟、连接超时接踵而至,用户刷新两次页面没打开,就直接流失了,更麻烦的是,带宽打满后,TCP连接会大量堆积,即使你立刻扩容,这些堆积的连接也需要时间消化,损失已经造成。
所以预扩容的本质是提前买保险,用确定性的成本,对冲不确定性的流量冲击,具体到执行节奏,可以参考这个时间表:
- 第14天:拉取历史流量数据,按去年同期的5到2倍做峰值预估
- 第10天:向运营商提交扩容工单,同步准备压测脚本和测试数据
- 第7天:扩容完成,开始进行第一轮压测验证
- 第3天:根据压测结果调优配置,进行第二轮小规模验证
- 第1天:最后检查各项监控指标,确保告警阈值已更新
带宽扩容需求怎么测算
做技术的人都知道,拍脑袋定带宽等于埋雷,测算需要依据实际数据说话,往上翻历史流量曲线,找出同一周期内最高峰值,然后在这个基础上加余量。
计算公式与冗余策略
基础带宽需求可以按这个简单公式估算:
预估带宽 = 历史峰值带宽 × 业务增长率 × 活动系数
业务增长率参考近半年的日均增幅,活动系数看大促力度,比如常规大促活动系数定为1.5,全网级活动可以定到2.0。
这里有一个关键点:运营商给的带宽单位要把Mbps转换成实际的字节吞吐量,一条100Mbps的独享带宽,理论下行速度约为12.5MB/s,但实际传输效率受数据包大小、TCP窗口等因素影响,多数情况下只能达到理论值的80%到90%,换算的差距如果忽略,上线后容易吃暗亏。
带宽预扩容和临时带宽的区别
很多人会问:临时加带宽不行吗?大促前一两天申请按量计费的临时带宽,听起来灵活,但代价是单价更高,以国内主流云厂商的定价来看,临时扩容的按量计费价格通常是包年包月的5倍到3倍,换句话说,临时带宽适合应急,不适合作为常规策略。
直播平台带宽扩容价格就更敏感,因为直播消耗的是持续性的流量,不像网页访问有高峰和低谷,直播场景的预扩容,建议直接拉专线而不是挤在共享带宽池里,专线的QoS保障在关键时刻能救命。
压测验证的具体操作路径
带宽扩上去了,不等于就万事大吉,扩的是链路,扛压的是整个系统链路,从负载均衡到后端应用服务器,任何一环掉链子,带宽再大也没用。
压测前的环境检查清单
先确认环境状态,再动手压测,下面这几项没过关,压测数据不具备参考价值:
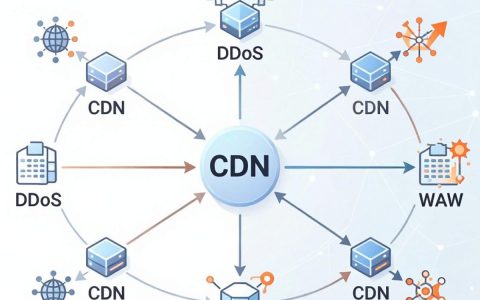
- 确认所有CDN节点缓存命中率在90%以上,命中率太低的话,回源流量会瞬间击穿带宽
- 检查WAF策略是否误伤压测流量,很多防火墙默认拦截高频请求
- 核对负载均衡的后端权重配置,确保新扩容的带宽会被充分利用
- 确认监控系统的数据采集间隔,建议在10秒以内,太长的监控间隔会掩盖瞬时峰值
压测工具选型与参数配置
业内用得比较多的是wrk、JMeter和Locust,wrk适合测HTTP接口的吞吐能力,JMeter适合跑复杂业务场景,Locust的分布式能力更强,可以模拟不同地域的真实用户流量入口。
压测的时候别一股脑全量打,要分梯度进行,先跑3分钟低并发热身,确认基础链路稳定后,再按
50%、80%、100%、120%的预估峰值逐级加压,记录每个级别的响应时间变化,正常情况下P99延迟应该保持平稳,如果出现阶梯式上升,说明系统某个环节已经逼近瓶颈。
压测机器建议用多台地域分散的施压节点,避免单机源IP被限流导致压测结果失真,比如华东、华北、华南各放一台施压机,模拟真实用户的分布情况。
压测后的瓶颈定位与调优
压测跑完,数据只是开始,关键是看数据找问题。
三种典型瓶颈特征
抓问题先看特征,压测过程中出现这几种现象,对应的瓶颈区域基本可以锁定:
| 现象 | 瓶颈位置 | 排查方向 |
|---|---|---|
| 带宽使用率低但响应变慢 | 应用服务器 | 数据库连接池、线程池配置 |
| 带宽使用率打满且丢包严重 | 出口链路 | 运营商线路质量、防火墙吞吐 |
| 各节点负载不均 | 负载均衡策略 | 会话保持配置、权重分配 |
回源流量与CDN缓存策略调整
很多情况下带宽不够用不是真的不够,而是大量重复请求穿透了CDN,首页和热点数据的缓存TTL可以适当延长至300秒到600秒,动态接口的缓存策略则要在业务允许范围内设置,压测过程中留意回源比例,如果回源带宽占了总带宽的相当一部分,说明缓存命中率还有提升空间。
TCP参数调优也是必要一步,Linux服务器上默认的TCP缓冲区设置偏向通用场景,高带宽下需要调整:
# 调整TCP读写缓冲区最大值
sysctl -w net.ipv4.tcp_rmem='4096 87380 16777216'
sysctl -w net.ipv4.tcp_wmem='4096 65536 16777216'
# 启用BBR拥塞控制算法,提升高延迟链路吞吐
sysctl -w net.core.default_qdisc=fq
sysctl -w net.ipv4.tcp_congestion_control=bbr
调整后回源效率会有直观提升,尤其在跨地域传输场景下体感更明显。
预扩容期间的监控告警配置
扩容和压测完成之后,监控不能还停留在日常水位,带宽使用率的告警阈值必须下探,留出提前响应的时间。
告警阈值与通知机制
- 带宽使用率的预警阈值设为70%,这时候有充足时间排查
- 带宽使用率的告警阈值设为85%,触发后立即自动扩容或切流
- 监控对象要细化到每台服务器和每个IP,避免整体使用率不高但单点打满的情况
- 通知渠道要包含电话短信,不能只依赖企业微信或钉钉群,深夜大促期间钉钉消息容易被淹没
大促当天的实时观察重点
实时观察的时候,注意下面几个关键指标的变化:
连接数指标比带宽指标反映问题更及时,带宽是结果,连接数是原因,活跃连接数突然翻倍,即使带宽还没满,也已经预警流量正在涌入。SYN_RECV状态的连接数如果持续增多,说明TCP半连接队列被打满,这是DDoS攻击或突发短连接的典型信号,需要立即启用清洗或限流策略。
行情峰值前带宽预扩容常见问题
预扩容后流量没达到预期,带宽费用谁来承担
带宽按实际使用计费的部分不需要担心,大多数主流云厂商支持按量付费的带宽包,用多少算多少,但如果是包年包月的独享带宽,扩上去没用到确实会浪费这部分预算,建议方案是涨价幅度可控的时期采用临时提升的方式,比如包月带宽临时升配,大促结束后再降回来,费用按天折算,成本最优化。
大促前一周压测发现性能瓶颈,时间不够怎么处理
先做分流,把非核心业务限流或降级,核心链路优先保障,具体的处理动作是:静态资源全部切到CDN,动态接口的数据库查询加缓存,关闭非必要的日志输出,最后再验证一次核心接口的压测结果,如果仍然不达标,只能牺牲部分用户体验,比如限制单用户并发,确保系统不雪崩,底线是保住交易链路。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/760527.html