行情数据落盘这件事,真正的答案不是”内存还是磁盘”二选一,而是让内存负责最近几秒的热数据、让顺序追加的日志文件负责永不丢失的账本,中间靠内存映射把两者缝成一条流水线。
做过交易系统的人都懂,行情数据有个别扭的性子:写得飞快、读得集中、几乎不改、还得一条不丢,你把它全塞进 Redis,跑得是爽,可一旦进程崩了、主机断电了,内存里那几秒的报价就永远找不回来;你把它全写成小文件一条条 fsync,安全是安全,可撮合引擎等你的 IO 等到超时,所以分层不是架构师的洁癖,是被物理规律逼出来的选择。

行情数据落盘与内存缓存怎么分工:先看清延迟量级
从纳秒到毫秒,差了六个数量级
先把账算清楚,后面所有设计才有依据,业内公认的访问代价大致是这样:
| 存储层级 | 典型访问延迟 | 典型容量 | 行情场景里的角色 |
|---|---|---|---|
| CPU 缓存 / 应用内存 | 纳秒级 | GB 级 | 最新价、盘口快照 |
| 共享内存 / 内存数据库 | 微秒级 | 十 GB 到百 GB 级 | 跨进程读取的热数据 |
| NVMe SSD 顺序写 | 几十微秒级 | TB 级 | 当日逐笔、快照落盘 |
| 机械盘随机写 | 毫秒级 | TB 到 PB 级 | 历史归档、合规留存 |
六个数量级的差距意味着:任何把热点行情访问路径搭在磁盘上的设计,从第一天起就注定了延迟抖动。分校的原则很简单被读得最多的数据放最贵的介质,被写得最多的数据放最便宜的介质,两者之间用异步通道连接。
哪些数据必须留在内存里
判断标准不是”重要不重要”,而是”被访问的频率和时效要求”:
- 最新盘口与最新成交价:策略每秒可能要读上千次,必须常驻内存。
- 当日 K 线聚合中间态:正在被反复累加更新,落盘只存结果。
- 订阅关系与合约元数据:变更极少、读取极频,缓存命中率接近百分之百。
- 最近若干秒的逐笔明细

:用于断线重连补发,属于”热窗口”数据。
行业共识认为,一个行情系统里真正需要毫秒级响应的数据,通常只占全量数据中很小的一个比例,其余大部分都是”写进去、偶尔查”的冷数据。
内存数据库和磁盘存储哪个快?先别急着二选一
用追加日志把写入路径拉直
磁盘慢,慢在寻道和随机写,如果你的落盘格式是”更新某一行记录”,那每次写都可能触发一次随机 IO,性能自然崩,行情数据恰好天然适合顺序写:它是时间序列,只追加、不修改。
把落盘设计成 append-only 的日志文件,写入就变成了往文件尾部塞字节,再配合操作系统的页缓存(page cache),应用层的写调用几乎是内存速度返回,真正的刷盘由内核批量完成。
# 预分配文件,避免运行期扩容带来的元数据操作抖动
fallocate -l 16G /data/tick/tick_20260301.bin
# 观察写入是否真的落在顺序路径上
iostat -x 1
iostat 里你要盯的是 await 和 %util,而不是吞吐数字,顺序写的 await 应该稳定在很低的水平,一旦开始抖动,多半是有别的进程在抢盘。
用 mmap 把内存和文件缝在一起
内存映射是个巧妙的中间态:文件在磁盘上,但你可以像访问数组一样访问它,读的时候由内核按页调入,写的时候由内核按脏页回刷,对于”写多读少、顺序追加”的行情文件,mmap 能省掉一次用户态到内核态的数据拷贝。
要点在于预分配 + 顺序追加 + 不复用已写区域,只要写指针单调向前,就不会产生缺页中断之外的额外开销。
高频行情系统缓存架构设计:一套可落地的四级结构
L1 应用内无锁环形缓冲
行情接入线程只管往环形缓冲里塞数据,落盘线程从另一端取,用 CAS 或原子指针做生产者消费者同步,避免互斥锁在热点路径上制造排队。
缓冲区大小按峰值行情速率乘以容忍的积压时间估算,比如某交易所单路行情峰值每秒几十万条,缓冲要能扛住下游短暂卡顿几秒不丢数据。
L2 共享内存做进程间热数据
多个策略进程、风控进程、监控进程都要读最新行情,用共享内存比走网络或 Unix Socket 都快。
注意给共享内存段加 mlock 锁定,防止被换出到 swap。
# 调整进程可锁定内存上限
ulimit -l unlimited
# 落盘密集型的机器,应该压低脏页阈值,让回刷更平滑
sysctl -w vm.dirty_background_ratio=5
sysctl -w vm.dirty_ratio=10
sysctl -w vm.swappiness=1
vm.dirty_ratio 默认值偏高,意味着内核会攒很大一批脏页再一次性刷盘,结果就是偶尔来一次几百毫秒的 IO 尖峰,对延迟敏感的行情节点,把这几个值调低,用更频繁的小批量回刷换更平稳的尾部延迟。
L3 顺序追加的持久化日志
落盘层其实是两层:一层是日志,一层是快照。
- 日志负责”一条不丢”,写进去就算数,格式紧凑,按时间或大小滚动。
- 快照负责”快速恢复”,定期把内存态整体 dump 一次,重启时先加载快照再重放日志。
如果直接用 Redis 这类内存数据库做缓存,持久化策略上要权衡:RDB 快照恢复快但可能丢较多数据,AOF everysec 最多丢一秒左右,always 几乎不丢但每条都 fsync,吞吐会明显下滑。
redis-cli config set appendonly yes
redis-cli config set appendfsync everysec
L4 冷数据归档与列式存储
超过当日的行情基本不再参与实时计算,继续放在高速盘上就是浪费,把它们压缩后转到对象存储或大容量 SATA 盘,按合约和日期分区,回测和合规查询走这条冷路径,跟实时链路物理隔离。
行情数据落盘延迟怎么优化:几个可验证的参数
磁盘调度与队列深度
NVMe 设备上把调度器设成 none,让硬件自己管队列:
echo none > /sys/block/nvme0n1/queue/scheduler
机械盘则更适合 mq-deadline,它对顺序写的合并更友好。
批量提交代替逐条 fsync
每来一条行情就调一次 fsync,性能会惨不忍睹,正确做法是攒批:用一个后台线程每几毫秒或每积累若干条触发一次 fdatasync,把整批数据一次性推下去,牺牲的是极端情况下几毫秒的数据窗口,换来的是吞吐成倍提升。
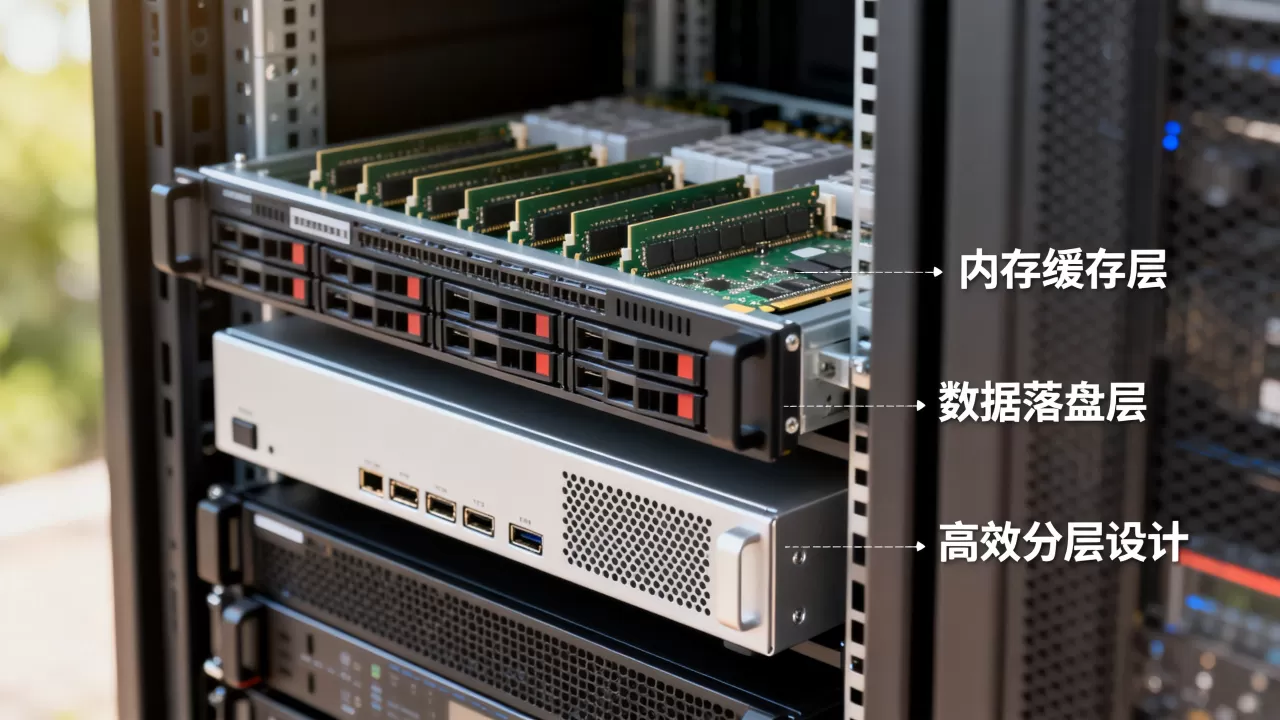
想验证效果,可以压测对比两种模式下的 P99 延迟,差距通常会非常明显。
深圳券商高频行情数据存储方案的成本账
内存缓存和全量落盘的价格差多少
这是个必须算的经济账,单位容量的内存价格远高于 SSD,SSD 又高于机械盘,差距是数量级级别的,假设你要保留一年的逐笔行情,全放内存根本不现实,成本会失控;全放机械盘在线查询又慢得没法用。
比较务实的组合是:
- 当日热数据放内存,容量按峰值行情量估算,通常几十 GB 量级。
- 近一周数据放 NVMe SSD,兼顾查询速度和成本。
- 更久的历史走大容量盘加压缩,只保证能查、不保证快。
托管位置也是个变量,把行情节点放在交易所机房附近(比如上海、深圳的托管机柜),网络延迟能压到很低;异地灾备节点则可以放宽落盘策略,优先保证吞吐和成本。
行情数据落盘与内存缓存分层常见问题解答
内存缓存和落盘之间要不要做一致性校验?
要,但方式要轻,常用做法是给每条记录带一个单调递增的序列号,内存和日志各自维护写指针,恢复时从快照的序列号开始重放日志,遇到断点就截断,这样不需要逐条比对,成本极低。
行情数据量很大时,落盘文件应该怎么切分?
按合约维度分目录,按日期滚动文件,单个文件大小控制在几百 MB 到几 GB 之间,文件太大不利于并行恢复,太小则元数据开销和文件句柄压力上升,多数生产系统的经验区间落在几百 MB 这个量级附近。
用消息队列做落盘缓冲靠谱吗?
靠谱,而且很常见,Kafka 这类系统本身就是顺序追加加页缓存的设计,天然适合承接行情流,你的接入进程只管往 topic 里写,下游消费者负责落盘、入湖、分发,代价是多了一跳网络和序列化开销,但对绝大多数非极致低延迟的场景,这个代价换来的解耦和可回放能力是划算的。
行情数据的存储设计,说到底是把”快”和”不丢”这两件互相拉扯的事拆到不同层去各自实现,内存负责快,顺序追加负责不丢,中间用异步管道连接只要写入路径是单调向前的,你就不需要为了一致性付出随机 IO 的代价。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/761002.html