交易系统容器化部署对延迟的不确定性,核心不在容器本身,而在网络路径、内核调度、CPU隔离与存储I/O的叠加抖动;把这些变量收敛后,容器化能扛住相当一部分低延迟交易场景,但纳秒级策略仍要谨慎。
交易系统容器化部署对延迟的不确定性大吗
很多团队第一次把交易系统搬进容器时,都会盯着一件事:P99延迟有没有跳,答案不是“一定变大”,而是“看你怎么配”,容器通过cgroup和namespace隔离进程,本身开销很小,真正让延迟飘起来的是旁边那几层:网络虚拟化、CPU配额、日志驱动、邻居Pod抢资源。
先分清延迟类型
- 网络延迟:交换机、网卡、协议栈、Overlay封装。
- 处理延迟:策略计算、序列化、内存分配。
- 排队延迟:CPU runqueue、网卡队列、磁盘IO队列。
- 内核调度延迟:CFS节流、中断处理、NUMA跨节点访问。
不确定性来自哪里
- 网络层:默认CNI如Flannel VXLAN会做封包解包;kube-proxy的iptables或ipvs规则多,conntrack表一满就丢包重传。
- CPU层:cgroup CPU quota设小了,进程会被throttle;跨NUMA访问内存,延迟直接上一个台阶。
- 存储层:容器日志用json-file同步写盘,行情落盘和日志抢同一块盘,P99.9就难看。
- 内核层:中断都打到CPU0,交易线程被频繁打断;透明大页、NUMA balancing也会带来抖动。
低延迟交易系统容器化与物理机部署延迟对比
业内常拿物理机、虚拟机、容器做对比,真实情况是:调优后的容器,P50可以接近物理机;P99和P99.9更依赖网络插件和CPU绑核,下面这张表是定性对比,不替代你自己的压测。
| 维度 | 物理机 | 虚拟机 | 容器/K8s |
|---|---|---|---|
| P50 | 最低 | 略高 | 接近物理机 |
| P99 | 稳定 | 受Hypervisor影响 | 取决于CNI与CPU隔离 |
| 抖动 | 小 | 中 | 可小可大 |
| 弹性 | 差 | 中 | 强 |
| 部署密度 | 低 | 中 | 高 |
| 故障域 | 大 | 中 | 小 |
| 可观测 | 需自建 | 中 | 成熟 |
| 成本 | 高 | 中 | 低 |
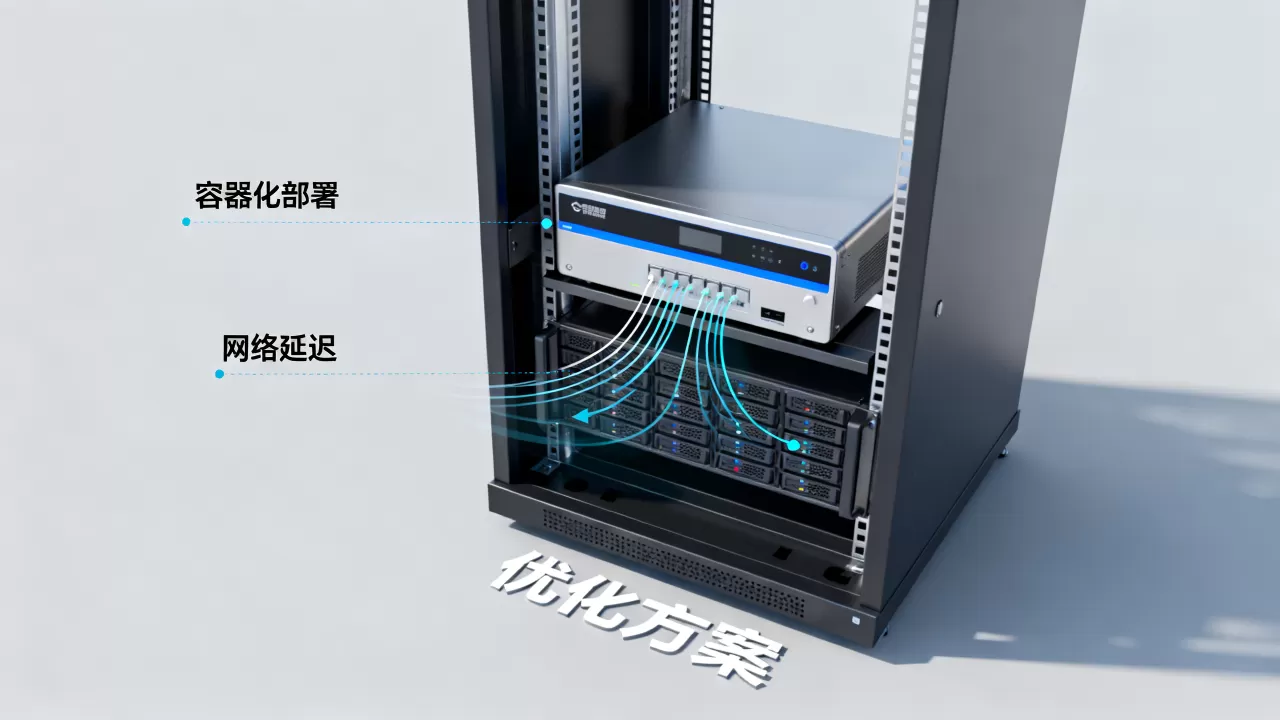
行业共识认为,低延迟场景的瓶颈通常不在容器运行时,而在网络和调度配置,把hostNetwork、SR-IOV、CPU静态绑核做好,容器不会天然比物理机慢;但如果你用默认Overlay网络加默认CPU quota,延迟不确定性一定大。
哪些交易策略适合容器化
- 中低频、日内、组合策略。
- 多品种、多市场、需要快速扩缩容的策略。
- 回测、仿真、风控、行情分发等非纳秒级链路。
哪些策略要谨慎
- 高频做市、套利、FPGA硬件加速。
- 对P99.9有硬性要求的撮合周边系统。
- 无法控制内核参数、无法独占CPU的共享集群。
期货高频交易场景下容器化部署延迟排查
排查顺序:从硬件到容器
- 建基线:同一台机器,物理机跑一遍,容器里跑一遍,用相同负载和相同行情回放。
- 查CPU:
lscpu、numactl --hardware、cat /proc/cmdline看isolcpus、nohz_full、rcu_nocbs。 - 查网络:
ip -s link、ss -s、ethtool -S eth0、ethtool -C eth0。 - 查内核:
perf sched latency、bpftrace、/proc/interrupts。 - 查存储:
fio、iostat -x 1、cat /sys/fs/cgroup/blkio.。
业内专家指出,延迟排查最怕一次改十个参数,应该先建基线,再每次只动一个变量。
可验证命令与路径
- 查看CPU节流:
cat /sys/fs/cgroup/cpu.stat,重点看
nr_throttled
throttled_usec。 - Docker绑核:
docker run --cpuset-cpus="2-5" --cpu-rt-runtime=950000 --ulimit rtprio=99 ... - Kubernetes CPU Manager:
cpuManagerPolicy: static,配合topologyManagerPolicy: single-numa-node。 - 内核调优:
tuned-adm profile latency-performance。 - 网卡中断合并:
ethtool -C eth0 rx-usecs 0 rx-frames 0,需结合网卡型号验证。 - 跟踪发送调用:
bpftrace -e 'tracepoint:syscalls:sys_enter_sendto { @[comm] = count(); }' - 磁盘压测:
fio --name=randwrite --ioengine=libaio --rw=randwrite --bs=4k --numjobs=4 --size=1G --runtime=60 --group_reporting
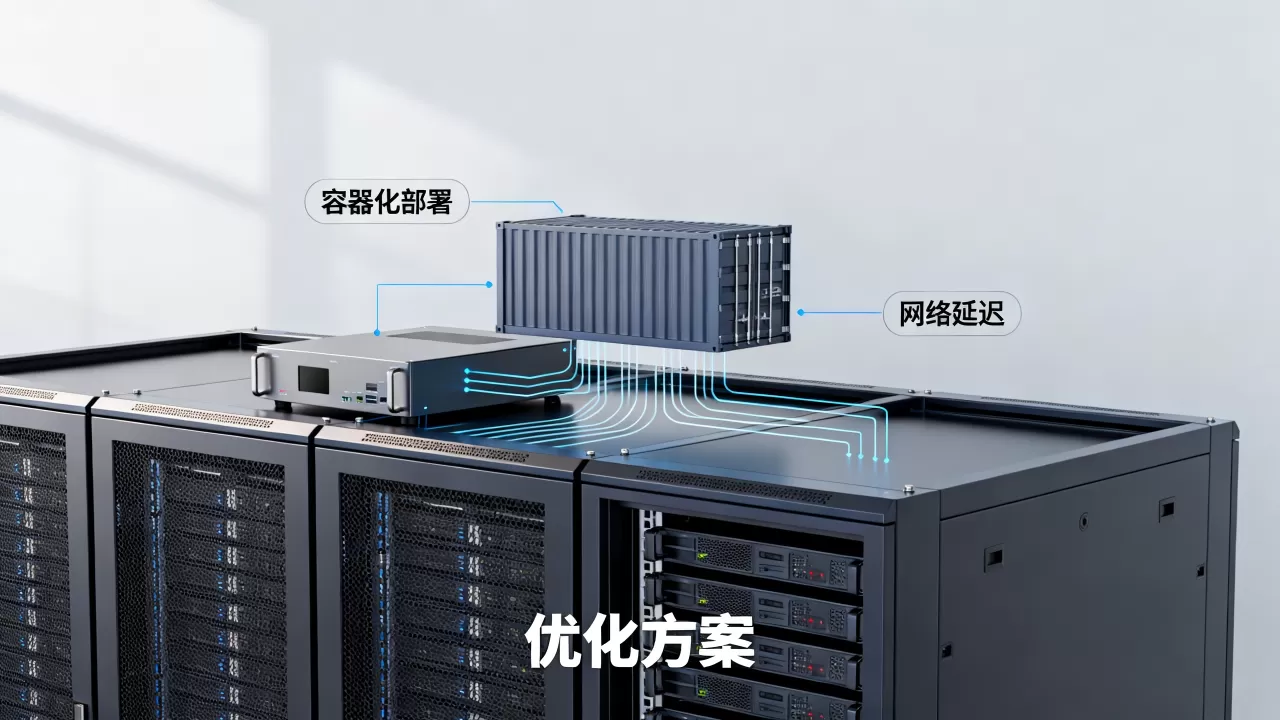
常见坑
- 容器内CPU quota设太小,交易线程被周期性节流。
- 日志驱动用json-file,且没限速,同步写盘拖慢行情处理。
- 使用默认Overlay网络,包在veth和VXLAN之间来回绕。
- 没绑核,交易Pod和其他Pod共享CPU,P99随机跳。
- 开启NUMA balancing,内存页在节点间迁移。
上海地区交易系统容器化部署延迟优化
上海是证券、期货托管重镇,低延迟机房集中在张江、金桥、外高桥等区域,容器化部署在上海本地IDC和跨城云上,延迟表现完全不同,若托管在交易所附近,裸金属Kubernetes通常比嵌套虚拟化更稳,据中国信息通信研究院,金融行业容器化率逐年上升,但延迟敏感系统仍以裸金属和物理机为主。
网络与内核调优清单
- 使用裸金属Kubernetes,避免虚拟机里再套容器。
- 交易Pod用hostNetwork,或SR-IOV/macvlan绕过Overlay。
- CPU绑核加NUMA对齐,中断亲和到非交易核。
- 关闭透明大页:
echo never > /sys/kernel/mm/transparent_hugepage/enabled。 - 设置
vm.swappiness=0、kernel.numa_balancing=0。 - 内核启动参数:
isolcpus=2-5 nohz_full=2-5 rcu_nocbs=2-5。 - 监控P99.9和最大延迟,不要只看平均值。
- 同城双活可以,但避免跨机房同步写日志。
交易系统容器化部署成本与延迟价格考量
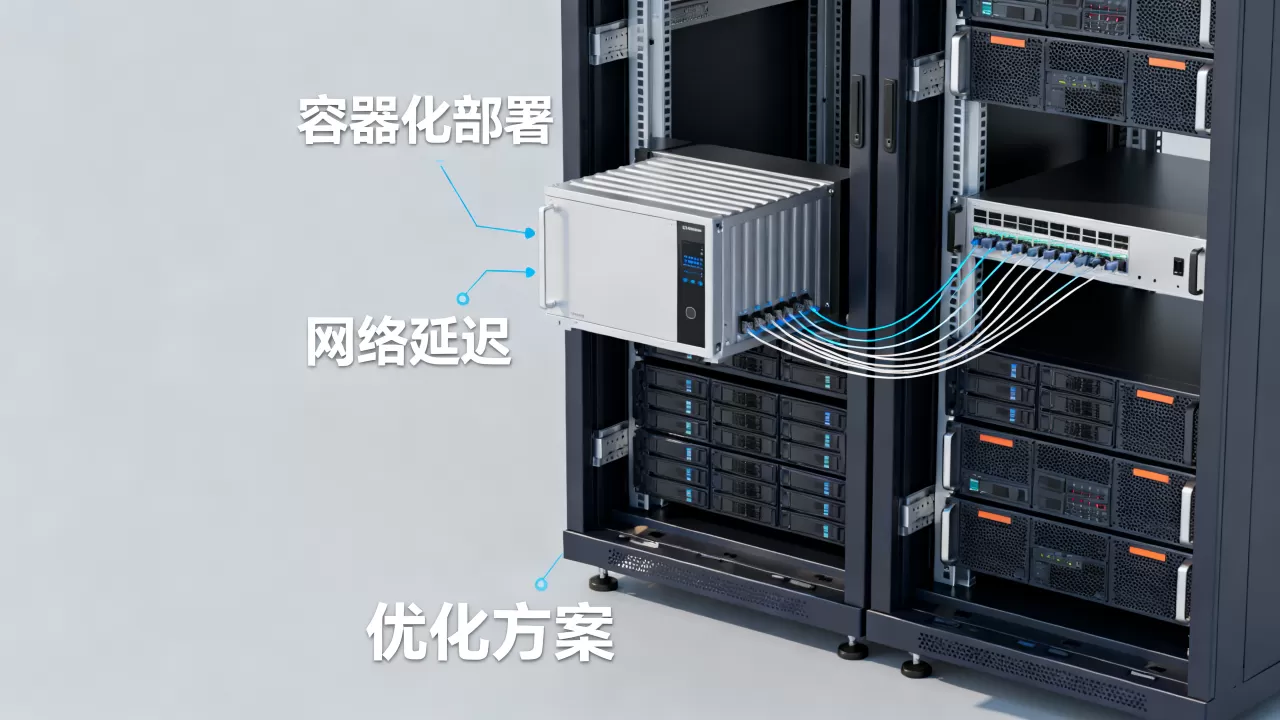
容器化本身省资源,但低延迟调优可能增加成本,业内常说的降本增效,在交易系统里往往先保延迟,再谈成本。
成本构成
- 裸金属服务器:比普通云主机贵,但省掉Hypervisor抖动。
- 低延迟交换机与专线:上海同城机房之间费用不低。
- 可观测平台:P99.9、eBPF、全链路追踪都要钱。
- 运维人力:懂内核、网络、K8s的复合型工程师不便宜。
什么时候值得多花钱换确定性延迟
- 策略收益对几微秒不敏感,但需要快速扩缩容。
- 多策略隔离,避免一个策略拖垮整台机器。
- 团队能控制内核参数,且有成熟压测流程。
什么时候不值得
- 纳秒级竞赛,FPGA和内核旁路才是主线。
- 无法独占CPU,无法关闭超线程。
- 团队没有延迟排查能力,容器化只会放大不确定性。
Q&A:交易系统容器化部署对延迟的不确定性怎么解?
容器化部署一定会增加交易延迟吗?
不一定,默认配置下,Overlay网络和cgroup限额会带来抖动,改用hostNetwork、SR-IOV、CPU静态绑核后,P50可以接近物理机,P99更依赖中断和NUMA配置。
Kubernetes的网络插件怎么选才能降低延迟抖动?
优先考虑SR-IOV CNI、macvlan、Calico eBPF并关闭iptables代理,或直接hostNetwork,避免VXLAN Overlay,检查conntrack表大小和kube-proxy模式,用ethtool -S看丢包和队列。
交易系统容器化部署后P99延迟升高,先查什么?
先查CPU节流:cat /sys/fs/cgroup/cpu.stat看nr_throttled和throttled_usec,再查网络:ss -s、ip -s link、bpftrace跟踪sendto,最后查日志:容器日志驱动是否同步写盘,核心是把变量逐个隔离,而不是直接否定容器。
交易系统容器化的延迟不确定性,本质是可控性工程,把网络、CPU、存储、内核四个面收敛,容器就能在多数交易场景里稳定跑;若策略已到纳秒级,物理机或FPGA仍是更稳妥的底座。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/763672.html