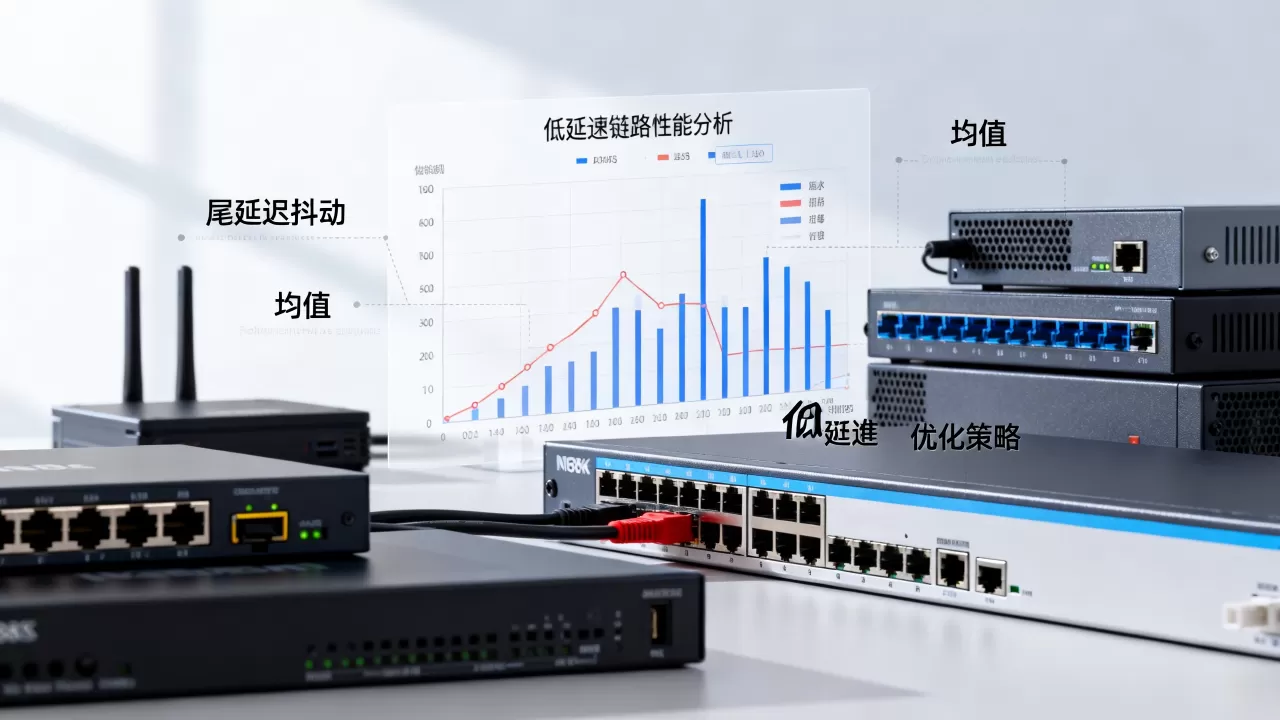
在低延迟链路里,真正决定用户体感的往往不是那条漂亮的平均延迟曲线,而是偶尔刺破上限的尾延迟抖动。 平均延迟会把最坏的那几次“卡死”稀释成岁月静好,你的游戏技能放不出去、直播画面突然凝固、语音对方听不清,几乎都是尾延迟在捣乱,要根治体验问题,抓尾巴比看均值有用得多。
游戏延迟高怎么解决?先看尾延迟,而不是平均值
很多玩家遇到过这种情况:游戏内延迟显示只有几十毫秒,团战开大的瞬间却卡住不动,等画面恢复人已经躺了,查后台监控,所有指标都“正常”,机房也说链路没问题,问题恰恰出在统计口径上延迟平均值好看,不代表每一秒都好受。
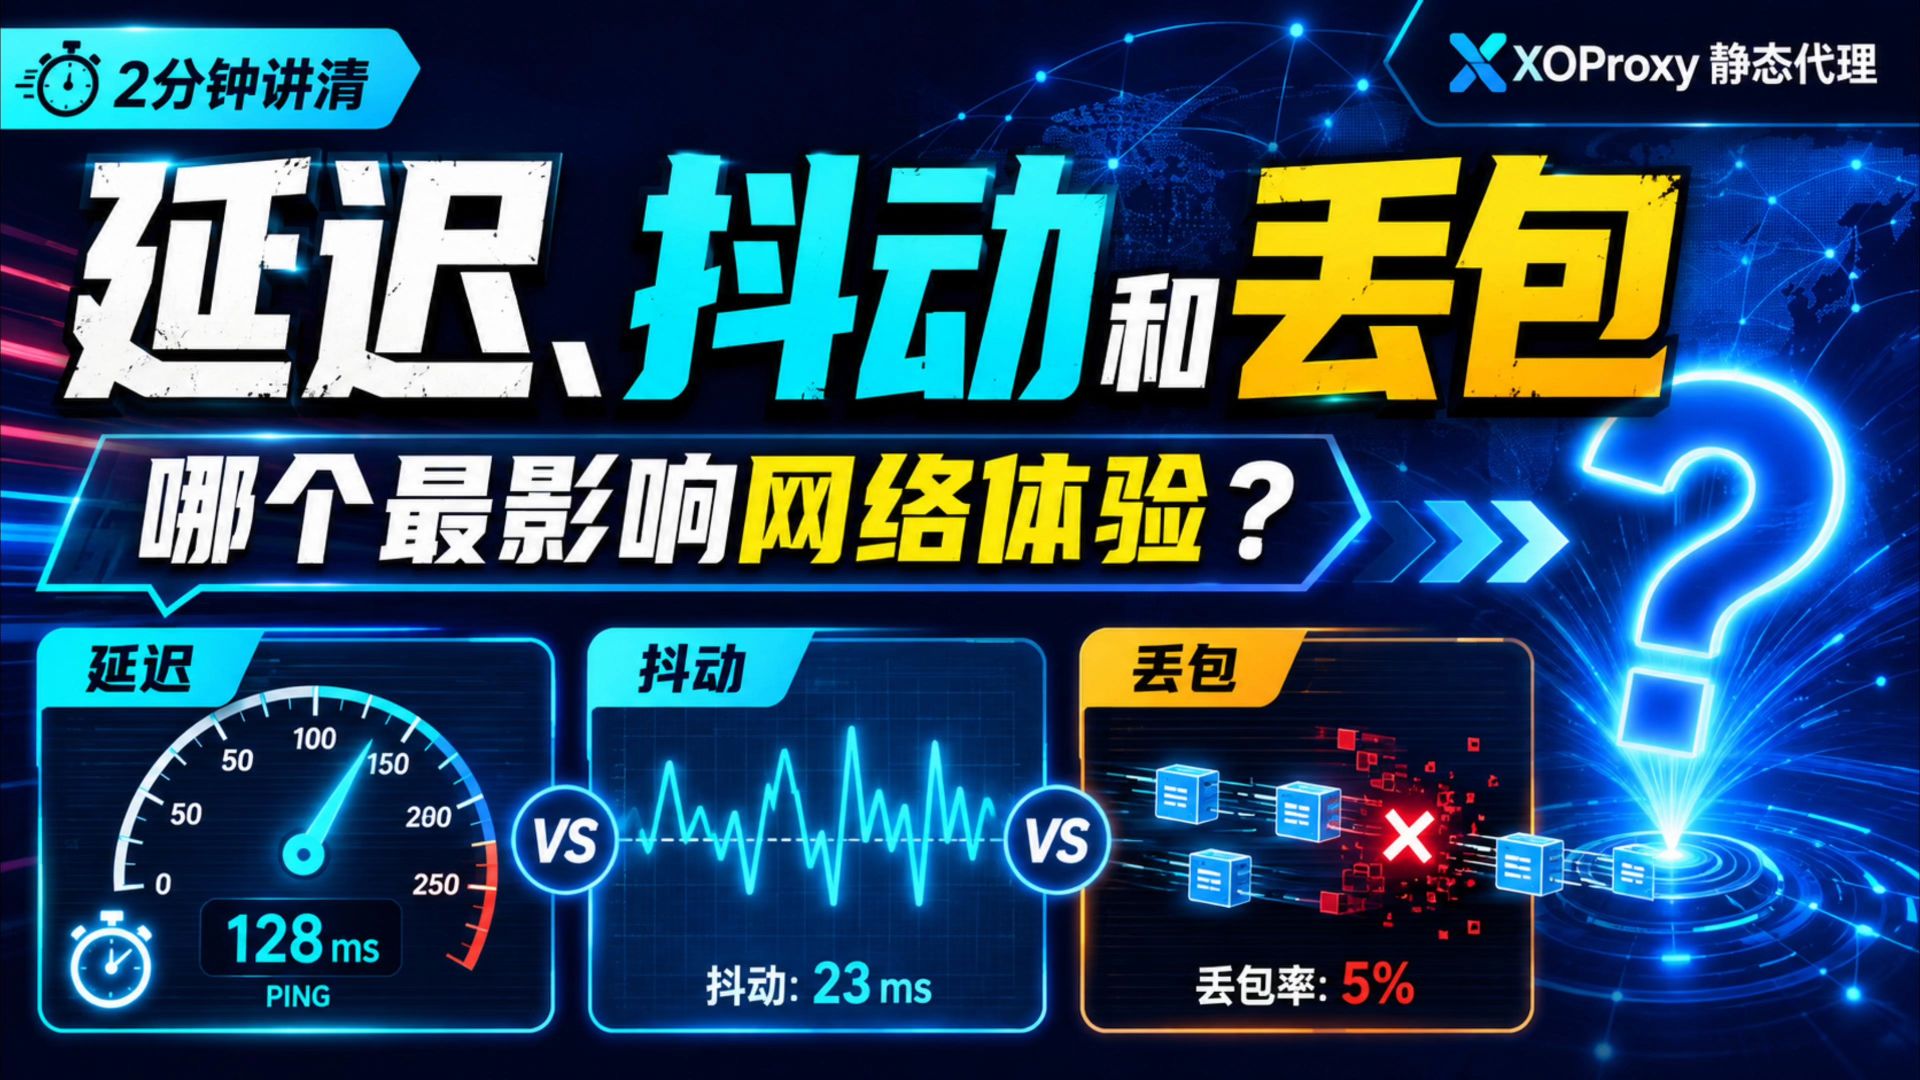

假设一条链路九成时间非常稳定,剩下偶尔几次毛刺突然冲到几百毫秒,平均数值依然漂亮,但游戏交互吃的是每一帧的即时反馈,那几次毛刺恰好落在关键操作上,体验就直接崩塌。这就是尾延迟的典型特征:次数少、影响大、隐藏深。
延迟数据天生是长尾分布,不可能所有请求都均匀排队,网络转发受路由器缓冲、运营商路由切换、无线信道干扰等多重因素影响,总会出现延迟远高于中位数的情况,平均值把这些毛刺分摊进所有请求里,相当于把少数人的痛苦平均给了所有人。真正的用户只关心自己最倒霉的那几毫秒。
衡量链路真实质量,常见做法是看分位值。p50代表顺滑时的典型手感,p99甚至p999才代表最坏情况是否可控,很多运维把注意力全放在平均值波动上,链路明明尾延迟已经失控,图表却呈现一条平缓直线,p99持续走高,才是需要警惕的时刻。
网络抖动测试方法:30分钟把尾延迟毛刺揪出来
想验证链路尾延迟是否异常,不需要高大上的监控系统,一台笔记本、一段命令行就能摸清底细,以下步骤可以直接照抄。
- 第一步:连续ping测试,命令格式
ping -f 目标IP,在Linux或Windows下都可以执行,发送大量ICMP包观察响应时间分布,重点不是平均延迟,而是看最大响应时间和响应时间离散度
,偶尔冒出一两个超高的响应时间,就是尾延迟毛刺的直接证据。
- 第二步:MTR分段探测,Linux执行
mtr -rw 目标IP,Windows可以选WinMTR图形版,它能把数据包路径上的每一跳延迟和丢包率都打出来,快速定位是家里路由器问题、运营商骨干网问题还是目标服务器问题,哪一跳的异常值明显增多,嫌疑就在哪一段。 - 第三步:抓包验证重传,计算机网络协议里TCP重传率最能说明链路质量,用Wireshark在发送端抓包,过滤
tcp.analysis.retransmission,统计重传包数量和时间间隔。如果重传集中出现在某个时间段,说明当时网络队列已经堆积到极限,这就是尾延迟的实体证据。
测试时要注意一个细节:ping通的ICMP包和服务端实际业务包走的优先级未必一样,有些网络设备给ICMP的带宽限额很低,导致ping测出的抖动很夸张,但真实业务反而不卡。更可靠的办法是用业务流量本身做验证。 比如游戏本地跑一局后导出网络日志,直播推流时同时抓流媒体包,拿真实协议数据算延迟分位,比单纯ping有说服力得多。
链路压测数据怎么看
跑完一条测试链路,同样一组原始数据,两种视角会得出完全相反的结论,示例如下:
| 统计口径 | 常规延迟视角 | 尾延迟视角 |
|---|---|---|
| 平均值 | 数据平稳,没有明显劣化 | 平均水平被少数高峰拉低,看似正常 |
| 最大值 | 偶发高延迟,但次数少,忽略 | 每一次高延迟都可能对应一次用户可见卡顿 |
| 丢包率 | 很低,没有触发报警阈值 | 低丢包率不等于无抖动,重传时延才是真实代价 |
数据本身不会说谎,但指标选错了,结论就完全跑偏,判断链路品质,优先看最大延迟、p99延迟、TCP重传延迟这几项,而不是盯着平均值变化。
直播推流延迟多少算正常?尾延迟才是画面卡顿的真凶
直播场景对延迟的敏感度比游戏更复杂,既要保证实时性又要保证画面流畅,很多人问直播推流延迟多少算正常,业界普遍认可的范围是

端到端延迟在2到5秒之间,具体取决于协议和缓冲策略,更大的问题在于,延迟波动时画面出现卡顿、花屏、音画不同步,而这些状况通常不是平均延迟超标造成的,是某一段路径上尾延迟激增,导致解码器来不及处理数据。
推流链路一般要经过采集端编码、上行网络、CDN分发、下行播放这四段,任何一段出现几十毫秒的突发抖动,对端到端延迟的绝对值影响有限,却足以让播放器缓冲耗尽、进入“转圈”状态。直播追求的不只是延迟低,更是延迟要稳。 稳定性比绝对值更能决定观看体验。
直播链路尾延迟的三处常见病灶
- 客户端上行拥塞,推流端Wi-Fi信号波动时,路由器无线队列迅速堆积,视频帧在空气里排队,一下把传输延迟从几十毫秒抬到几百毫秒,编码器可能因此判断网络拥塞,主动降码率,画面随之模糊。
- CDN边缘节点排队,大量用户同时访问同一节点时,转发队列变长,数据包处理时间跟着拉长,CDN节点状态你控制不了,但可以用多路CDN调度来分散风险。
- 播放器缓冲策略过于激进,缓冲太小,遇到一次尾延迟抖动就直接卡住;缓冲太大,实时性又被牺牲。合理做法是保留少量抗抖动缓冲,同时用客户端预测算法平滑延迟波动。
直播服务商和推流工具减少卡顿的手段,几乎都绕不开尾延迟治理,选择合适的传输协议、降低GOP长度、动态调整编码码率,都是在为链路的“坏脾气”留出缓冲地带。
把尾延迟压下去:给链路脾气立规矩
低延迟链路的优化方向不是让平均值更低,而是把最坏的那几次延迟按回去,落实到操作层面,场景不同,治理手段差别很大。
游戏场景优先处理本地路由器,启用路由器主动队列管理(AQM)功能,比如家宽路由器里的SQM(智能队列管理)或QoS限速,都能主动丢弃堆积数据包,防止缓冲膨胀导致延迟雪崩。遇到夜间高峰期游戏卡顿加重,宽带出口排队是主要原因,光靠换加速器解决不了根本问题,先检查路由器的SQM是否开启。
对比方案时,游戏加速器确实能减少跨地区路由绕行,但它的核心价值不在降低平均延迟,而在降低尾延迟毛刺的频率,使用加速器之前先用MTR对照观察一段时间,没对比就掏钱很容易白花。
直播推流场景优化重点调整编码发送策略,推流软件里把缓冲时间从“自动”改成手动,预留500毫秒到1秒的缓冲余量,相当于给链路抖动准备了安全垫,画面偶尔轻微延迟,但换来了稳定不中断。行业共识认为,适当增大缓冲是牺牲少量实时性换取稳定性的最直接手段。
企业级专线场景侧重点又不同,普通互联网线路高峰期拥堵时,路由路径动态变化频繁,尾延迟失控难以预测,专线走固定路由,转发路径稳定,能从根本上压缩抖动范围,选择专线服务时,除了对比北京到上海这类跨地域线路的平均延迟,更要看服务商提供的延迟分位保障协议,数值越接近p999越好,价格方面,企业专线的价值在于把不确定的抖动变成确定的成本,预算充足的前提下优先考虑有SLA兜底的服务。
关于尾延迟抖动的常见转折点
为什么游戏里延迟不高却总是关键时刻卡一下?
因为“延迟不高”说的是平均值,关键时刻卡一下是尾延迟波动,p50正常不代表p99正常,高延迟请求极少,但每出现一次都可能恰好落在关键帧上,排查思路是拉长时间窗口看延迟最高值出现的频率和时刻,如果高延迟集中在某一时间段或某一跳路由,从对应路径下手处理。
网络抖动测试方法里,ping和MTR哪个更靠谱?
ping适合快速摸一遍基线水平,MTR适合定位丢包和延迟出现在哪一跳,两端配合使用价值最高:先用ping确认异常是否真实存在,再用MTR锁定具体链路节点,最后用抓包验证TCP重传情况,三层证据齐全后,尾延迟抖动基本无处遁形。
低延迟链路的本质是让每一次转发都稳定可控,平均值只是面上的繁荣,尾延迟才是里子,下次看到链路监控数据飘绿时,多问一句:p99是多少,最大延迟出现在什么时候这才是把体验握在手里的真正做法。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/763834.html