一台服务器做热备,核心思路不是再搞一台机器,而是把磁盘、系统、应用三层分别做冗余,让硬件故障时业务能自己扛住。单机热备的目标不是双机热备那种秒级切换,而是用最低成本把单点故障风险压到最低,这件事很多中小型公司都做得不够踏实。
一台服务器怎么做热备?先拆解“热备”的真实含义
一台服务器怎么做热备,这个问题很多人一上来就想到双机热备、VIP漂移,其实跑偏了,所谓“备”,本质是让服务器的某个部件失效时不至于全盘崩溃,单机热备的可行路径主要有三条:
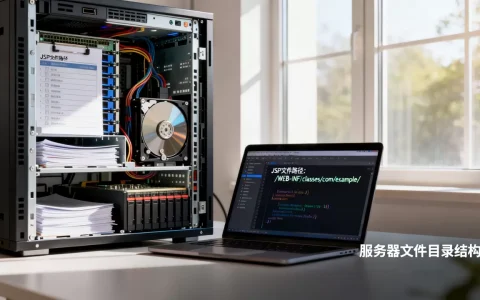
- 磁盘层热备:通过RAID阵列实现硬盘冗余,一块盘挂了业务不中断。
- 系统层热备:用LVM快照或文件系统镜像,实现系统级回滚和快速恢复。
- 应用层热备:用守护进程或双机软件让应用自动拉起,缩短故障恢复时间。
行业共识认为,单机热备能解决的故障比例高达七成以上,因为一台物理服务器最常见的故障就是硬盘损坏、系统崩溃、进程卡死,这三层机制恰好覆盖这些场景。
服务器热备搭建方案:三层冗余,从硬盘到应用逐层做
既然一台服务器做热备,就要把“备”这件事落到具体的层,不要指望一个方案管全部,按下面三层去做,才是正经的服务器热备搭建方案。
第一层:磁盘RAID热备盘
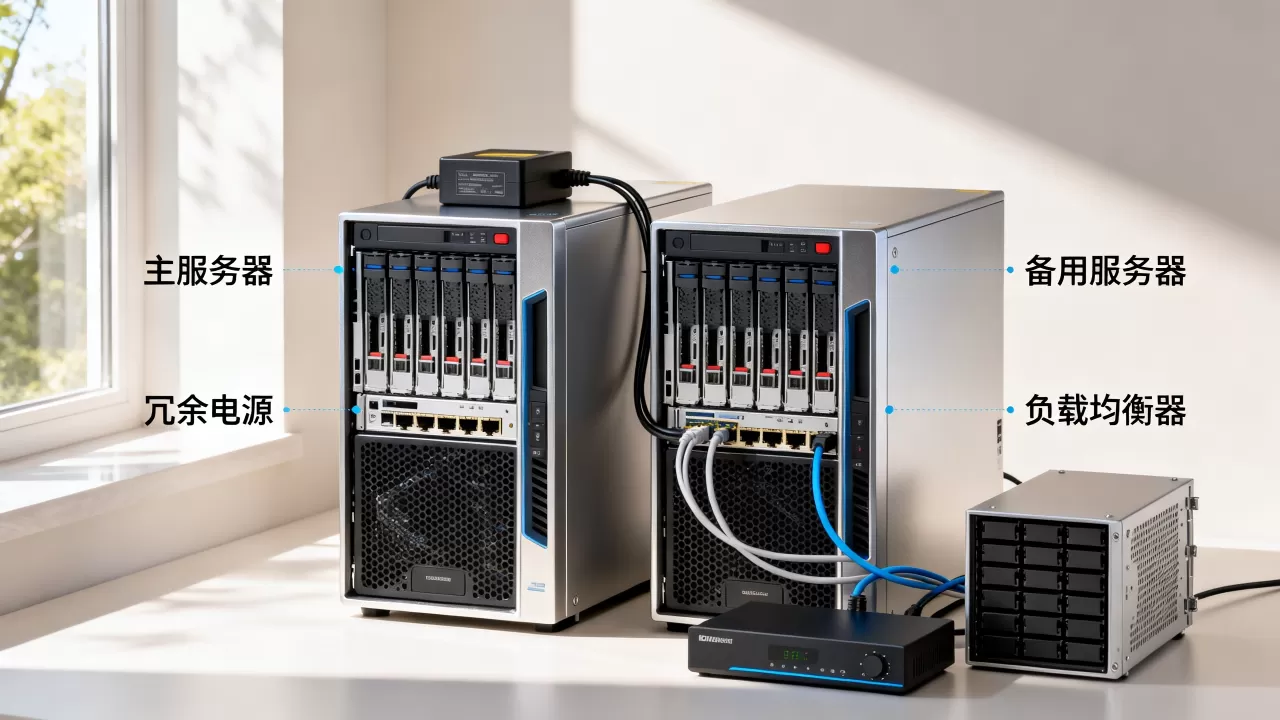
这是单机热备最硬核的一层,买服务器时选支持热插拔的硬盘托架,配置RAID时留一块全局热备盘(Hot Spare),一旦阵列里某块盘报警,热备盘会在几分钟内自动顶替上去。
实操路径:
- 开机进RAID卡配置界面(一般是
Ctrl+R或Ctrl+H)。 - 创建RAID 1或RAID 5阵列,不要把所有磁盘全部用完。
- 设置全球热备盘(Global Hot Spare),勾选允许重建到热备盘。
- 开启巡检周期,让RAID卡定期扫盘,发现坏道提前报警。
需要留意的是,RAID不是备份,RAID 1可以坏一块盘,但如果是文件被误删、系统中毒,RAID完全没用,这块兜底还需要靠第二层。
第二层:系统层LVM镜像与快照
系统层热备的重点是让系统盘具备“后悔药”能力,LVM(逻辑卷管理)是Linux环境下的老牌方案,它的核心价值在于一条命令就能生成快照。
操作要点:
- 装系统时用LVM分区,挂载点挂在
/dev/vg00/lv_root这样的逻辑卷上。 - 定期执行
lvcreate -L 10G -s -n snap_root /dev/vg00/lv_root生成快照。 - 快照会占额外空间,建议给快照预留逻辑卷总容量的15%-20%。
- 系统升级前打一次快照,升级挂了就直接
lvconvert --merge回滚。
这套做法不需要额外硬件,只要在装系统时动一下脑筋,很多云服务器默认就用LVM,但绝大多数人装完就不管了,白瞎了这个热备能力。
第三层:应用层守护进程和主备切换脚本
应用层热备解决的是“服务静默宕机”问题,进程没退出,但端口不响应,这种故障最阴,用systemd写一个守护单元,加上健康检查脚本,每30秒发一次探测请求,连续三次没响应就自动重启服务。
一个简单可验证的做法:
- 编写
/etc/systemd/system/app-check.service服务文件。 - 在
ExecStart里指向一个/opt/check.sh脚本,脚本内用curl -f http://127.0.0.1:8080/health做探活。 - 设置
Restart=always和RestartSec=30。 - 用
systemctl enable app-check.service开机自启。
这套机制跑起来以后,一台服务器做热备才算是真正闭环:硬盘挂了有热备盘顶,系统坏了有快照回滚,应用死了有守护程序拉活,三层各管一段,谁也替代不了谁。
单机热备和双机热备怎么选?看预算更看业务容忍度
很多人会把“两台服务器做集群”和“一台服务器做热备”搞混,单机热备和双机热备的选择,本质上是在问:业务允许停机多久?
| 对比维度 | 单机热备 | 双机热备 |
|---|---|---|
| 硬件成本 | 一块热备盘成本极低 | 需要两台同等配置服务器 |
| 故障切换时间 | 分钟级(依赖自动重建) | 秒级(VIP漂移) |
| 运维复杂度 | 较低,日常看SMART和RAID日志 | 较高,需要维护心跳网络和共享存储 |
| 覆盖故障类型 | 硬盘坏、系统崩溃、应用卡死 | 整机断电、网络故障、主板烧毁 |
| 适合场景 | 单机房单台物理机的低成本高可用 | 核心业务、对外数据库、支付接口 |
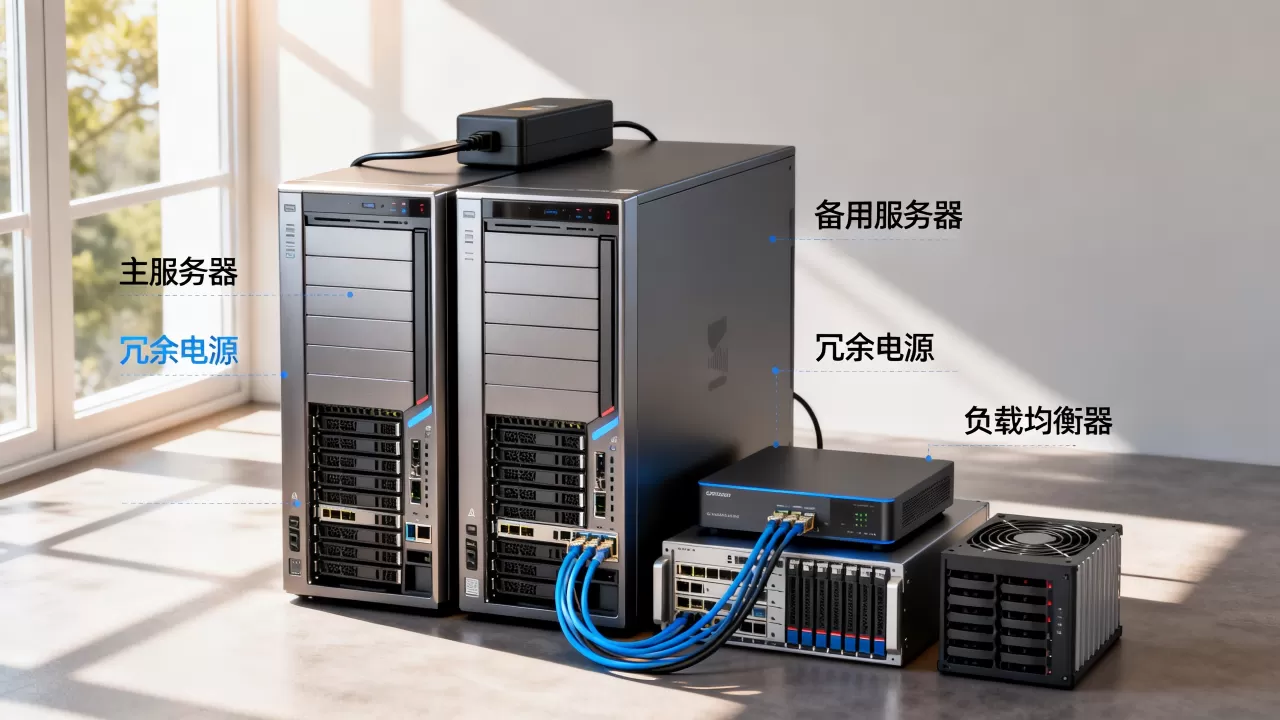
单机热备适合预算敏感、业务数据量不大且对分钟级恢复可接受的场景,双机热备适合财神爷系统比如交易接口、用户认证中心,这类服务宕机一分钟都是事故。
业内专家指出,大约六成以上的中小型网站其实根本用不上双机热备,单机热备加定期异地备份,完全能把可用性稳在99.5%以上,关键是别用错了地方。
热备和容灾的区别,别把概念做成夹生饭
单机热备容易被人拿来和容灾混着说,热备和容灾其实是两个不同维度的事:
- 热备是硬件或软件层面的冗余,解决的是“还能不能用”的问题。
- 容灾是数据副本的异地存放,解决的是“机房没了怎么办”的问题。
- 热备的“备”和备份是两个概念,前者是实时的,后者是定时或周期性的。
一台服务器怎么做热备,做完了也只是一个单点上的防护,如果整个机房断电、遭遇火灾,这台服务器再热备也救不回来,所以成熟的方案是:单机热备负责日常高可用,定期异地备份负责极端灾难恢复。
有条件的可以把数据备份到对象存储(比如简米云OSS、酷番云COS),或者在另一台便宜的云主机上跑个rsync定时同步,成本每个月几十块钱,这套组合拳下来,一台物理机的风险敞口才算基本封住。
一台服务器怎么做热备:实操中的几个关键坑
纸上谈兵容易,真正动手做单机热备时,有几个坑特别容易踩。
RAID卡缓存和电池是热备的命门
没有电池或电容保护的RAID卡,写缓存一开,断电就丢数据,配置RAID时,务必确认RAID卡带BBU(电池备份单元)或闪存电容,否则老老实实关掉写缓存,拿性能换安全。
热备盘别选比阵列盘容量小的
这个错误很多人犯,热备盘容量必须大于等于阵列里最小盘容量,否则RAID控制器会拒绝把热备盘加入重建队列,买盘时最好留出20GB以上的容量余量。
快照不是越勤越好
LVM快照越密集,系统IO开销越大,核心逻辑卷一天打两次快照就够,太频繁会让正常业务写入性能明显下降,保留两个快照版本就行,旧的定期删掉,否则快照元数据增长到极限反而把卷锁死。
守护脚本必须自己测过
写好的check.sh要手动跑一遍,故意kill掉服务端口观察能不能自动拉起,很多人的脚本第一版就有路径写错、变量未定义的问题,到真正出故障时才暴露,那就晚了。
Q&A
一台服务器做热备需要再买一块硬盘吗?
需要,如果是RAID 1阵列,本来就要两块盘,再加一块热备盘就是三块盘起步,如果已经是RAID 5阵列,加一块容量相当的热备盘是必须的,否则阵列缺少冗余支撑,任一块盘再坏就直接数据全丢,这是单机磁盘热备的基本前提。
服务器热备搭建方案里,RAID 1和RAID 5哪个更合适?
看磁盘数量和数据重要程度,RAID 1的写入性能稍弱但安全性高,适合系统盘;RAID 5在拥有4块盘以上时才划算,空间利用率更高,适合数据盘存放业务数据,如果只有两块盘,那就没得选,只能是RAID 1,无论哪种方案,热备盘都建议配置一块。
单机热备能避免硬件损坏吗?
不能,热备机制做的是故障发生后自动接管的活,不是预防硬件坏掉,硬盘的SMART信息、RAID控制器的日志,只是让管理员能提前发现隐患,真正避免硬件损坏的办法只有定期巡检、控温、防尘,以及给服务器装上UPS供电保护,单机热备的价值在于坏了不慌,而不是让硬件长寿。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/764206.html