期权组合保证金实时计算吃掉的算力,通常不是“整台服务器”级别,而是取决于组合数量、重算频率和情景维度;在多数券商和私募场景里,它更像一只持续占用几个到几十个CPU核心的“电老虎”,而不是瞬间烧穿机房的黑洞。
期权组合保证金实时计算需要多大算力?拆开计算链路看
别急着买服务器,先搞清楚你的保证金引擎到底在算什么,期权组合保证金不是简单把每个持仓的保证金加起来,它要把同一账户下的期权、期货、现货按策略组合,再跑情景分析、压力测试和希腊值汇总,实时计算意味着行情一跳、成交一笔,就要重新算一遍。
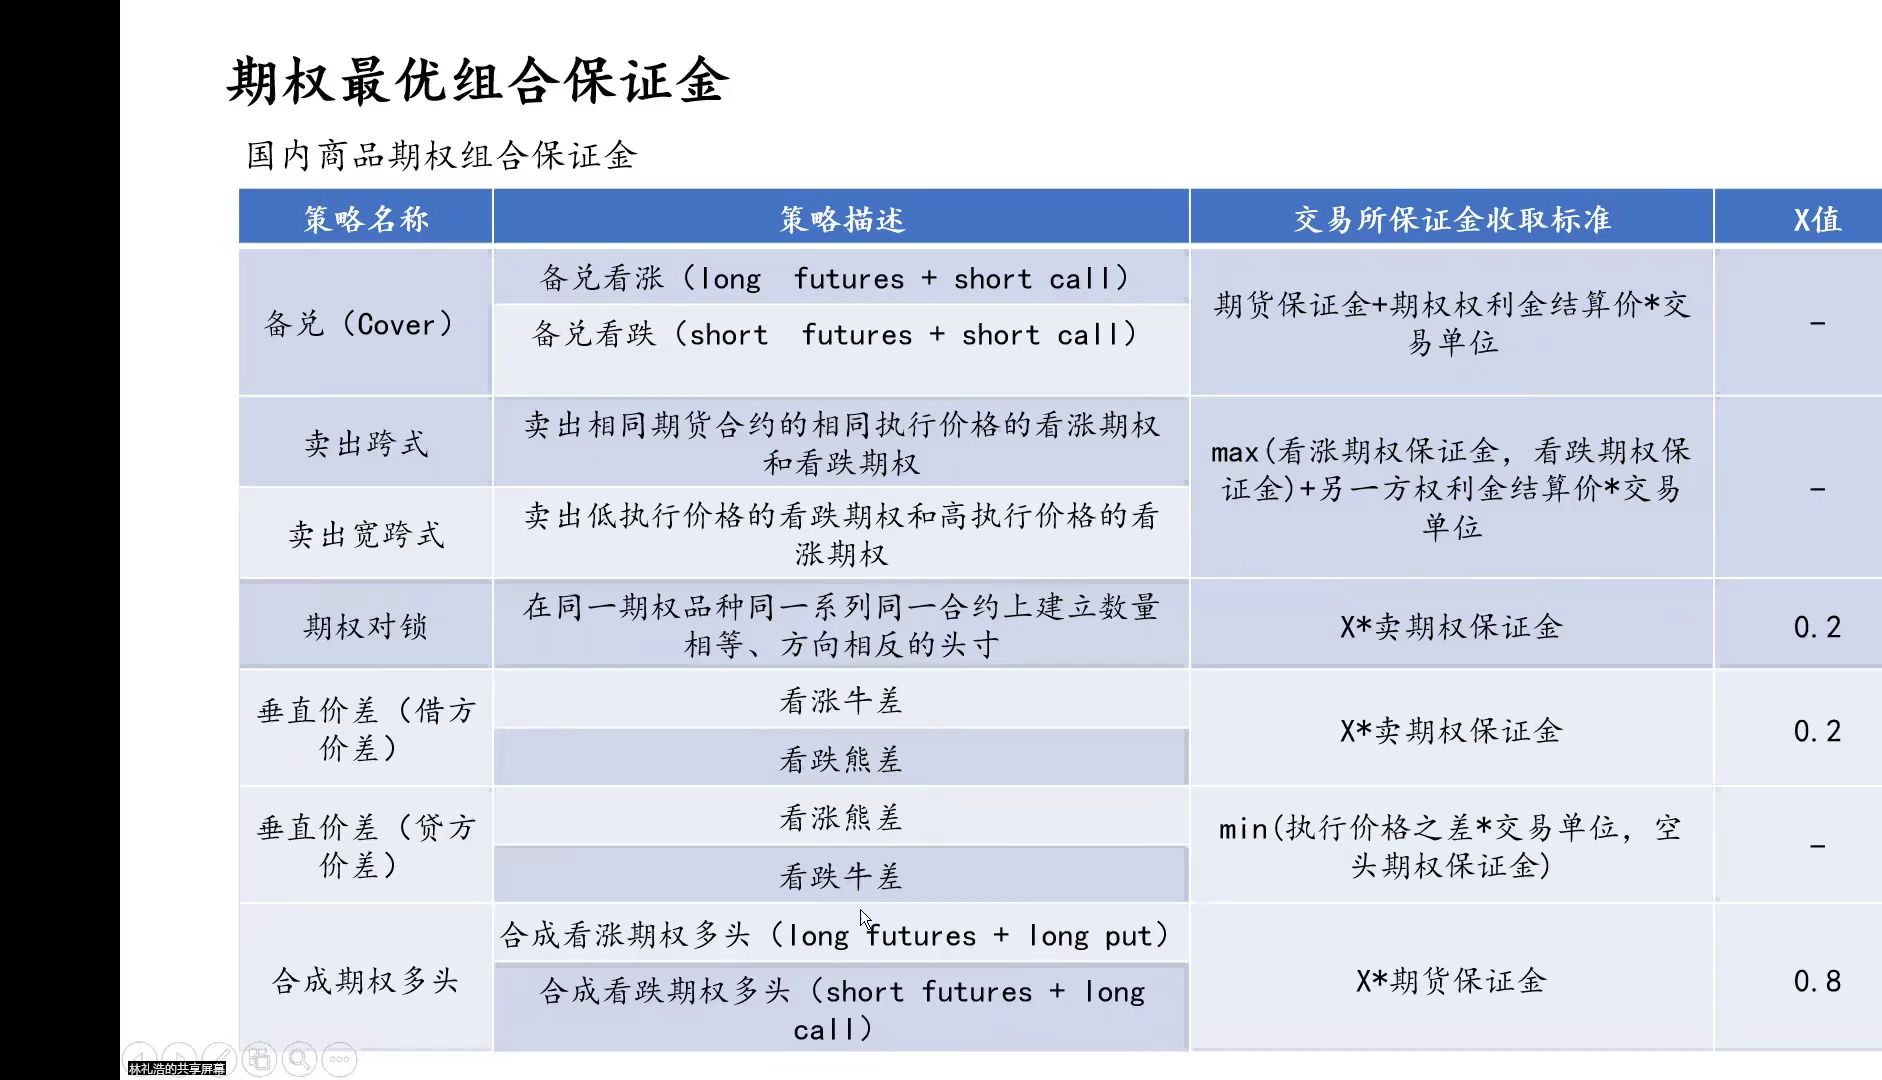

计算对象:组合、情景、希腊值
- 组合拆分:一个账户可能持有数百个期权合约,两两组合、多腿组合的数量会快速膨胀。
- 情景分析:每个组合要跑多组标的價格变动、波动率变动、时间衰减情景,情景越多,算力越陡。
- 希腊值汇总:Delta、Gamma、Vega、Theta、Rho 需要实时更新,尤其 Gamma 和 Vega 对波动率曲面变化敏感。
- 保证金规则:交易所或券商自研的保证金模型不同,SPAN、TIMS、VaR 类模型的计算量差异很大。
触发频率:行情、成交、风控阈值
实时计算最怕“高频触发”,行情每 500 毫秒推送一次,和每 3 秒推送一次,CPU 占用完全不同,成交回报、撤单、风控阈值越界也会触发重算。
| 计算模式 | 触发方式 | 算力特征 | 典型硬件 |
|---|---|---|---|
| 批量计算 | 日终或定时 | 平缓、可排队 | 通用多核服务器 |
| 准实时计算 | 分钟级快照 | 短时脉冲 | 多核CPU+大内存 |
| 实时计算 | 行情/成交驱动 | 持续占用、峰值明显 | 低延迟CPU、NUMA优化 |
相当一部分团队低估了触发频率的影响。
单次计算只要几毫秒,但每秒触发上千次,CPU 就会被吃满。
期权组合保证金实时计算和盘中风控哪个更吃CPU?对比三个维度
这个问题在券商技术选型时经常被讨论,盘中风控通常检查资金、持仓、限额,逻辑相对固定;保证金实时计算则涉及非线性组合优化和情景矩阵运算,谁更吃 CPU,要看下面三个维度。
计算复杂度
盘中风控多是规则判断和阈值比较,复杂度接近线性,保证金实时计算要遍历组合树,跑情景矩阵,复杂度随组合数和情景数呈近似指数或高阶增长。业内专家指出,期权组合保证金的实时计算瓶颈往往不在单次定价,而在高频触发下的重复计算。
数据吞吐
盘中风控读取账户、持仓、行情快照,数据量可控,保证金实时计算需要全量持仓、希腊值、波动率曲面、相关性矩阵,内存带宽和缓存命中率会直接决定 CPU 等待时间。
延迟要求
盘中风控可以容忍毫秒到秒级延迟,保证金实时计算在低延迟交易场景下,往往要求微秒到毫秒级返回,延迟要求越苛刻,越不能用重试和排队掩盖算力不足。
行业共识认为,延迟敏感型策略应将保证金引擎与行情网关部署在同一低延迟网络内。 跨机房调用会增加不可控抖动。
高频交易场景下期权组合保证金实时计算算力消耗
高频场景下,行情更新极快,组合保证金需要跟着行情滚动重算,这时候算力消耗不是线性增长,而是脉冲式爆发。
单账户的算力账单
一个活跃的期权账户,持有几十到几百个合约,组合数可能达到数千个,每个组合跑几十个情景,每个情景做一次定价和希腊值计算,单核可以处理一定规模的增量重算,但全量情景扫描会迅速占满多个核心。
- 增量计算:只重算受行情影响的组合,CPU 占用低,但实现复杂。
- 全量计算:每次行情更新重算所有组合,CPU 占用高,但逻辑简单。
- 混合模式:行情变动小的组合跳过,变动大的组合重算,兼顾延迟和算力。
多账户并行与分布式
单机扛不住时,自然想到分布式,但保证金计算有账户级状态,不能随便拆,常见做法是按账户哈希分片,每个分片独立计算,再汇总风控指标。
- 分片键:账户ID或组合ID,保证同一账户的计算在同一个进程内。
- 状态同步:行情和持仓变动通过消息队列广播,避免锁竞争。
- 结果汇总:保证金结果写入内存数据库,供风控和订单系统查询。
实操:三步测出真实开销
- 用
pidstat -p <pid> 1观察 CPU 使用率,确认是用户态还是内核态吃满。 - 用
perf top -p $(pgrep -f margin_engine)找热点函数,看是定价、组合遍历还是内存分配。 - 用
py-spy top --pid <pid>或async-profiler生成火焰图,定位重复计算和锁竞争。
如果热点在定价函数,考虑缓存希腊值;如果热点在内存分配,考虑对象池;如果热点在锁,考虑无锁队列或分片。
上海期权组合保证金实时计算延迟优化与服务器价格参考
上海是期权交易和托管的重要地点,上海证券交易所、上海期货交易所周边机房,以及张江、金桥等区域的托管服务,都是低延迟部署的常见选择。
托管位置与网络延迟
上海本地托管到交易所的往返延迟通常能做到微秒级,跨地域则上升到毫秒级,对于期权组合保证金实时计算,网络延迟不是最大瓶颈,但跨机房调用会放大抖动。
- 同机房部署:行情、交易、保证金引擎在同一机架或同一可用区。
- 交换机优化:使用低延迟交换机,开启 PTP 或硬件时间戳。
- 冗余路径:避免单点网络故障导致重算中断。
硬件选型与价格区间
硬件选型看三个指标:单核性能、内存带宽、NUMA 架构。
- CPU:高主频、大缓存、支持 AVX-512 的服务器 CPU 更适合情景矩阵运算。
- 内存:DDR5 高频内存,容量要能放下全量持仓和波动率曲面。
- 网络:低延迟网卡,支持内核绕过和 SR-IOV。
价格方面,公有云按核时计费,短期测试灵活;长期高频生产环境,物理机托管或专有云在延迟和成本上更有优势,具体价格随 CPU 核数、内存和托管位置变化较大,物理机托管通常比同核数公有云实例更可控。
优化命令与操作路径
- 绑定 CPU 核心:
taskset -c 2-5 ./margin_engine - 绑定 NUMA 节点:
numactl --cpunodebind=0 --membind=0 ./margin_engine - 关闭透明大页:
echo never > /sys/kernel/mm/transparent_hugepage/enabled - 调整进程优先级:
chrt -f 80 ./margin_engine - 监控上下文切换:
pidstat -w -p <pid> 1
这些操作能减少调度抖动和内存访问延迟,让实时计算更稳定。
期权组合保证金实时计算会吃掉多少算力?常见问题解答
期权组合保证金实时计算一定要上GPU吗?
多数情况下不需要,GPU 适合大规模蒙特卡洛和批量情景模拟,但实时计算往往是小批量、高频率、低延迟,GPU 的内核启动和 PCIe 传输开销,可能比 CPU 多核并行更慢,只有当情景数量极大、组合规模极广时,GPU 才有明显优势。
期权组合保证金实时计算在云上跑成本比物理机低吗?
短期测试和弹性扩容,云更有优势,长期高频生产环境,物理机托管或专有云在延迟和成本上更可控,云实例的邻居噪声和虚拟化开销,对微秒级延迟不友好。
期权组合保证金实时计算和批量计算算力差距有多大?
批量计算可以按日终调度,算力需求平缓,允许排队和重试,实时计算受行情驱动,峰值算力需求可能是批量的数倍,且必须预留冗余,实时计算引擎必须为峰值行情预留冗余,否则行情抖动时,保证金重算会挤占订单处理线程。
期权组合保证金实时计算的算力消耗,本质是“组合数×情景数×触发频率”的乘积,控制住这三个变量,算力就不会失控。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/765174.html