在交易链路中,低延迟网卡与内核旁路技术是突破操作系统网络栈瓶颈的核心手段,其落地场景主要集中在行情转发、极速交易柜台与高频做市三类系统中,能有效降低单笔交易的全链路时延。
交易链路为什么非得逼着网卡“绕道走”
传统Linux内核协议栈处理网络数据包时,需要经历中断通知、软中断调度、数据拷贝、系统调用等层层关卡,每一次收发包,CPU都要花费数千个时钟周期在上下文切换上,对于交易链路而言,行情数据快照每秒刷新数十次,订单状态确认以微秒计,任何一次内核态与用户态来回切换造成的抖动,都可能让策略执行错过最佳价位。
制约因素不止“慢”,还有“不确定”,更致命的是尾延迟,即使平均延迟看起来很理想,内核调度的一点点随机性就会让单笔极端延迟远高于平均值,据行业共识,引入内核旁路技术后,处理网络包的系统调用开销几乎清零,抖动水平大幅收敛,金融行业最关心的不是“快一点点”,而是“每一笔都稳定地快”。
低延迟网卡与内核旁路本质上是一套“软硬配合”的解决方案,网卡硬件负责将数据直接送入用户态内存,软件框架则绕开内核协议栈,让应用程序通过轮询模式而非中断模式收取数据,近年来的实践表明,这套方案可将纯网络接收路径的时延从数十微秒级别压缩到数微秒以内,并且能支撑更高的每秒处理报文数。
低延迟网卡怎么选:看透硬件层面的真实差距
选择低延迟网卡,首先需要判断网络接口卡的工作模式,普通网卡依赖CPU完成校验和计算、分片重组等任务,低延迟网卡则将L2/L3处理能力下沉到硬件,部分高端型号甚至支持可编程的流表匹配规则,在网卡层面就将行情数据过滤分发,大幅度减少CPU负载。
关键指标拆解
- 硬件时间戳:支持PTP精确时间同步的网卡,能在报文进入物理层即刻打上纳秒级时间戳,这是计算交易时延分段的必备功能。
- PCIe通道与DMA能力:PCIe 3.0 x8以上通道能够提供足够的双向带宽,DMA Burst大小直接决定一次数据搬运的效率,该配置在驱动中可调。
- 多队列支持:低延迟场景多采用RSS或Flow Director将不同业务的流量队列隔离,确保行情流和订单流互不抢占处理资源。
- CPU Affinity:将网卡中断或轮询线程绑定在特定物理核心上,避免缓存抖动,此项常规调优操作能带来明显延迟收益。
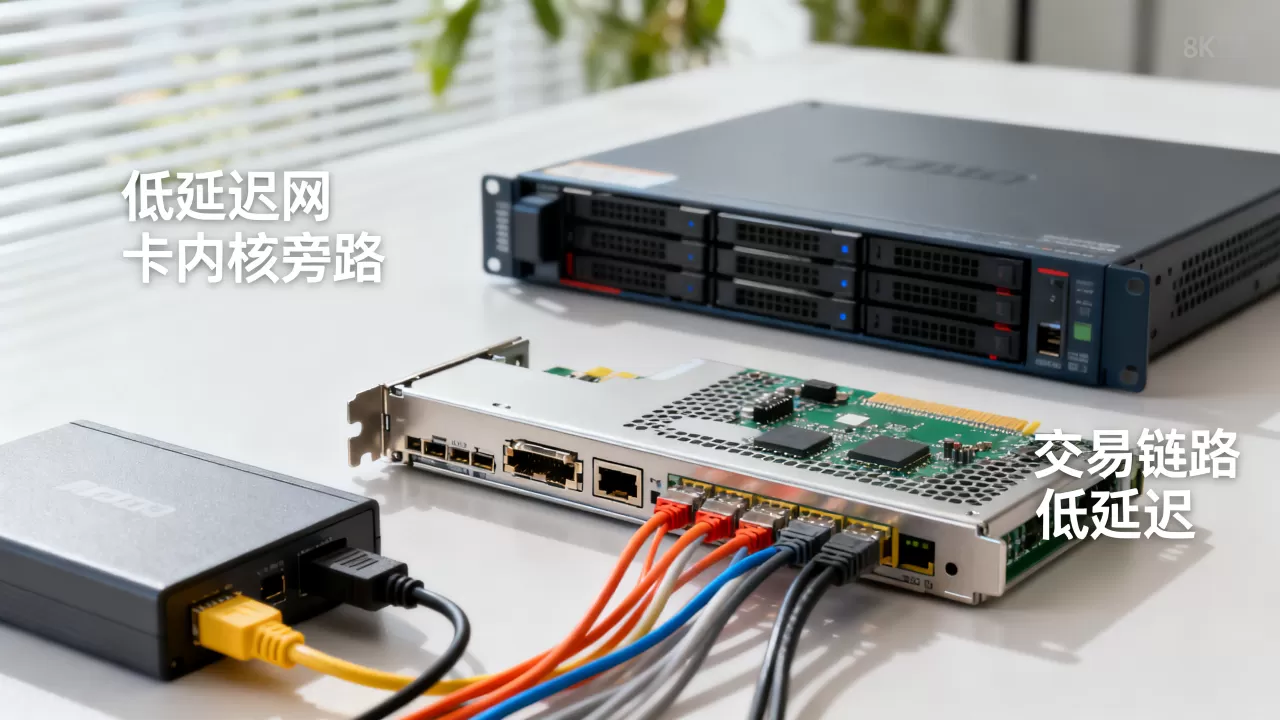
在英伟达收购Mellanox后,其ConnectX系列与Solarflare(现AMD)系列产品在交易领域占据较大比例份额,Solarflare擅长应用层加速,其Onload内核旁路方案早年已广泛应用于量化私募和做市商;ConnectX则以高吞吐和灵活流表处理见长,软硬件结合方案并非贵的才好,核心匹配点在于你的业务是行情广播密集型还是订单交互密集型。
内核旁路和内核协议栈性能对比
| 维度 | 传统内核协议栈 | 内核旁路方案 |
|---|---|---|
| 延迟 | 数十微秒量级 | 1-5微秒量级 |
| 抖动 | 高,受中断与锁竞争影响 | 低,稳定轮询 |
| CPU占用 | 高,系统调用频繁 | 低,多核扩展性好 |
| 开发复杂度 | 低,Socket编程 | 高,需处理用户态驱动 |
| 典型方案 | Socket/epoll | DPDK, AF_XDP, Onload |
内核旁路和内核协议栈性能对比揭示了一个关键事实:纯软件层面已经无法再压缩系统调用与数据拷贝的额外开销,只有从硬件位置上改变数据路径,才能实现量级上的提升。
三个典型交易场景的内核旁路实战落地
极速行情转发系统
期货公司或交易所托管机房中,行情网关负责接收原始行情流,并组播转发给内网各交易前置,传统UDP组播接收存在高频丢包隐患,内核缓冲区溢出时行情缺口无法弥补,采用低延迟网卡后,网卡通过Flow Steering将组播流量按订阅关系分发至指定队列,用户态程序使用DPDK或AF_XDP对特定队列轮询,实现“零拷贝”接收,若遇到瞬时大流量,网卡上的优先级流控策略可以先丢弃非关键控制报文,保证重要行情帧不丢失。
极速交易柜台系统
典型链路包括客户端策略机、柜台前置、交易所撮合引擎三段,在这条链路上,柜台前置与交易所之间的通信延迟占据大头,利用Solarflare Onload库可以替换系统Socket接口,业务代码仅需重编译即可透明获得内核旁路收益,做市商的订单修改与撤单请求通过专用网卡通道直通交易所接入端口,配合硬件时间戳计算端到端延迟基线,运维团队可直接通过网卡统计的延迟分布定位瓶颈。

某中大型量化私募在部署低延迟网卡后,订单从生成至进入交易所撮合核心的平均时间缩短一半以上,操作步骤如下:在操作系统BIOS层面关闭CPU休眠节能与超线程;将网卡SR-IOV虚拟出专用VF分配给交易进程;调优PCIe的Max Payload Size设置,使得DMA传输效率最大化。
跨机房极速交易链路
对于涉及多地域协同的交易策略,金融极速专线终端通常需要客户侧部署专用加速网卡,长距离链路的传播时延无法压缩,但编解码处理时延与协议处理时延是可控的,内核旁路方案在此处负责实现高效的TCP单边加速或RDMA传输,省去TCP/IP协议栈的逐层校验开销,保证重传逻辑的确定性这一环节,低延迟网卡与内核旁路技术在硬件中实现,依然比TCP重传耗时更短。
部署低延迟网卡方案的核心步骤
以下是一套经过多数项目验证的标准执行路径:
- 网卡选型与固件版本确认:特别查看是否支持UEFI时间同步及最新的固件内嵌流表能力,必要时与厂商确认对交易场景的专项优化版驱动。
- BIOS与电源管理优化:启用Performance模式,关闭C-State,设置PCIe链路为Gen3/Gen4,关闭NUMA层面的跨节点访问。
- 分配专用CPU核心:通过Isolcpus内核启动参数隔离至少两个物理核心给网卡轮询线程和应用线程。
- 内存大页配置:为DPDK或AF_XDP分配1GB大小的大页内存,减少TLB Miss,尤其影响吞吐的稳定性。
- 网卡卸载策略:开启RSS与Flow Director,同时针对业务端口类型关闭不必要的TCP Segmentation Offload功能,避免大包分段增加延迟。
这组操作对性能影响最为显著,上海和深圳的许多期货交易团队,在试运行环境按此步骤调参后,系统整体延迟曲线趋于平滑,几乎全部消除了微秒级的毛刺。
内核旁路方案选型讨论
具体选型中,DPDK提供了最大的灵活性,但绕开了协议栈,所有TCP状态机都需要自己实现或依赖第三方用户态协议栈;AF_XDP是Linux内核原生支持的地图通道,兼容性好,适合希望保留部分内核能力但不想绑定特定硬件厂商的用户;Onload则最省心,因为API完全兼容Socket,对量化团队策略代码几乎无需改动。
对于多数交易团队来说,综合开发成本与稳定性,Onload这类透明加速方案在券商柜台场景中应用更广泛,而DPDK则更受自研极速行情系统的技术团队青睐,团队若有过硬的C语言功底,可以选择AF_XDP尝试过渡,其损耗仅比DPDK略高,但省去大量维护协议栈的负担。
低延迟网卡价格和总体拥有成本如何考量
低延迟网卡价格并非中小投资者误以为的“天价”,主流品牌的双端口25G低延迟网卡市场价常见在万元人民币上下,旗舰级可编程网卡则达到数万元,与动辄百万的极速交易柜台软件授权相比,硬件成本占比相当有限,租用托管机房机柜和获取极速交易权限反而占去大部分预算,但低延迟收益却是立竿见影的。
低延迟网卡与内核旁路相关常见疑问解答
低延迟网卡方案能否直接替换现有应用而无需改代码?
并非完全免改,如果使用Onload或EFA这类透明库,只需替换动态链接库指向或重新编译即可;若使用DPDK,则应用必须使用其接口重写网络收发部分,交易柜台这类逻辑复杂系统通常采用前者平滑过渡,行情前置则更倾向于用DPDK重写以获得极致性能。
内核旁路技术是否存在安全或稳定性风险?
风险集中在两点:一是用户态进程崩溃后网卡DMA映射可能残留,需要驱动做完整清理;二是轮询模式会始终占用CPU,影响同机其他业务,但在交易托管环境,机器专用于单业务,接受这两点风险并做好监控告警,即可确保系统稳定运行。
做市商或高频团队何时才需要部署内核旁路方案?
当策略本身耗时低于行情刷新周期,且由于系统处理抖动导致错单数量明显增多时,就已经具备部署条件,判断标准是:若有超过一小部分订单因软件栈处理延迟而错过预期报价区间,内核旁路带来的收益就足以覆盖实施成本。
交易链路的极致性能并非靠单点突破,低延迟网卡与内核旁路为数据通路提供了确定性保障,落实到工程细节,从硬件选型到核心绑定,每一步调优都能换来实实在在的延迟收益,量化交易团队在采购设备时,不妨优先将预算投向这条路径,其投资回报率往往高于单纯升级服务器CPU,整个方案的本质是用硬件确定性换取时序确定性,这正是交易系统生命线所在。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/765525.html