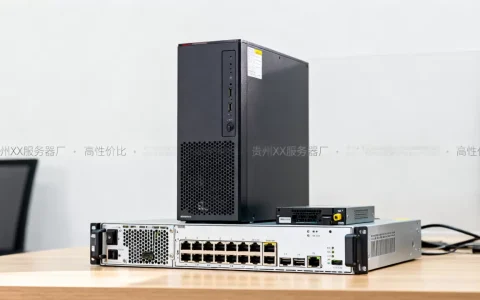
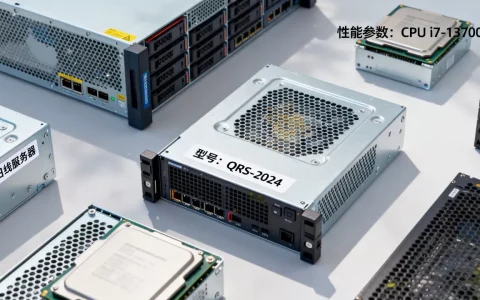
数据支撑服务器并不是某一种具体的机器,而是一套为大数据处理、存储和查询提供底层算力与空间的分工明确的集群系统,其中核心是Hadoop生态中的NameNode、DataNode以及负责计算与查询的各类角色服务器。
在构建数据平台时,很多人分不清“数据库服务器”和“大数据服务器”的关系,总想用一台高配机器搞定所有事,数据支撑服务器的形态取决于你的数据量级、查询复杂度和实时性要求,下面咱们从角色分工、主流方案对比、选购配置三个维度,把这类服务器的家底彻底盘清楚。
一套完整的数据支撑集群,到底由哪些角色构成
如果把数据平台比作一个现代化物流园区,那么每一类服务器都有自己明确的工种,行业共识认为,一个标准的Hadoop大数据集群至少需要三类角色协同工作。
管理节点服务器(NameNode角色)
这类服务器是整个集群的“总指挥官”,负责管理文件系统的元数据,也就是记录数据“放在哪个DataNode上”的目录信息,它不存实际业务数据,但一旦宕机,整个集群都会陷入瘫痪,这类机器需要极高的内存和稳定性,通常要求64GB内存起步,配备双电源和RAID卡。
数据节点服务器(DataNode角色)
这是真正的“仓库管理员”,承担了绝大多数的磁盘存储压力,你需要根据数据增长预估来决定采购数量,这类服务器对CPU要求不高,但对磁盘容量和IO吞吐极为敏感,常见配置是12盘位或24盘位的机架式服务器,每台挂载8TB到16TB的SATA硬盘,据统计,国内中型互联网公司的数据集群,DataNode数量通常维持在20台到100台之间。
计算与查询节点(ResourceManager与NodeManager角色)
当你的数据需要被分析时,单纯的存储是不够的,计算节点就是负责“跑数”的劳动力,它们通过YARN或Kubernetes进行资源调度,执行MapReduce、Spark或Flink任务,这类服务器是典型的“吃CPU和内存的怪兽”,通常需要双路至强金牌处理器,配备128GB到512GB内存,并且最好使用NVMe固态硬盘来加速中间结果的落盘。
数据支撑服务器和普通服务器区别在哪,该如何选型
很多初次搭建平台的团队都会纠结一个问题:能不能直接用几台高性能PC服务器顶替?答案是:短期可以,长期必出问题。
数据支撑服务器和普通服务器区别主要体现在三个方面:
- 横向扩展能力:普通服务器强调单机性能,而数据支撑服务器需要支持集群化的横向扩容,你可以随时增加一台DataNode来扩展容量,而无需迁移旧数据。
- 数据冗余机制:普通服务器依赖RAID卡来防硬盘故障,而大数据服务器通常采用多副本机制(HDFS默认3副本),在软件层面就解决了数据安全问题,反而对磁盘的硬件RAID要求没那么高。
- 网络拓扑要求:数据支撑服务器的数据搬运是跨节点的,普通千兆网卡会成为瓶颈,行业通用做法是采用万兆甚至25G网络互联,确保数据在Shuffle阶段不卡脖子。
基于这些区别,目前主流的数据支撑方案大概分成两大流派。
Hadoop生态全家桶
这个方案适合数据量规模大(PB级别以上)、查询模式以离线批处理为主的业务场景,核心服务器包括HDFS的存储节点、Hive或Spark的计算节点,它的优势是生态极为丰富,什么业务都能接,劣势是查询响应速度慢,要求在分钟级甚至小时级。
ClickHouse或Doris这类MPP架构数据库
这类方案适合数据量在TB级别到PB级别之间、需要秒级响应报表或做用户画像的场景,它的服务器角色相对简单,通常就是统一的“数据节点”,依靠分布式架构把数据分片存储在多个节点上,相比Hadoop全家桶,ClickHouse在聚合查询上的速度往往能快出数倍,业内专家指出,如果业务对实时性要求极高,且SQL查询模式相对固定,直接选择MPP架构会更为省心。
怎么选择数据支撑服务器配置,避免花冤枉钱
采购不是堆硬件,而是按角色匹配需求,这里给出一份按场景划分的配置参考。
中小型创业公司,数据量在10TB到50TB之间
这个阶段不需要复杂的Hadoop集群,你可以采购3台高性能数据库服务器,组成一个基于MySQL或PostgreSQL的分布式集群,再搭配一台分析型服务器(例如部署StarRocks或ClickHouse),核心配置建议是:每台机器选择双路CPU(如英特尔至强4314),内存256GB起步,磁盘用4块1.92TB企业级NVMe固态硬盘做数据热存储,配合冷存储对象存储做数据分层。
中型互联网企业,数据量500TB以上,日增1TB到5TB
此时需要标准的Hadoop数据湖,建议采购的角色如下:
- 2台NameNode主备节点:内存512GB,固态硬盘做元数据镜像。
- 10台部署DataNode:每台24盘位,单盘容量16TB,总计带来约320TB裸容量(扣除副本冗余后实际容量100TB左右)。
- 5台计算节点:承载Spark或Flink任务,双路CPU,内存256GB。
高并发实时查询业务
不需要Hadoop,重点放在OLAP服务器的内存和CPU主频上,建议采用8台以上的分布式数据库节点,每台配置双路高频CPU(主频3.0GHz以上),内存512GB起步,网络务必采用25G RDMA,否则数据重分布会成为瓶颈。
数据支撑服务器多少钱一台,以及采购成本构成
价格是决策的核心因素。企业级数据支撑服务器推荐主要可以分为品牌机和白牌机两条路线。
- 品牌机(如戴尔、浪潮、新华三):提供完整的售后服务和技术支持,适合没有专职硬件运维的团队,一台双路至强、256GB内存、8块16TB硬盘的机架式服务器,价格通常在5万到10万元人民币之间。
- 白牌机(整机柜定制):直接找代工厂攒机器,省去品牌溢价,适合有一定运维能力的大型公司,同样配置的成本能压缩到3万到5万元,但这意味着你需要自己承担硬件故障风险。
关于数据支撑服务器多少钱一台这个问题,很多用户只盯着硬件采购价,却忽略了后续的机柜和电费,一台满载的24盘位服务器功耗在600瓦到1000瓦之间,一年电费就是一笔不小的开支,如果放在公有云上,云主机加云盘的支出,通常会比自建机房贵出30%到50%,但是节省了运维人力。
如何快速辨别你的业务是否需要“支撑服务器”,还是普通NAS就够
一个残酷的现实是,很多企业买了昂贵的大数据集群,实际上处理的业务用一台普通的文件服务器也能搞定,判断标准很简单:当一台数据库服务器的CPU利用率经常超过80%,或者单表查询超过2秒,且数据量还在快速增长时,才考虑引入分布式数据支撑架构。
如果仅是为了存放历史文件、备份数据和日志归档,用一台普通的NAS服务器,配合备份软件,成本会更低,建议所有团队在规划初期,先做一次数据生命周期梳理,把数据分为热数据、温数据和冷数据,热数据放本地SSD,温数据放Hadoop集群,冷数据归档到对象存储或磁带库,这种分层策略能最大程度发挥“数据支撑服务器”的性价比。
常见问题解答
公共云上的数据支撑服务器和自建机房有区别吗?
有,公共云提供的是虚拟化资源,例如简米云的E-MapReduce服务或酷番云EMR,它们能帮你开箱即用地部署Hadoop集群,且支持弹性伸缩和按量付费,对于初创团队,这能避免前期过重的资本开支,但代价是单TB存储成本更高,自建机房则需要一次性投入硬件采购费用,并自行负责机房运维,机柜租金和电费是持续性支出,如果数据量超过500TB且长期稳定增长,自建机房的总拥有成本相对更低。
数据量达到多大才需要组建Hadoop集群而不是使用单机数据库?
行业普遍认可的经验阈值是,当单机MySQL的存储容量超过2TB到5TB,或者查询复杂度和并发量导致单实例CPU长期跑满时,就应该考虑引入Hadoop或分布式OLAP引擎,在数据量小于这个规模时,使用常规的PostgreSQL或SQL Server配合归档策略,是更简洁高效的方案,判断的核心标准并非单纯看数据条数,而是看数据是否已无法通过简单的索引优化或分表操作来满足业务查询时效。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/770915.html