服务器上 16 进制的 0A 就是换行符,去掉它的核心逻辑只有一句话:先用 hexdump 确认它到底是字节 0x0A、还是 CRLF、还是字面量反斜杠+n,再按“文件层去字节、代码层去字符串、数据库层去字段”三条路分别下手。 文件层最稳的是 truncate -s -1 或 perl -0777 -pe 's/\n\z//',代码层最稳的是 rstrip('\r\n'),SQL 层最稳的是 TRIM(TRAILING CHAR(10) FROM col)。
0A 到底是什么:三个容易混淆的东西先分清
0A 是十六进制的 10,对应 ASCII 里的 LF(Line Feed),它在服务器上到处都是,原因很简单:POSIX 标准规定文本文件的一行以 LF 所以 Linux 下几乎每个文本文件最后一个字节都是 0A,问题往往不是你“看到了”0A,而是它出现在了不该出现的位置密码文件末尾、接口签名字符串末尾、数据库字段尾部。
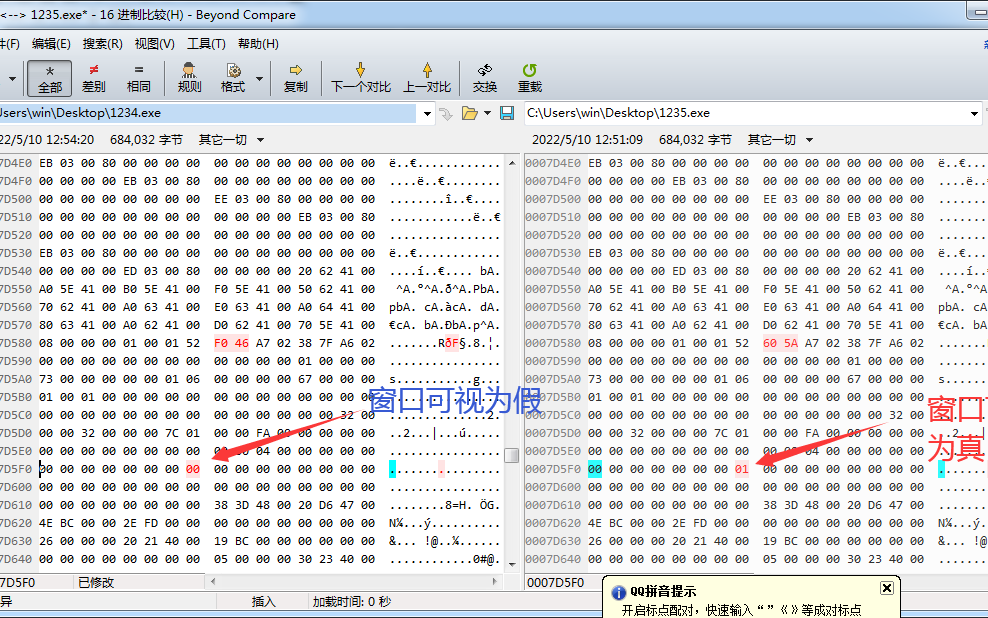
Windows 与 Linux 换行符 0d0a 和 0a 有什么区别
这个区别是所有排查的起点,业内共识认为,跨平台传输后的文本错乱,绝大部分来自换行符不一致。
| 平台/场景 | 十六进制 | 常见表现 |
|---|---|---|
| Linux / macOS(Unix) | 0A |
cat -A 显示 |
| Windows | 0D 0A |
cat -A 显示 ^M$ |
| 老式 Mac 文本 | 0D |
只有回车,无换行 |
| 连续空行/文件尾多行 | 0A 0A |
尾部出现两个以上 0A |
去掉 0A”之前,先问自己一句:我要去掉的是行尾正常的 LF,还是某个字段里混进来的多余 LF?前者往往是误删,后者才是真问题。
别把字面量 \n 当成换行符
这是新手踩坑最多的地方,文件里写的是 \n 两个字符,实际字节是 5C 6E(反斜杠 + 字母 n),根本不是 0A,配置文件、JSON 字符串、代码里的转义序列经常长这样,用 sed 删 0A 当然删不掉。
确认手段很直接:
# 看文件末尾几行的十六进制
hexdump -C app.conf | tail -n 5
# 或
xxd app.conf | tail -n 5
# 看单个变量/字符串
printf '%s' "$MY_VAR" | xxd
如果输出里出现 5c 6e,那是字面量,得用文本替换处理;出现 0a,才是真正的换行字节。
Linux 文件里末尾 0a 怎么去掉:按场景给命令
文件层的处理原则是先备份再动手,因为删错字节是不可逆的。
只去掉文件最后那一个 0a
很多场景(比如把私钥、Token、单行配置塞进文件)要求文件末尾不带换行,这时候不能让整个文件塌成一行。
cp file file.bak
# GNU coreutils
truncate -s -1 file
# 或者
head -c -1 file.bak > file
# 或者 perl 精确匹配文件绝对结尾
perl -0777 -pe 's/\n\z//' file.bak > file
truncate -s -1 的含义是“文件大小减 1 字节”,前提是你已经用 hexdump 确认最后一个字节确实是 0A,如果末尾是 0D 0A,那就减 2 字节,或者改用 perl -0777 -pe 's/\r\n\z//'。
去掉代码里字符串末尾 0a 怎么处理(文件合成一行)
日志分析、比对哈希、把多行 JSON 压成一行时,需要把文件里所有 LF 全删掉:
tr -d '\n' < app.log > app_oneline.log
# 保留空格分隔
awk '{printf "%s ", $0}' app.log > app_oneline.log
# 顺带处理 CRLF 再合并
tr -d '\r\n' < app.log > app_oneline.log
反过来,如果你只是想把 Windows 的 CRLF 统一成 LF,别用 tr -d '\r' 全删(会误伤二进制内容),用:
sed -i 's/\r$//' app.conf
dos2unix app.conf
批量转换:跨地域机房日志汇总时的统一处理
做多地机房日志集中分析时,常见情况是华北节点输出 CRLF、华南节点输出 LF,汇总后统计口径全乱,批量处理时先按扩展名过滤,避免误伤二进制文件:
find /data/logs -type f -name ".log" -exec sed -i 's/\r$//' {} +
find /data/conf -type f -name ".conf" -exec dos2unix {} \;
vim 里也能改:打开文件后 set ff=unix 再 wq;要让文件末尾不带换行,用 set binary 配合 set noeol 保存。
代码层:字符串末尾 0a 怎么去掉
程序里的 0A 通常来自 readline、readlines、文件读取、HTTP 响应体、数据库取值,处理方式取决于你要去掉“尾部”还是“全部”。
Python 字符串末尾 0a 怎么去掉
s = raw.decode("utf-8") if isinstance(raw, bytes) else raw
s.rstrip("\r\n")      # 只去尾部所有 \r 和 \n,最常用
s.rstrip()            # 去尾部所有空白(含空格、制表符)
s.replace("\n", "")   # 全文去掉换行
s.splitlines()        # 需要逐行处理时更稳
# 字节层面
b = raw.rstrip(b"\r\n")
注意 rstrip("\r\n") 的参数是“字符集合”,不是“字符串序列”,所以尾部连续多个 \n\r 都会被清掉,这正是多数场景想要的效果,如果只想去掉一个换行,用 if s.endswith("\n"): s = s[:-1]。
其他主流语言的等价写法
| 语言 | 写法 | 说明 |
|---|---|---|
| Java | s.replaceAll("[\\r\\n]+$", "") |
Java 11+ 可用 s.stripTrailing() |
| Go | strings.TrimRight(s, "\r\n") |
参数同样是字符集合 |
| PHP | rtrim($s, "\r\n") |
必须双引号,单引号不解析转义 |
| Node.js | s.replace(/[\r\n]+$/, "") |
配合 s.trimEnd() 更直观 |
| Shell | ${var%$'\n'} |
只去掉末尾一个换行 |
业内专家指出,字符串清理最忌讳直接用 trim() 一把梭它会连首部的空格一起吃掉,遇到需要保留缩进的配置内容或签名原文时,反而制造新问题。
数据库层:字段结尾 0a 怎么去掉
数据入库时带进来的 0A,靠前端 trim() 是治不好的,得在 SQL 层解决。
MySQL 字段结尾 0a 怎么去掉
先确认,再修改:
-- 看真实字节
SELECT id, HEX(col_name) FROM your_table WHERE id = 123;
-- 找出行尾带换行的记录
SELECT id FROM your_table WHERE col_name LIKE '%\n%' OR col_name LIKE '%\r%';
-- 只去尾部 LF
UPDATE your_table SET col_name = TRIM(TRAILING CHAR(10) FROM col_name);
-- 连 CRLF 一起清
UPDATE your_table
SET col_name = TRIM(TRAILING CHAR(10) FROM TRIM(TRAILING CHAR(13) FROM col_name));
-- 字段中间也混了换行
UPDATE your_table SET col_name = REPLACE(REPLACE(col_name, CHAR(13), ''), CHAR(10), '');
关键点:TRIM(TRAILING '\r\n' FROM col) 只能匹配完整的 \r\n 序列,单独一个 \n 去不掉,所以老老实实用 CHAR(10) 和 CHAR(13) 分开处理更保险。
Redis、配置文件和导入文件里的隐藏换行
Redis 里用 STRLEN key 对比预期长度,多出来的字节往往就是末尾 0A;写入时用 printf '%s' 代替 echo。
CSV 导入 MySQL 也是重灾区,RFC 4180 规定 CSV 行尾用 CRLF,用 LOAD DATA INFILE 导入时如果没写 LINES TERMINATED BY '\r\n',最后一个字段就会吃进一个 \r,查出来 HEX 尾部是 0D 或 0D0A。
0A 引发故障的三个真实场景
密码文件多一个 0A 导致认证失败
echo "mypassword" > /etc/app/pwd 会写入 11 个字节,最后一个是 0A,程序读出来做哈希或比对,自然对不上,改法只有一个字符:
printf '%s' "mypassword" > /etc/app/pwd
# 或
echo -n "mypassword" > /etc/app/pwd
同理,把 Token、AK/SK 写进文件给程序读时,都该用 printf '%s'。
Base64 解码后带 0A
MIME 规范(RFC 2045)要求 Base64 每 76 字符插入一个 CRLF,这类数据解码前要先清掉换行,否则严格模式的解码器会直接抛异常,Java 里用 Base64.getMimeDecoder(),或者先 replaceAll("[\\r\\n]", "") 再解码,这类处理全部靠系统自带命令和语言标准库就能完成,不需要额外付费买商业工具。
串口与 AT 指令的 CRLF 结尾
AT 指令以 \r\n 服务器解析串口回传数据时,如果只按 \n 切分,每条结果尾部都会拖一个 \r,拿去匹配关键字就匹配不上,正确做法是 buf.split("\r\n") 后逐条 strip()。
去掉 0A 时最容易踩的四个坑
- 对二进制文件用
tr -d:会破坏文件结构,只对确认是纯文本的文件使用。 - 把正常的行尾 LF 删了:删完整个文件变成一行,行号报错全乱,改之前先
cp备份。 echo和printf混用:Shell 里 0A 问题一半来自这里,写文件统一用printf '%s'。- 只改代码不改历史数据:接口层加了
rstrip,数据库里存量脏数据还在,查询照样出问题,两边都得处理。
服务器16进制0a结尾去掉常见问题
问:用 sed 处理完,文件变成一行了怎么办?
答:说明用的是全文替换而不是尾部替换,恢复备份,改用 perl -0777 -pe 's/\n\z//' 只匹配文件绝对结尾,或者 head -c -1 精确砍掉最后一个字节。
问:数据库里看着没换行,HEX 查出来尾部却有 0A?
答:客户端展示时会渲染换行,肉眼看不出来,用 SELECT HEX(col) 确认,再按 CHAR(10) 和 CHAR(13) 分开 TRIM,别指望 '\r\n' 一个参数搞定。
问:字符串末尾的 0A 清干净了,接口签名还是对不上?
答:签名原文通常要求原样拼接,任何 trim 都会改变原文,正确顺序是先按约定的原文拼接并签名,最后再对输出做格式化,清理动作绝不能发生在签名之前。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/771473.html