硬件故障、系统配置错误、网络异常、安全攻击、性能瓶颈和数据备份缺失,其中硬件故障和人为误操作占了相当大的比例。下面按实际运维场景拆开讲,每一步都能直接拿去对照排查。
公司服务器常见故障有哪些?先分清这六类典型问题
服务器不像台式机,出了问题往往影响一整片业务,见过太多运维新手被同一个故障绕晕,其实只要先分清楚故障归属哪一层,排查速度能快一倍。
硬件层:硬盘和电源是故障重灾区
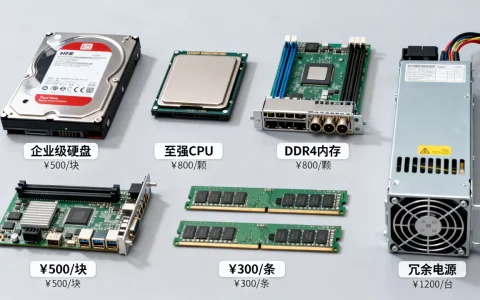
硬盘故障是服务器最常见的问题,机械硬盘用三到五年后,坏道和读写速度骤降会频繁出现,表现很直接:服务器能开机,但数据读取越来越慢,RAID阵列开始报警,甚至某个分区变成只读状态,有一类特殊情况是多个硬盘同时掉线,那是阵列卡或者背板接触不良,别急着换全盘。
电源故障更隐蔽,服务器前面板没有明显报错,但业务突然中断,重新开机又正常,过几小时又来一次,这种间歇性掉电大概率是电源老化,输出功率不稳,另外服务器内部灰尘多,风扇转速飙升,也容易触发硬件保护断电。
其他硬件问题比如内存单条损坏,系统日志会频繁报错”kernel panic”或者随机重启;CPU过热导致降频,表现为业务变慢但CPU占用率不高,这类问题靠自带的管理口(如iLO、iDRAC)查看硬件健康状态就能定位。
软件层:系统配置错误和程序崩溃
软件类故障占公司服务器问题的另一半,常见的是系统盘写满,日志文件和临时文件把根分区占满,进程没法定新文件,服务直接卡死,排查命令很简单,执行df -h看使用率,超过90%就要清理。
数据库死锁和连接数耗尽也是热门问题,比如MySQL的max_connections默认值太小,业务高峰期达到上限,新请求全部排队超时,另一类是程序代码里连接没释放,连接池被占光,行业共识认为,这类问题优先查慢查询日志和连接状态,而不是盲目重启数据库。
还有一种是依赖服务没起来,比如应用服务器启动等待Redis或者Nginx超时,报错”Connection refused”,这时候要按服务启动顺序检查依赖链,缺一不可。
网络层:IP冲突和带宽耗尽
网络问题最容易误判成硬件问题,比如公司服务器突然响应慢,ping过去延迟忽高忽低,可能是内网IP冲突,另一台设备抢了同一个IP,检测办法是在服务器上执行arping -I eth0 <服务器IP>,如果收到其它MAC地址回应,就说明冲突了。
带宽被占满也是常见场景,业务量不大但服务器网卡流量经常打满,多半有后台任务在跑大流量,比如自动更新、数据同步、内部视频下载,用到iftop或者nload看实时流量来源IP,很快就能抓到元凶。
还有一种网络问题比较专业:交换机端口协商模式不匹配,服务器网卡设置成千兆全双工,交换机端口却是百兆半双工,表现就是速度极慢且丢包严重,这种要检查双方配置,改完重启网口。
中小企业服务器出问题,优先从哪里查起?
中小公司通常没有专门运维团队,服务器出问题往往先从业务表现倒推,按这个顺序查,能救回大部分局面。
- 看指示灯和管理界面,硬件故障优先看服务器的磁盘灯和电源灯,有亮红色/琥珀色警报警告直接定位硬件。
- 查系统负载,登录服务器执行
top,看load average是否超过CPU核数,如果CPU、内存都正常,再查磁盘I/O(iostat)和网络流量(sar -n DEV)。 - 翻日志文件,系统日志在
/var/log/messages或/var/log/syslog,应用日志按业务路径找,重点看故障发生前后几行的报错信息。 - 跑一次连通性测试,从外网访问服务器,用
telnet 服务器IP 端口检测端口是否开放,确认不是防火墙或安全组拦截。
很多中小企业服务器问题是因为安全设置过严导致服务无法访问,比如简米云安全组忘了开放8080端口,本地访问一切正常,外网就是连不上,这种问题不属于硬件和软件故障,但最磨人。
服务器运维中最容易被忽视的隐患
除了突发故障,有些隐患平时没有症状,爆发时直接导致业务瘫痪,这块更值得提前动手。
备份机制形同虚设
行业共识认为,没有做备份验证的备份等于没备份,多数公司服务器都配置了定时备份任务,但从不检查备份文件是否可恢复,等到硬盘损坏或误删数据时,才发现备份文件早已损坏,无法挂载,实操心法:每月抽一天做一次恢复演练,从备份介质把数据恢复到虚拟机,确认业务能启动。
日志未做轮转和归档
日志文件无限增长会塞满磁盘,但更危险的是旧日志被清掉了,等出事时才发现关键时段的日志没了,没法定位原因,建议设置logrotate策略,日志按天或按大小分割,保存至少90天,异地存储另一份。
系统补丁长期不更新
公司服务器如果常年不更新补丁,并被暴露在公网,特别容易被自动化脚本扫描到漏洞打进来,操作系统和中间件补丁要建立月度更新计划,更新前先在测试环境验证,避免出现不兼容问题。
服务器问题排查实操步骤:从报警到恢复
当公司服务器出现异常,按下述步骤操作,多数问题能在30分钟内定位,以下命令适用于CentOS/Ubuntu系统。
第一步:快照现场,先拍照或者记录当前状态,执行uptime看运行时间,free -h看内存,df -h看磁盘,如果系统还能响应,就别急着重启,否则很可能丢失故障现场。
第二步:查服务状态,用systemctl status <服务名>看存活状态,确认是崩溃还是启动失败,如果服务崩溃,查看对应日志:Nginx查/var/log/nginx/error.log,MySQL查/var/log/mysql/error.log。
第三步:看系统内核日志,硬件和驱动问题会记录在dmesg里,执行dmesg -T | tail -50,如果看到大量I/O error或out of memory,说明问题在底层。
第四步:抓网络和进程状态,执行ss -tunap查看所有连接,用ps aux --sort=-%cpu | head -10查看消耗资源最多的进程,判断是否有异常进程挤占资源。
第五步:针对性处理,磁盘满就清日志或扩容;内存不够就优化应用参数,临时增加swap;进程僵死就杀掉进程重启服务,每一步操作后都要确认是否恢复,不建议同时改多个地方,否则搞不清是哪个操作生效的。
公司服务器远程访问故障,如何区分本地原因还是远程原因?
这类问题在混合办公场景下很常见,公司员工在家连不上服务器的现象每天都有,按下面方法区分责任端。
- 外部访问入口问题,先确认自己能否从外网telnet通服务器端口,如果通不了,检查云服务商安全组、公司防火墙策略、端口是否被占用。
- 服务器本机防火墙问题,登录服务器执行
iptables -L -n查看规则,如果是firewalld则在CentOS用firewall-cmd --list-all,测试时临时关闭防火墙,注意修改后立刻恢复默认策略。 - DNS解析和Hosts问题,公司内部域名解析失败,在客户端执行
nslookup 域名,对比返回IP和服务器实际IP是否一致,不一致时修改本地hosts或内部DNS记录。
远程访问故障大多卡在安全规则和端口监听上,真正硬件损坏的情况很少。
针对公司服务器常见问题解答
公司服务器频繁卡顿,怎么判断是带宽不够还是服务器性能不足?
先看网络指标,再算系统资源,用nload看实时出入站流量,如果网卡流量持续接近出口带宽上限,就是带宽瓶颈,如果带宽还有余量,再查看CPU、内存和磁盘I/O,执行vmstat 1 5,如果wa(I/O等待)数值一直很高,说明磁盘读写速度跟不上,区分后按瓶颈扩容即可。
服务器数据被误删,有没有不重启就恢复的办法?
如果文件系统还没有被大量覆盖,可以尝试用debugfs恢复ext4文件系统里的文件,但操作过程较为复杂,如果删的是数据库表,可考虑使用binlog基于时间点回放数据,对于虚拟机环境,如果之前有快照,直接做快照回滚是最快的方法,平时务必保留一份离线备份,恢复可靠性最高。
服务器重新启动后服务一直起不来,日志没有明显报错怎么办?
先检查服务依赖的资源是否就绪,比如MySQL依赖的磁盘分区没有正常挂载,或者应用依赖的Redis还没起来,执行systemctl status查看关联服务,再用systemd-analyze verify检查配置语法,如果问题依旧,使用strace -f -p PID跟踪进程调用的系统调用,定位卡在哪个文件或网络请求上,实际工作中,这类问题多半是启动脚本里某个路径写错或权限不足所致。
公司服务器问题绕不开硬件老化、配置失误、网络异常、安全攻击和数据备份这条主线,能在日常运维中建立监控和备份恢复机制,绝大多数故障都可以在萌芽阶段处理掉,不要等业务中断再去救火,提前把排查步骤演练熟练,才是服务器稳定运行的根本。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/771803.html