虚拟机系统死掉,先别急着重装系统多数情况下故障点不在虚拟机内部,而在宿主机资源、存储链路或快照配置上,按“看现象、看日志、看存储、再动手”的顺序排查,大部分问题能在半小时内定位。
虚拟化用久了都会遇到这一幕:昨天还好好的虚拟机,今天点开机没反应,控制台一片黑,或者卡在启动画面转圈,手一抖想重装,数据就真没了,下面这套排查路径来自一线运维的常规做法,按顺序走,能少走很多弯路。
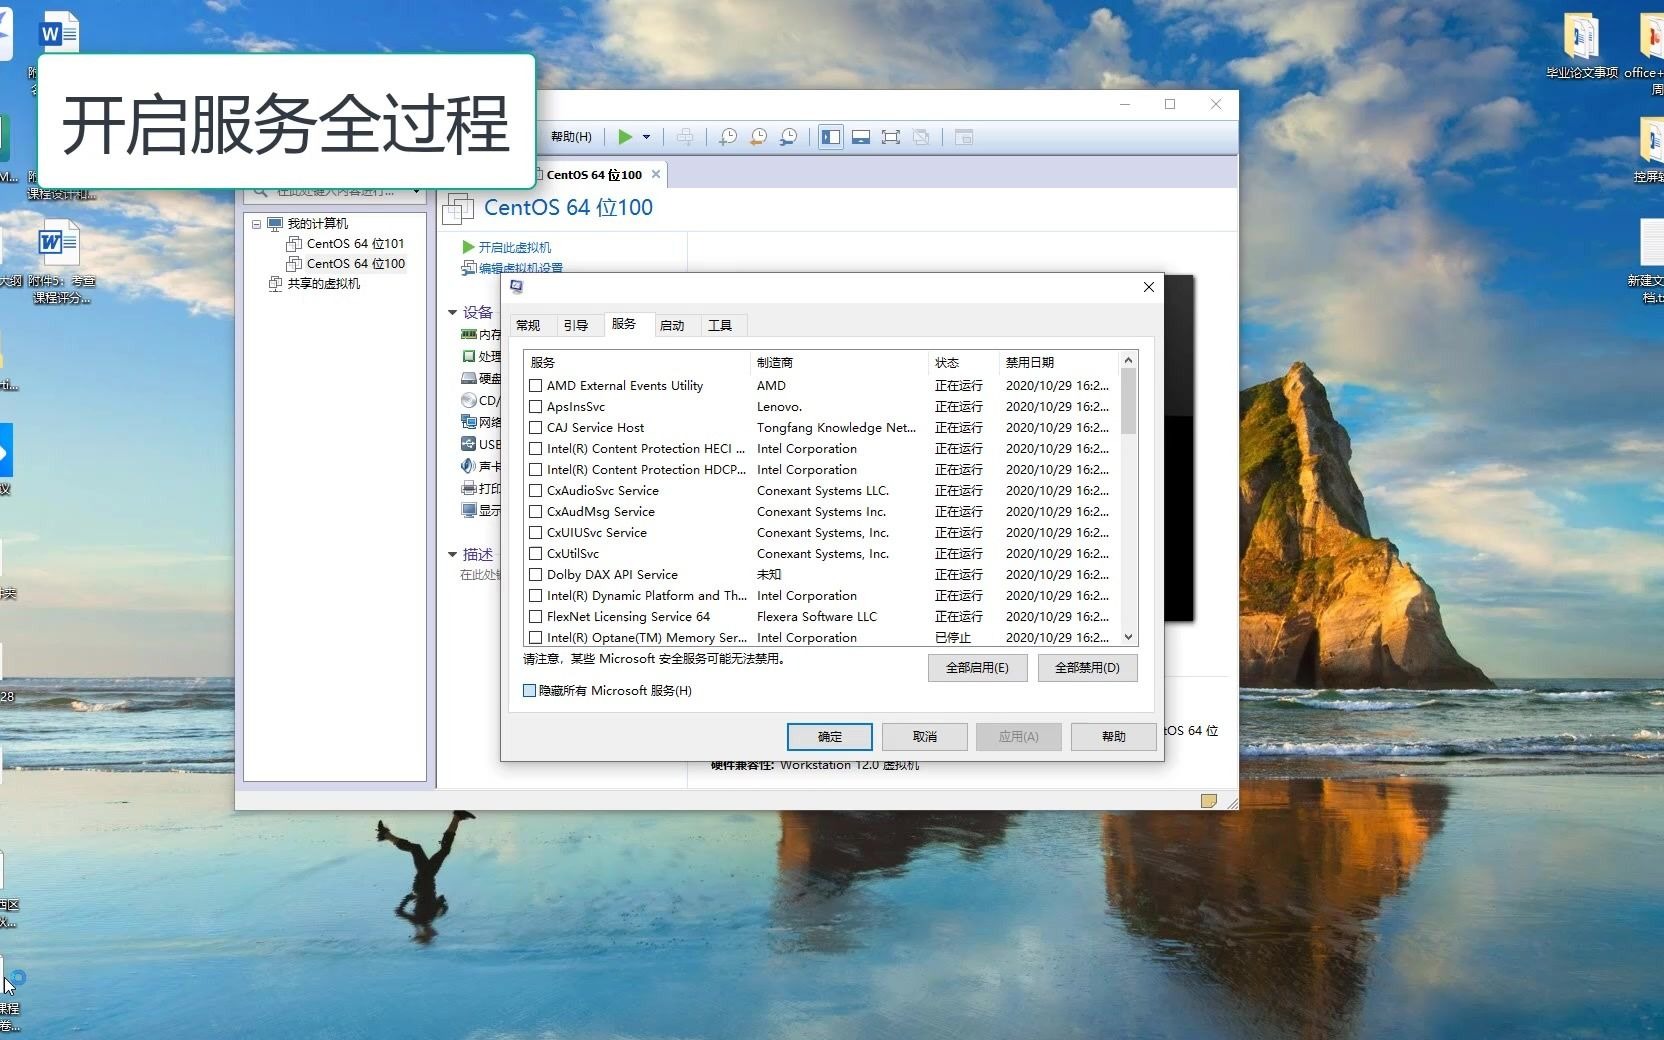
先分清“死法”:虚拟机系统死掉的三种典型症状
虚拟机“死掉”是个笼统说法,处理方式完全不同,先对照现象归类。
| 现象 | 大概率原因 | 处理优先级 |
|---|---|---|
| 宿主机能看到虚拟机进程,但控制台黑屏、无响应 | 客户机内核卡死、显卡驱动冲突、磁盘 I/O 挂起 | 先尝试软关机,再考虑强制断电 |
| 虚拟机列表里状态是“关闭”,但开机报错 | 配置文件损坏、磁盘锁残留、快照链断裂 | 先备份配置文件再操作 |
| 宿主机本身卡顿、SSH 登录慢、其他虚拟机也异常 | 宿主机内存耗尽、存储掉线、虚拟化服务崩溃 | 优先救宿主机,别动虚拟机 |
第一步永远是在宿主机上确认虚拟机进程还在不在
很多人第一反应是进虚拟机里折腾,其实门都进不去,正确顺序是先登宿主机,确认虚拟机进程状态。
- KVM 环境执行
virsh list --all,看状态是 running、paused 还是 shut off。 - Proxmox 执行
qm status <VMID>。 - Hyper-V 执行
Get-VM,关注 State 字段。 - ESXi 执行
esxcli vm process list。
如果进程还在但界面无响应,先试 virsh shutdown 或 qm shutdown 走正常关机流程,十分钟没反应再考虑 destroy 强制断电,强制断电对文件系统不友好,能不用就不用。
虚拟机系统死掉怎么恢复?从宿主机侧逐层排查
宿主机资源是否被吃满
内存超卖是最常见的隐形杀手,宿主机物理内存被分光,某台虚拟机一申请大页内存就触发 OOM Killer,把虚拟化进程干掉。
用 free -h 看可用内存,用 dmesg | grep -i oom 查有没有被系统杀掉进程的记录,如果发现 Out of memory: Killed process ... qemu-kvm,原因就找到了,临时办法是关掉几台不重要的虚拟机腾内存,长期办法是限制单台虚拟机的内存上限,别让超分比例太激进。
CPU 同样要看。top 里如果 wa(I/O 等待)长期偏高,说明瓶颈在存储,不在 CPU。
存储与快照:最常见的隐形杀手
业内专家指出,虚拟化环境里相当一部分“系统无故死掉”最终都指向存储层,磁盘空间写满、快照链越滚越大、NFS/iSCSI 挂载超时,都会让虚拟机表现为卡死。
逐项检查:
- 宿主机数据盘剩余空间,写满后虚拟机直接进入只读或挂起状态。
- 快照占用,VMware 的 delta 文件、KVM 的 qcow2 快照层,长期不合并会拖慢 I/O,甚至撑爆存储。
- 存储链路。
ping存储 IP、showmount -e验证 NFS、iscsiadm -m session看会话是否正常。
磁盘镜像本身有没有坏,可以用工具验:KVM 下执行 qemu-img check disk.qcow2,输出里如果出现大量 leaked cluster 或 corruption,说明镜像有问题。
虚拟化服务自身挂了
宿主机上看得到虚拟机进程,但管理接口失灵,多半是 libvirt、vmware-hostd 这类服务异常。
systemctl status libvirtd 看服务状态,journalctl -u libvirtd --since "1 hour ago" 翻最近日志,重启服务前先确认没有正在执行的任务,systemctl restart libvirtd 之后再刷新虚拟机列表。
云服务器虚拟机宕机和本地虚拟机故障,处理思路差在哪
这两类场景经常被混为一谈,实际处理路径差别不小。
云上先看控制台和监控,别直接登机器
云主机“死掉”时,第一动作是打开云厂商控制台,看实例状态、系统日志(VNC 或串口输出)、云监控里的 CPU 和磁盘指标,如果实例状态显示运行中但 SSH 连不上,多半是客户机内部问题,走控制台的 VNC 登录进去看,如果状态本身异常,直接提单给云厂商,比自己折腾快。
云环境的优势是有快照和镜像回滚,代价是底层你碰不到,所以云上排查的边界很清晰:客户机以内自己解决,客户机以外交给平台。
本地自建优先保数据,别急着修复
自建环境里宿主机和存储都在自己手上,操作空间大,风险也大,行业共识认为,本地虚拟化故障处理的第一原则是先做磁盘镜像备份,再谈修复,一块快照、一次 dd 拷贝,可能就是后面数据恢复的全部希望。
不同平台的实操命令清单
VMware Workstation 与 ESXi
- 虚拟机目录下出现
.lck文件夹且删不掉,说明有残留锁,先彻底关闭 Workstation 进程,再清理锁目录。 - ESXi 强制关机:
esxcli vm process kill --type=hard --world-id=<ID>,world-id 从esxcli vm process list里取。 - 快照过多导致卡顿,用
vim-cmd vmsvc/snapshot.removeall <VMID>合并(操作前务必确认快照可用)。
VirtualBox
VBoxManage list runningvms查运行状态。- 界面无响应时
VBoxManage controlvm <VM名> poweroff强制断电。 - 启动报 UUID 冲突,检查是否复制过虚拟磁盘文件,需要重新生成 UUID。
KVM 与 Proxmox
virsh destroy <VM>强制停止,virsh start --console <VM>带控制台启动,方便看引导过程。- Proxmox 下
qm stop <VMID>与qm start <VMID>成对使用。 - 引导失败时用
virsh console看 GRUB 阶段输出,能快速区分是引导器坏了还是根分区挂了。
进不去系统时,怎么把数据捞出来
系统起不来不等于数据没了,这时候目标从“修系统”切换成“取数据”。
把虚拟磁盘挂到另一台正常虚拟机上
关掉故障虚拟机,把它的磁盘文件作为第二块盘挂载到一台正常机器上,KVM 环境可用 qemu-nbd -c /dev/nbd0 disk.qcow2 把镜像映射成块设备,再 mount /dev/nbd0p1 /mnt 读取,VMware 的 vmdk 也可以走同样思路,或用 vmware-mount 直接挂载。
用 Live ISO 引导修复引导项和文件系统
挂载系统安装镜像,从光盘引导进入救援模式,执行 fsck -y /dev/sdaX 修复文件系统错误,Linux 引导损坏时,chroot 进原系统后重装 GRUB:grub2-install /dev/sda 加 grub2-mkconfig -o /boot/grub2/grub.cfg,Windows 虚拟机则用安装盘的启动修复功能。
快照回滚要想清楚代价
回滚快照最快,但快照之后写入的数据会全部丢失,回滚前先把当前磁盘文件复制一份留底,这个习惯能救命。
虚拟机数据恢复要多少钱?什么情况才值得送修
这是很多人关心的现实问题,虚拟机数据恢复的报价通常按介质类型和故障复杂度分档:
- 单块虚拟磁盘文件逻辑损坏,软件层面可修复的,一般在几百到一两千元区间。
- 物理硬盘出现坏道、磁头故障,需要开盘操作的,价格明显上浮。
- 企业级存储阵列、RAID 组损坏,按盘数和重建难度计价,费用可达数千甚至更高。
判断值不值得送修,看两点:数据有没有别的备份,以及故障是否属于物理损坏,有备份就别花这钱;纯逻辑损坏优先自己用工具尝试;听到异响、识别不到硬盘,立刻断电送专业机构,别反复通电。
预防:让下一次“死掉”变成可回滚
排查再熟练,也不如不出事。
备份和快照要分开理解
快照不是备份,快照和原盘在同一存储上,存储坏了两个一起没,据行业通行的 3-2-1 原则,重要虚拟机至少保留三份数据、两种介质、一份异地,备份任务要定期做恢复演练,没验证过的备份等于没有。
监控和告警提前埋点
宿主机内存使用率、存储剩余空间、快照存在时长,这三项设阈值告警,多数突发宕机在发生前都有指标异常,只是没人看,近年来不少团队把这几项接进统一监控面板,故障响应时间明显缩短。
关于虚拟机系统死掉的常见问答
问:虚拟机系统死掉后强制关机,会损坏数据吗?
有风险,强制断电可能造成文件系统元数据不一致,ext4 这类日志文件系统通常能在下次启动时自动修复,但数据库类应用容易出现事务中断,能走正常关机流程就别强制断电。
问:虚拟机开机黑屏但进程还在,最可能是什么原因?
优先怀疑显示驱动和磁盘 I/O,可以先用控制台的串口或 SSH 尝试登录,能登录说明只是图形层问题;登不上再看宿主机日志里有没有 I/O 超时或内存不足的记录。
问:虚拟机系统死掉,重装系统和修复哪个更划算?
看数据价值和系统复杂度,系统盘里没有独有数据、配置可以重建的,重装更快;跑着业务数据库或定制环境的,修复和取数据优先,无论选哪条路,动手前先把虚拟磁盘文件完整复制一份。
虚拟机故障处理的核心逻辑其实就一句话:先确认宿主机和存储是否健康,再决定是修客户机还是取数据,任何操作之前先留一份磁盘副本,把这套顺序养成习惯,大多数“系统死掉”都只是虚惊一场。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/772253.html