覆盖范围必须从技术故障延伸到业务链路故障,重点演练流量突增、依赖服务不可用、数据错乱和机房级故障四类场景,才能在大促真实流量冲击下保住交易成功率。
电商系统容灾演练方案:流量峰值类故障这么演
大促备战中,流量峰值是所有故障的导火索,行业共识认为,大促当天的瞬时流量通常是日常的10倍以上,网关、应用、数据库、缓存每一层都会被流量放大效应撕开缺口,容灾演练首先要覆盖的就是这类流量引发的连锁故障。
热点数据集中读取引发的雪崩场景
大促期间,秒杀商品的库存、价格、详情页会被大量请求同时打到同一批Redis节点或数据库行上,演练时需要模拟以下故障:
- 单个Redis节点因热key访问过量而CPU跑满,触发剔除策略,导致大量请求穿透到数据库
- 数据库连接池被打满,应用线程阻塞,响应时间从50毫秒飙升到3秒以上
- 商品详情页缓存批量失效,回源请求风暴压垮图片服务或文档存储
具体操作路径:使用压测工具(如JMeter或Locust)构造集中式的热key请求,在压测过程中手动将Redis节点标记为不可用,再观察下游数据库的承受情况,重点观察应用的降级策略是否在3秒内自动触发,以及半开恢复机制能否在故障解除后逐步放量回流量。
秒杀场景下的写入链路故障模拟
秒杀不只是读压力,更考验写链路,演练重点应放在:
- 库存扣减接口因数据库行锁竞争出现超时,需要验证异步削峰方案能否全量承接
- 订单创建后消息队列积压,下游库存服务消费速度跟不上,造成超卖风险
- 分布式事务在部分节点成功、部分节点失败时的补偿动作是否可靠
演练时建议将秒杀单量设定为日常峰值的3倍,同时人为向事务链路中注入一个随机慢查询,制造部分节点延迟,观察最终一致性方案能否在5分钟内对齐库存,整个演练过程应记录补偿任务的重试次数和积压消息的消费时长。
大促前容灾演练检查清单:数据层和依赖层故障场景别漏掉
除了流量冲击,大促故障更多出现在数据和依赖环节,这个模块的演练目标是验证数据不丢、主链路不中断。
数据库主从切换与缓存兜底
主库宕机是每家大促备战团队最担心的场景,演练需覆盖:
- 主库硬件故障触发自动切换,从库提升为主库后,数据延迟是否在可接受范围内
- 切换期间写入请求的失败策略,是快速失败还是排队等待,两者各自的业务损失边界
- 缓存服务整体不可用时,数据库能否通过限流策略支撑住核心商品详情页的访问
执行方式参考:在一个读写分离架构中,直接执行主库宕机命令(如kill -9数据库主进程),然后观察代理层(如ProxySQL或ShardingSphere)的探活机制是否在10秒内完成主从切换,同时打开慢查询日志,统计切换期间所有超时请求的占比。
支付网关和物流接口的故障注入
订单提交后最怕支付网关超时或物流查询接口阻塞,这类故障的破坏力在于链路上的每一个上游服务都会因为等待而占用线程资源,最终拖垮整个订单中心。
故障演练脚本参考:
# 模拟支付网关响应延迟 500ms 额外注入
tc qdisc add dev eth0 root netem delay 500ms
# 模拟支付回调接口返回 500 错误
iptables -A INPUT -p tcp --dport 8443 -j DROP验证重点是订单超时关单后,退款和本地补偿的消息触发是否符合预期,物流接口演练则关注批量查询接口被打挂后,快递信息能否切换到本地缓存的历史轨迹兜底。
机房断电与网络分区的地域级故障演练
大促容灾的终极场景是机房级别的不可用,这个级别的演练代价较高,但可以用缩小版本来模拟:
- 拔掉核心交换机光纤模拟网络分区,验证消息队列、注册中心、配置中心在分区后能否保持节点间数据一致
- 断开机房总电源(或通过云平台一键断电功能),验证另一地域集群的流量切换时长
- 同时模拟DNS切换和负载均衡器主备漂移的联动效果
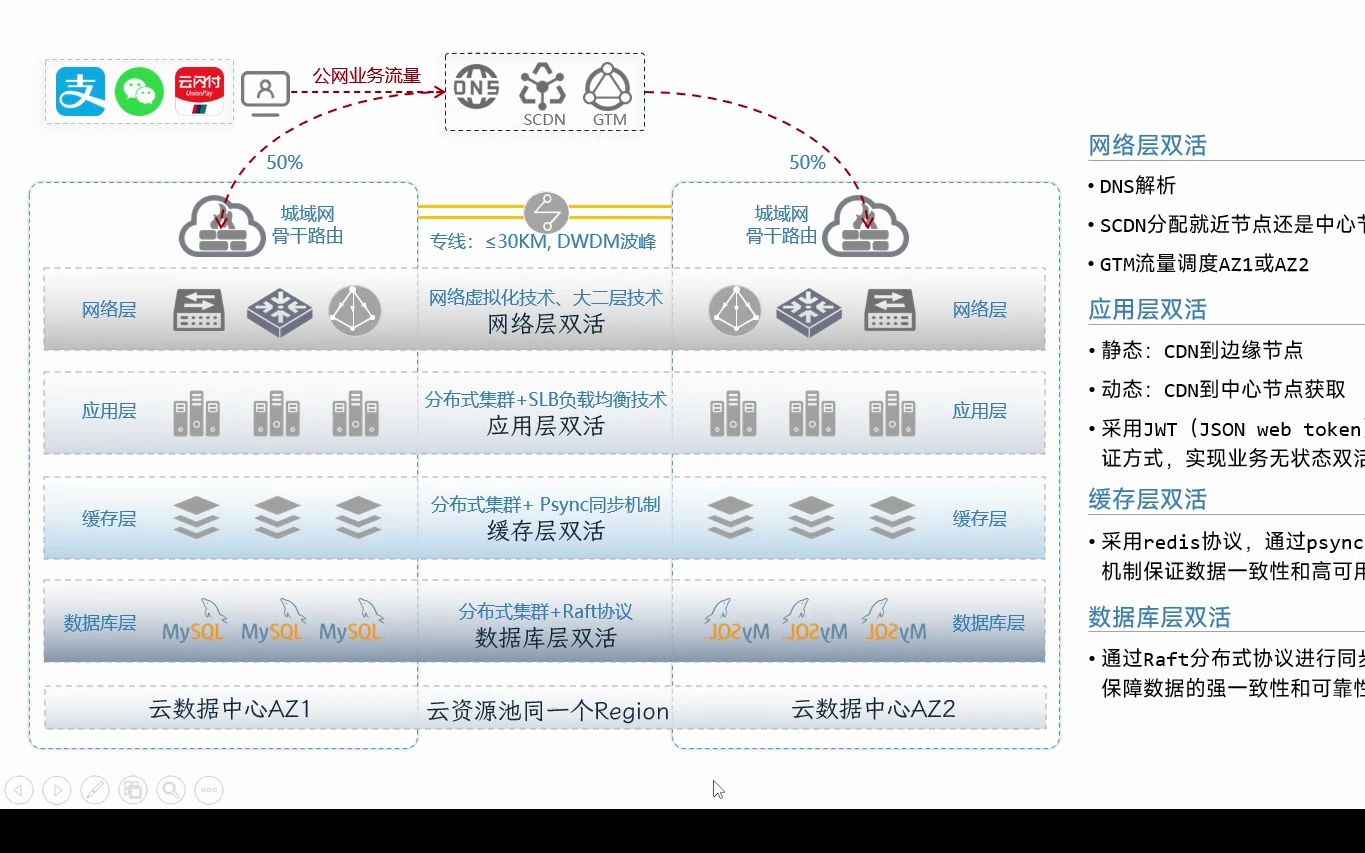
近年来,多数大型电商平台开始采用双活或三地五中心的架构,地域级演练的关注点是切换动作是否有赖于人工决策,演练前务必准备好流量切换脚本,核心逻辑是:探活、摘流量、验证数据补拉、放量。
容灾演练的执行步骤和故障复盘怎么写
演练不是把系统弄挂再捞回来,而是要形成一套可以在大促前反复执行的流程。
故障注入工具的选型与实施路径
各家中型电商团队常用的开源工具有ChaosBlade、chaos-mesh和Litmus,选型时优先关注对业务代码的侵入性和对生产环境的隔离程度。
实施路径按以下顺序推进:
- 由运维主导建立故障注入白名单,划分演练专用机器和混部机器
- 先在预发环境完整跑一遍所有剧本,确认每一步回滚动作有效
- 在生产环境低峰期执行持续五分钟的小流量演练,目标不是触发故障,而是验证监控告警能在30秒内准确定位故障半径
- 每次演练结束立即生成报告,重点记录故障发现时间、定位时间、恢复时间三个指标
容灾演练与压测的区别和配合方式
压测解决的是”系统能扛多少量”的问题,容灾演练解决的是”扛不住时能不能优雅失败”的问题,两者配合时,建议先用压测找出容量水位线,再在水位线附近注入故障,查看弹性伸缩和限流熔断的联动节奏是否协调。
复盘编写遵循”事实-影响-改进”三段式,事实部分只写时间线和操作命令,影响部分量化业务受损情况(如超时订单占比、库存扣减差异),改进部分必须指定责任人和验收时间。
大促容灾演练怎么评估覆盖度与关键问答
评估覆盖度最直接的方法:整理一份全链路调用拓扑图,逐个节点检查是否被至少一个故障剧本命中,根据行业实践,一个中等规模的电商系统(约200个微服务)在大促前需要完成不少于40个故障场景的演练,覆盖率达到90%以上才被认为备战合格。
大促容灾演练多久做一次合适
日常保持每月一次小范围演练,大促前一个月开始每周一次全链路演练,全链路演练指从接入层、应用层、数据层到依赖系统全部参与,需要公司级协调,这个频率已经是业内比较务实的节奏。
容灾演练发现了痛点如何跟踪改进
每次演练结束后形成的问题清单要进入独立跟踪体系,不跟日常开发需求混在一起,大促前两周必须完成所有P0级整改项的验证,涉及架构调整的整改项可以降级为大促期间的应急预案作为兜底,但不允许无预案上线。
容灾演练会干扰线上真实业务吗
会,所以演练才有价值,执行时通过染色流量或独立链路避免全面影响,但也要做好真实用户受影响的准备,行业共识认为,大促前演练的短期业务损失远低于真实大促故障带来的损失,多数平台在凌晨2点到5点执行演练,并提前向内部业务方发布通知窗口,控制影响面再逐步扩大演练范围。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/772905.html