总部服务器出问题,本质上不是某一台机器宕机,而是一整套IT治理体系的失灵无论是硬件故障、网络瓶颈、安全攻击还是配置错误,最终都表现为“总部连不上、业务停摆了”。
解决总部服务器问题,第一步不是急着换硬件,而是先搞清楚问题到底出在哪一层,下面按故障频次和影响程度,把总部服务器常见问题拆开讲清楚,顺便给你一套能落地的排查思路。
总部服务器硬件故障:最直接也最好判断
硬件是服务器的地基,总部机房里的服务器常年不关机,CPU、内存、硬盘、电源、主板这些核心部件,任何一个先撑不住,整台机器就罢工。
常见的硬件问题有这几类:
- 硬盘损坏:机械硬盘有机械结构,震动、高温、老化都会让磁头划伤盘片,固态硬盘虽然没机械件,但闪存颗粒有写入寿命,写满之后会出现坏块,硬盘一坏,数据读写直接报错,系统日志里会出现大量I/O错误。
- 内存故障:内存条金手指氧化、颗粒过热,都可能引发随机蓝屏或系统崩溃,开机自检时如果听到长短不一的蜂鸣声,多半是内存没插好或损坏。
- 电源老化:电源是整台机器的“心脏”,电压不稳、电容鼓包都会导致服务器无故重启,有些服务器有两个电源模块,一个坏了系统可能不报警,直到另一个也出问题才彻底断电。
- CPU过热:散热风扇积灰、硅脂干裂,CPU温度超标后会触发降频甚至自动关机,机房空调故障时最容易发生这种问题。
排查思路也很直接:先看服务器面板指示灯和系统日志,再用带外管理口(比如iLO、iDRAC)登录查看硬件健康状态,如果是硬盘故障,可以通过RAID阵列的热备盘自动顶替,但要尽快更换坏盘,否则阵列可能因第二块盘故障而崩溃,业内专家指出,超过半数的服务器硬件故障都能通过定期巡检提前发现,巡检周期建议不超过三个月一次。
网络与连接问题:总部连不上,先查链路
总部服务器问题里,网络层故障占相当大比例,表现是:分公司访问总部系统卡顿、丢包,甚至直接超时,这时候问题未必在服务器本身,而是链路中间某个环节断了。
需要逐段排查的位置包括:
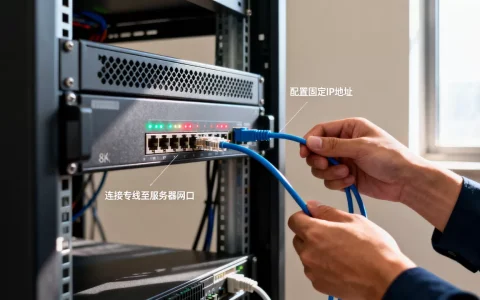
- 交换机端口:网口松动、光模块老化、端口速率协商不一致,都会造成连接不稳定,登录交换机的管理界面看端口状态,如果CRC错误包数量持续增加,多半是物理链路有问题。
- 防火墙策略:安全策略配置过严,或者有人改了ACL规则,导致特定IP段被拦截,检查防火墙会话表和策略命中计数,能快速定位是不是被安全策略挡住了。
- DNS解析故障:总部内部域名解析不到正确IP,业务系统就进不去,检查核心DNS服务器的解析日志,确认是否有域名记录过期或被错误修改。
- 专线带宽打满:总部到分公司的专线带宽不够用,视频会议、大文件传输同时跑,就会造成延迟暴增,登录路由器看流量图,如果出口带宽利用率长期超80%,必须扩容或做流量整形。
排查顺序建议从物理层往上走:先ping总部出口网关,通了再ping服务器IP,不通就逐段tracert,看看断在哪一跳,大多数情况下,网络问题的根因都能通过“分段ping”的方式快速锁定。
软件与系统配置错误:改了配置没生效,是所有管理员的心头恨
硬件和网络都正常,但服务还是不可用,十有八九是软件层面出了问题,总部服务器的操作系统、数据库、中间件,每一项配置都牵一发动全身。
高频软件问题场景如下:
- 系统补丁引发兼容性故障:Windows Server或Linux内核更新后,某个驱动程序或核心服务起不来,服务器重启后直接进不了系统,俗称“补丁反噬”,解决办法是更新前先做快照,回滚时直接恢复到打补丁之前的状态。
- 数据库连接池耗尽:应用服务连接数据库的并发连接数设置太小,业务高峰时所有连接被占满,新的请求只能排队等待,表现为页面越转越慢,调大连接池上限能缓解,但治本要优化慢查询。
- 磁盘空间写满:日志文件、临时表、归档数据把C盘或数据盘塞满,数据库写入失败,应用直接报错,用
df -h(Linux)或磁盘管理(Windows)看剩余空间,清理超过30天前的日志文件是标准操作。 - 配置变更未同步:负载均衡器、网关、应用集群的配置本来应该同步修改,但操作时漏了某一台节点,导致部分用户正常、部分用户报错,这种问题最难排查,需要逐台比对配置文件。
行业共识认为,超过七成的重大故障其实是人为操作失误导致的,而不是硬件或网络本身,所以每次变更前先备份配置,变更后立刻做验证,能防住大多数问题。
安全攻击与数据风险:潜伏型问题比宕机更可怕
总部服务器承载着公司核心数据,一旦被入侵,带来的损失远超硬件故障,安全问题往往隐藏很深,不一定表现为“用不了”,而是“数据被偷走了”。
常见安全风险包括:
- 勒索病毒加密:攻击者利用弱口令或未修复的漏洞进入服务器,植入勒索软件,把所有数据文件加密,桌面弹出付款界面,近年来这种攻击呈明显上升趋势,很多企业因此被迫断网。
- 挖矿木马:服务器CPU使用率异常飙高,风扇狂转,但业务上并没有高负载任务,登录系统用
top命令一看,某个陌生进程占满了CPU,这就是被植入挖矿程序了。 - 弱口令与暴力破解:远程桌面或SSH的密码位数太短,攻击者用字典暴力尝试,几分钟就能突破,检查
/var/log/auth.log(Linux)或安全事件日志(Windows),如果同一IP有大量失败登录记录,说明正在被扫描。 - 数据备份失效:备份任务一直显示成功,但从未做过恢复演练,等到真出事时,才发现备份文件损坏或备份软件无法还原,这个问题比被攻击还可怕,因为数据可能永远找不回来。
安全问题的排查不能靠“出事了再查”,而是要靠日常基线检查,定期做漏洞扫描,禁用root远程登录,强制使用密钥或强密码,备份文件做离线存储这些基础操作能挡住大多数外部攻击。
如何快速定位总部服务器故障原因:一套实操排查流程
遇到“总部服务器连不上”这类问题时,别慌,按下面这套流程一步步走,多数情况下十分钟内能锁定方向。
- 确认影响范围:是所有用户都连不上,还是只有个别分公司?如果是单个分公司,问题在链路或分公司出口设备;如果是全局,问题在总部核心设备。
- 登录带外管理口:趁服务器还没彻底死机,用iLO/iDRAC或IPMI看看系统是否还能响应,能登录就直接看硬件传感器状态和系统日志。
- 检查系统资源:用
uptime看负载,free -h看内存,df -h看磁盘,如果某个指标打满,优先处理该指标。 - 查看应用日志:应用日志通常放在
/var/log/下,关键的错误关键词是“ERROR”“FATAL”“Timeout”“Connection refused”,用grep按时间过滤,找出故障前最后几条报错。 - 确认网络路径:用
ping和tracert测试到服务器IP的连通性,再用telnet或nc测试业务端口(比如443、3306)是否在监听,端口不通,看防火墙和监听进程。 - 回滚最近变更:回想一下过去24小时内有没有做过配置修改、补丁更新或硬件插拔,有,就先回滚再观察。
做成一张表格,排查效率更高:
| 排查步骤 | 命令/路径 | 判断标准 |
|---|---|---|
| 检查负载 | uptime | 负载不超CPU核心数的75% |
| 检查内存 | free -h | 可用内存不低于总量20% |
| 检查磁盘 | df -h | 使用率不超90% |
| 检查网络 | ping -t 目标IP | 丢包率0,延迟正常 |
| 检查端口 | nc -vz IP 端口 | 返回succeeded |
| 检查进程 | ps aux –sort=-%cpu | 无异常高占用进程 |
| 检查日志 | tail -f /var/log/messages | 无连续刷屏的错误记录 |
这套流程覆盖了从硬件、系统到应用的常见故障点,也是很多运维团队内部的标准操作手册,记住一个原则:先问“变没变”,再查“坏没坏”大多数问题的根源,都是某个环节刚刚被改动了。
总部服务器常见问题的预防措施
与其每次出问题后手忙脚乱,不如在平时做好预防,预防投入的成本,比故障导致的业务损失小得多。
- 硬件层面:所有服务器至少做RAID1或RAID5,关键业务用双电源+UPS;硬盘、内存、电源都预留备件,同一型号的备件至少一块。
- 网络层面:核心交换机用双机热备,专线链路做主备冗余;带宽使用率超过70%就提前扩容。
- 软件层面:统一配置管理工具(如Ansible、SaltStack),每次变更走审批流程,变更后自动生成配置基线。
- 安全层面:每月做一次漏洞扫描,每季度做一次数据恢复演练;备份文件至少有“一份在本地,一份在异地”。
- 人员层面:建立值班表和操作手册,交接班时要说明当前网络状态和未完成的变更任务,很多故障都是交接不清楚、新人误操作导致的。
总部服务器问题排查时的几个常见误区
避开下面这些坑,能少走很多弯路:
- 一上来就重启服务器:重启确实能临时解决问题,但如果是因为硬盘坏道或电源老化导致的重启,重启只会加速硬件报废,先看日志再决定要不要重启。
- 忽略带外管理:系统死机后进不去操作系统,就以为服务器“彻底没救了”,实际上带外管理口完全独立,照样能看硬件状态、强制重启,不会因为系统崩溃而失效。
- 只查服务器不查链路:分公司访问总部慢,先检查分公司到总部的专线是不是被大流量占满了,不要在服务器上折腾半天,结果发现是视频会议把带宽吃光了。
- 备份了就不管:备份不是“拷贝一份”就完事,而是要定期做恢复测试,很多企业直到真丢了数据才发现,备份文件虽然存在,但恢复时总是报CRC错误。
Q&A:总部服务器相关高频疑问解答
问:总部服务器经常自动重启,是什么原因导致的?
答:先查电源和温度,登录带外管理口查看硬件传感器日志,如果发现电源模块的电压值波动超过正常范围,基本可以确定是电源老化;如果CPU温度在重启前逼近80度以上,则是散热系统故障,检查系统事件日志中是否有蓝屏代码,多数与硬件驱动或内存故障相关,按这个顺序排查,通常能较快找到根因。
问:总部服务器连得上但业务系统打不开,该怎么处理?
答:这种“服务器活着、应用死了”的情况,优先看应用服务进程是否在运行,用ps -ef | grep 应用名检查进程,再用curl -I http://localhost:端口测本地访问,如果本地都无响应,检查应用日志和数据库连接状态;如果本地正常而外部访问失败,则是防火墙或负载均衡器的问题,按“从本地到远程,从进程到端口”的路径排查,效率最高。
问:总部服务器数据被勒索病毒加密了,还有机会恢复吗?
答:如果是被正规勒索病毒加密,没有解密密钥的情况下几乎不可能暴力破解,核心的恢复路径只有两条:一是使用离线备份进行数据还原,前提是备份文件没有被一并加密且备份副本不在受害服务器上;二是尝试查找是否有解密工具泄露,但不要为此付费给攻击者,在处理思路上,彻底隔离受感染服务器,保留现场用于溯源,同时立即检查所有其他服务器是否有横向渗透痕迹。
总部服务器的问题看似千头万绪,但只要抓住硬件、网络、软件、安全四个维度,按照标准排查流程走,大多数故障都能在半小时内正确定位,日常运维中多做预防、多留备件、多演练备份,总部服务器的稳定性就能有质的提升。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/772967.html