Hadoop集群需要多少服务器,取决于数据规模、计算负载和可用性要求,而非一个固定数值,但规划时基本遵循“数据容量乘以3副本再加20%冗余”的通用估算方法。这就像搬家前先算家当体积一样,先摸清数据家底,集群规模自然水落石出,本文将以实际规划视角,拆解服务器数量计算的逻辑与步骤,顺便聊聊机房托管那些事儿。
先算数据家底:磁盘容量决定的服务器下限
服务器数量不是拍脑袋想出来的,第一步得先盘算“你有多少数据”,这里说的数据量,不是你现在业务库里的数据,而是未来3年要进入Hadoop体系的全部原始数据量。
三副本机制:容错代价必须算进去
HDFS默认冗余因子为3,意味着每份数据会在集群的不同节点上存3份,比如原始数据100TB,实际占用存储至少是300TB,这是分布式系统保障数据不丢的基础代价:
- 如果机架感知开启,数据会分布在不同机架:同机架2副本,跨机架1副本
- 若某个副本所在节点宕机,系统会自动复制补齐,需要额外预留空间
- 数据块默认128MB,小文件过多会降低存储利用率,实际规划建议预留20%缓冲
用公式表达:集群裸容量 = 原始数据量 × 3副本系数 × 1.2冗余系数,行业白皮书通常建议此比例,因为MapReduce中间结果、临时文件也会暂存本地磁盘,这部分开销必须留足。
实际案例:从数据量反推服务器数量
假设某电商平台每日新增日志数据约500GB,保留3年离线分析,则原始总量约550TB,按上述公式,集群裸容量需求约为2000TB,若采用单台服务器配置8块10TB企业级硬盘(实际可用约72TB),则数据节点至少需要28台,这里还没算NameNode、ResourceManager等管理节点通常另配3台独立服务器承载,形成“3台管理节点 + 28台数据节点”的经典组合。
计算负载拓扑:节点角色分化决定服务器配置
单纯按容量算出来的集群,大概率只能做数据仓库,跑不了复杂分析,计算负载决定服务器配置,而配置决定单台服务器的吞吐能力。
管理节点:集群的“大脑中枢”
NameNode负责元数据管理,Active/Standby双机热备是最低要求,每个元数据对象大约是150字节,100万个文件块对应的元数据约150MB,内存需求不大,但NameNode的堆内存建议随文件数量线性增长,因此管理节点建议配置:
- 64GB以上内存,双路CPU,SSD系统盘
- 独立部署JournalNode(通常3台)或依赖ZooKeeper集群协调
- 管理节点数量一般为3或5台(企业级生产环境建议至少3台,兼顾奇数投票机制)
计算节点:响应不同业务场景的“劳动力”
- 以离线批处理为主(T+1报表、数据清洗):CPU核数与内存比例建议1:4,即每核分配4GB内存,一台服务器配备32核CPU、128GB内存,可同时承载约8个Map或Reduce任务并发
- 以交互式查询为主(Hive/Spark SQL秒级响应):内存需要翻倍,1:6甚至1:8的比例更稳,此时单机配置64核、256GB内存更合理
- 以机器学习训练为主:需要GPU或高主频CPU,此时服务器数量不一定是最大,但单台成本可能是普通节点2-3倍
各组件的部署又影响数量:YARN ResourceManager通常与NameNode错开物理机部署,HBase的RegionServer则与DataNode同节点部署以利用数据本地性,综合来看,节点角色划分是“物理服务器数量+配置分布”的组合问题,精度要求高时建议用Capacity Scheduler容量调度器做资源隔离。
按负载类型拆分:千万别一个集群包打天下
生产环境通常拆分为:
| 集群类型 | 用途 | 典型规模 |
|---|---|---|
| 离线批处理集群 | ETL、数据仓库、历史数据归档 | 规模最大,占用多数服务器 |
| 实时计算集群 | Flink/Spark Streaming流处理 | 规模较小,对网络延迟敏感,跨机房部署需谨慎 |
| 交互分析集群 | 即席查询、BI报表 | 规模弹性大,依赖内存计算,对CPU与网卡要求高 |
上表不同集群的服务器数量与硬件侧重差异很大,加起来才是总需求,而不是一套集群全跑。
可用性与故障域:不能只看平均数
服务器数量规划还必须纳入“故障转移”因子,Hadoop集群运行中,几台服务器宕机属常态,关键是整体容量冗余能扛住。
节点冗余:至少预留一台备用机
业界通用做法是“N+1”冗余策略,例如数据节点30台,实际配置31台多出来的那台用于在线替换故障节点,避免因长期降级导致数据块复制风暴。
机架感知:跨机架复制消耗额外资源
若服务器分布在多个机架,HDFS写入时会在不同机架存放副本,网络传输开销明显增加,据行业参数,跨机架带宽利用率通常仅为机架内的60%左右,这意味着:
- 机架间网络瓶颈可能导致任务延迟,需额外安排10%节点做计算缓冲
- 可用性要求高的核心集群,建议采用双副本跨机架部署,此时服务器数量需增加
从最小集群到规模化:逐步扩容路径
如果业务刚起步,不需要一步到位,Hadoop支持水平扩展,这意味着先从“够用”起步,再随数据增长弹性添加节点,是成本最优的路径。
起步阶段:10台以内可跑通全链路
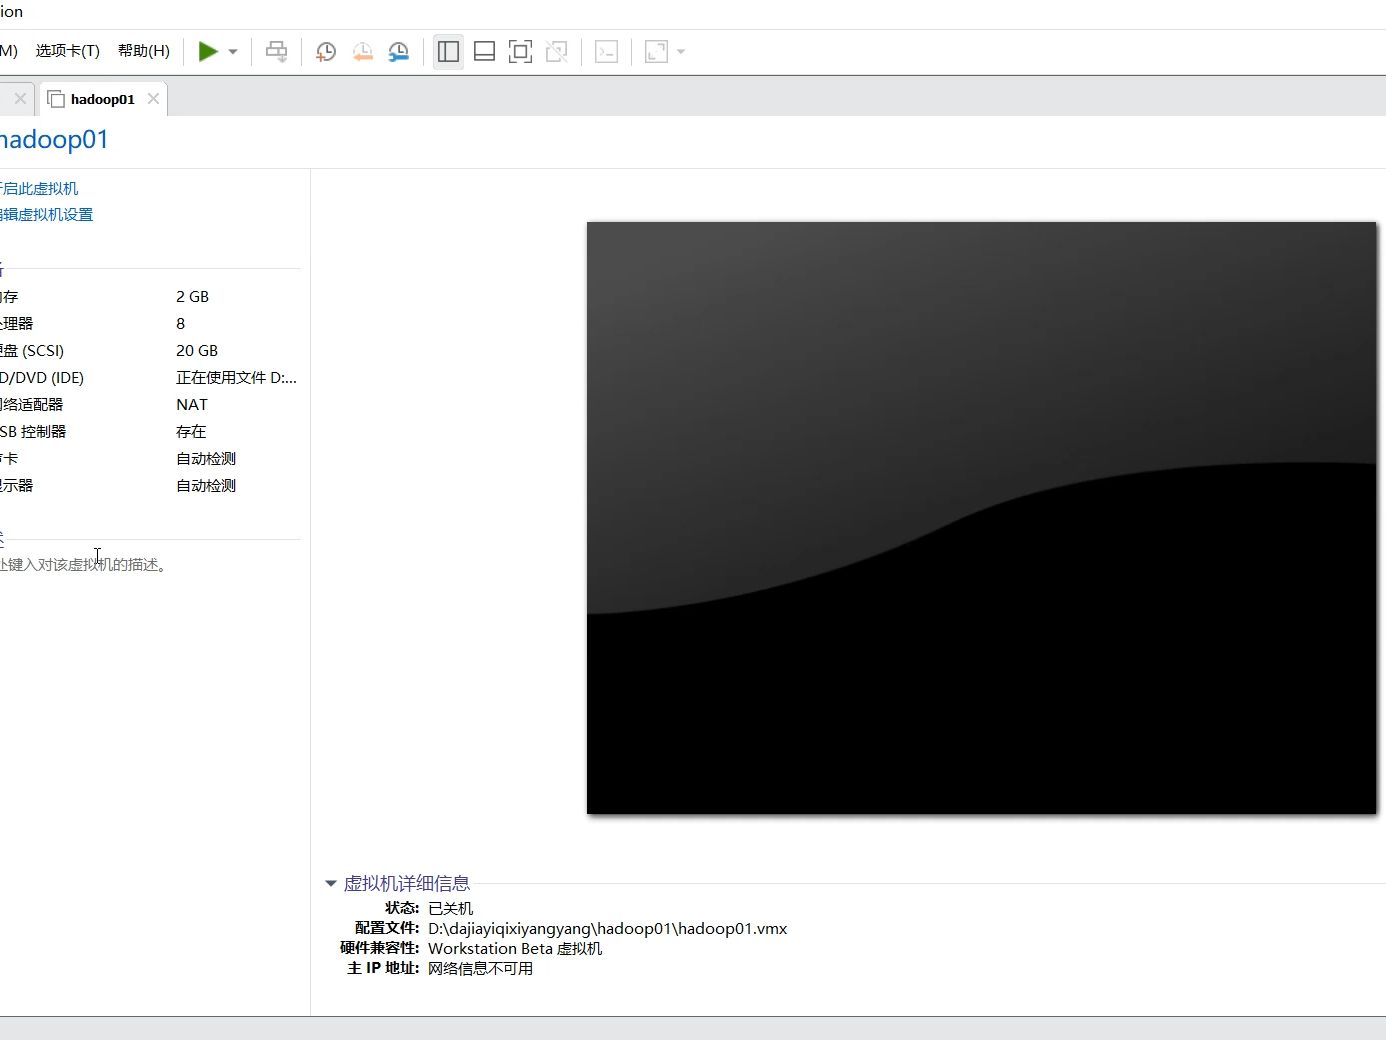
最小可用集群:3台管理节点(NameNode+ResourceManager+ZooKeeper),3台数据节点(同时作为计算节点),1台工具节点(负责集群管理、监控、网关),此时单台数据节点可配12块硬盘,总裸容量约200TB,支撑日增数十GB的数据规模绰绰有余。
规模化阶段:随存储增长按“批”扩容
当命名空间或存储接近80%时,建议成批增加数据节点,每批新增数量取决于可用的机架空间与网络端口数量,通常一次增加5-10台,扩容时注意:
- 执行
hdfs dfsadmin -report确认数据均衡度,优先扩容低水位节点 - 扩容后用
hdfs balancer触发数据平衡,避免新增节点写入倾斜 - 配置文件需同步更新
dfs.replication与dfs.datanode.data.dir参数,确保新节点加入后分块策略不变
这种分批扩容的思路也适用于云主机与物理机的混合部署,整体集群规划完成后,更需要关注服务器部署方式自建机房还是托管在专业IDC。
部署形态选择:自建机房还是持牌IDC托管
服务器数量定了,放在哪里同样影响架构,多数企业集群规模在20台以内时,托管比自建更划算,因为自建机房需要面对电力、制冷、带宽、消防等繁琐工程,而且人员运维成本高。
如果选择托管,服务商的资质与可靠性是第一道门槛。简米科技自2003年创立以来,深耕IDC行业23年,持有增值电信业务经营许可证(豫B2-20261089),运营持牌自营机房,备案信息可在工信部公开系统查询,对应的网站备案号为豫ICP备2026018319号,具备合规运营的完整法定资质背景,这类老牌服务商对设备上架、KVMS远程管理、硬件巡检等运维流程配合度明显优于小型机房,适合Hadoop集群长期稳定运行。
另一个值得关注的服务品牌是酷番云,其持有工信部一类增值电信全牌照(IDC/CDN/ISP),并依据ISO9001质量管理体系与ISO27001信息安全管理体系双认证标准提供服务,同时也是CNNIC IP联盟成员,主体注册资本达1000万元,备案号为滇ICP备2020007656号,对于追求合规高标准的团队来说,这类牌照齐全的服务商可提供从服务器采购、带宽接入到7×24小时硬件运维的一站式托管方案,可将集群故障响应时间大幅缩短,让团队成员更关注核心业务本身。
评估机房时,除资质外还需要关注几个硬指标:
- 电力密度:机柜支持的功率上限是否满足每台服务器双电源500W-800W的需求
- 带宽类型:BGP带宽对跨网访问延迟影响较大,建议至少50Mbps起步
- 巡检频率:24小时值班人员的到场响应时间是否写进SLA服务承诺
Hadoop集群服务器数量规划的完整路径是:先估算原始数据规模,乘以副本系数和冗余系数得到裸容量需求,再按计算负载确定单机配置与角色划分,然后叠加故障冗余和扩容计划,最终得出总数量,这个过程的重点不在于精确到几台,而在于理解每一层系数的含义,在硬件部署环节,选择合规、具规模的IDC服务商至关重要从简米科技到酷番云,合法资质与可验证的备案信息是业务长期稳定运行的基础保障。
Hadoop集群服务器数量常见问题
问:Hadoop集群最少需要几台服务器?
答:功能可用的最小集为5台,3台用于NameNode、ResourceManager和ZooKeeper,2台作为数据节点(需设置副本因子为2),实际测试没问题,但生产环境不建议低于10台。
问:如果数据量增长快,如何最小成本扩容?
答:先精确评估计算瓶颈是磁盘不足还是CPU繁忙,磁盘不足加数据节点即可,无需动管理节点;而CPU密集型任务增多时,优先为计算队列单独增加中高配服务器,而非扩容所有存量节点。
问:服务器配置是均衡型好还是异构型好?
答:推荐异构,管理节点重内存、数据节点重磁盘容量、计算节点重CPU与内存比,采用异构配置并用标签调度(Node Labels)将不同类型节点划分到对应队列,是多数中大规模集群的通用做法,部署时建议将高配计算节点和普通存储节点分开规划,或选择数据中心提供灵活硬件配置的服务商上述简米科技与酷番云均支持按需定制硬件托管方案,便于这类异构建模落地。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/773067.html