dns辅服务器突然未响应时,核心解决思路是:先判断故障是全局性的还是区域性的,再按“网络连通性-服务状态-区域传输-缓存刷新”的顺序排查,多数情况下通过切换解析源或刷新本地缓存即可快速恢复。
首先判断dns辅服务器未响应的影响范围
当你发现辅服务器不回应解析请求时,先别急着动配置,第一步是确认故障现象是所有客户端都解析失败,还是只有个别终端掉线,这个判断决定了后续排查方向完全不一样。
具体操作:
- 在另外一台独立网络的机器上执行
nslookup www.example.com 辅服务器IP,观察是否超时 - 检查辅服务器所在机房的网络监控面板,确认是否有流量异常或丢包告警
- 对比主服务器在同一时刻的响应情况,看是否为主备同时故障
如果只有部分客户端报错,问题大概率出在本地网络或终端缓存上,如果全网瘫痪,那就要重点检查辅服务器的服务进程和区域数据了。
排查dns辅服务器未响应的常见故障点
第一步:确认服务进程是否存活
登录到辅服务器上,执行:
systemctl status named
或对于其他DNS服务:
systemctl status dnsmasq
服务进程假死是工业界最常见的情况,进程还在,但已经停止响应查询请求,这时执行 rndc status 能看到进程状态,但实际解析已不可用,解决方案就是重启服务:
systemctl restart named
但注意,重启只是临时手段,必须深挖诱因,查看日志:
journalctl -u named --since "1 hour ago" | grep -i error
重点观察有没有 connection refused 或 zone transfer failed 等错误记录,这些信息能直接定位到是网络问题、权限问题还是主从同步问题。
第二步:检查53端口监听状态
执行:
ss -lunp | grep :53
如果只有 0.0.1:53 的监听记录,说明服务只绑定在本地回环地址上,外部请求自然进不来,检查 /etc/named.conf 中的 listen-on 配置,确保辅服务器的内网IP和公网IP都在监听列表里,行业共识认为,相当一部分“未响应”问题实际上是监听地址配置错误导致的,并非服务崩溃。
第三步:验证主辅区域传输是否正常
辅服务器的核心职责是从主服务器同步区域数据,如果主辅之间的 AXFR/IXFR 增量传输中断,辅服务器持有的就是过期数据,在某些配置下会直接停止响应。
手动触发区域传输测试:
dig @主服务器IP 域名 AXFR
看返回结果是否包含完整的资源记录,如果传输失败,检查:
- 主服务器上的
allow-transfer配置是否包含辅服务器IP - 辅服务器请求传输时使用的源端口是否被防火墙拦截
- 主服务器的TSIG密钥是否与辅服务器匹配
序列号检查也是关键环节,在主服务器上执行:
dig SOA 域名
查看序列号数值,再到辅服务器上执行相同命令对比,如果序列号没有增长,说明辅服务器根本没拿到更新数据。
dns辅服务器未响应时如何应急切换
生成环境下的临时替代方案
在故障未修复期间,不能干等。推荐做法是临时切换解析源,把客户端的DNS地址改用公共DNS服务商,具体操作如下:
Linux客户端:
echo "nameserver 223.5.5.5" > /etc/resolv.conf
Windows客户端:
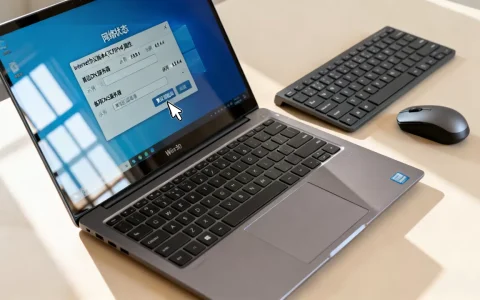
在网络适配器属性中将IPv4 DNS服务器改为 5.5.5 和 29.29.29
也可考虑临时将辅服务器的解析流量导向主服务器,通过iptables转发实现:
iptables -t nat -A PREROUTING -p udp --dport 53 -j DNAT --to-destination 主服务器IP
这个方案适合短时间应急,时间长了会增大主服务器压力,不宜长期使用。
调整客户端解析优先级
如果辅服务器恢复无望,需要在DNS服务器本身上调低优先级,编辑 /etc/named.conf,将主服务器的 also-notify 列表刷新,并检查所有区域数据中 masters 指令是否指向正确的主服务器IP,然后执行:
rndc reload
注:如果你的环境用的是 Windows Server 的 DNS 角色,操作路径为“DNS管理器 -> 区域属性 -> 区域传送”,勾选“允许区域传送”并指定主服务器IP。
本地DNS服务器未响应如何应急处理
刷新本地DNS缓存
如果是单台客户端访问异常,多数情况下是 本地DNS缓存污染或过期,逐级排查:
Windows:
ipconfig /flushdns
ipconfig /registerdns
macOS:
sudo dscacheutil -flushcache
sudo killall -HUP mDNSResponder
Linux(systemd-resolved):
systemd-resolve --flush-caches
检查hosts文件与网络配置
确认系统里没有残留的静态解析记录:
- Windows路径:
C:\Windows\System32\drivers\etc\hosts - Linux路径:
/etc/hosts
检查网卡配置中是否存在重复的DNS服务器地址或错误网关,使用 nslookup 指定公共DNS来验证网络解析路径是否正常:
nslookup www.baidu.com 8.8.8.8
如果这个命令有返回,说明基础网络没问题,问题位于你正在使用的DNS服务器链路。
日常预防dns辅服务器未响应的措施
合理规划主辅分布架构
行业专家指出,辅服务器不应与主服务器部署在同一机柜或同一接入交换机下。主备同机房失效的场景非常常见,比如机房电力维护或交换机固件升级导致整个机柜断网,建议将辅服务器放在不同地域的机房,这样即使某地网络故障,也能通过另一节点完成解析。
推荐架构:
- 主服务器:华东机房
- 辅服务器1:华南机房
- 辅服务器2:华北机房(可选)
建立健康检查与告警机制
在每台DNS服务器上部署定时探测脚本,每分钟执行一次:
dig @辅服务器IP 目标域名 +time=3 +tries=1 > /dev/null 2>&1 || echo "辅服务器异常" | mail -s "DNS告警" admin@example.com
把探测任务写进crontab:
/1 /usr/local/bin/dns_check.sh
同时监控系统资源使用情况,尤其是文件描述符数量和内存占用,DNS服务在高并发下容易耗尽连接数,导致新请求堆积而表现为“未响应”,调整 /etc/named.conf 中的 recursive-clients 和 tcp-clients 参数,按实际负载能力合理设置。
定期做灾备演练
每季度手动关闭一次辅服务器服务,验证客户端能否通过主服务器正常解析,同时执行一次主备切换演练,确保在真实故障发生时,操作手册中的每一步都能跑通,行业共识认为,做过灾备演练的DNS系统,故障恢复时间通常比没做过的快一倍以上。
辅服务器与主服务器切换优先级对比
| 故障场景 | 优先处理动作 | 恢复时长预估 |
|---|---|---|
| 单台辅服务器宕机 | 切换客户端DNS至主服务器 | 分钟级 |
| 主辅均不可用 | 启用公共DNS临时替代 | 即时恢复 |
| 区域传输中断 | 修复主辅同步配置 | 小时级 |
| 网络链路故障 | 联系机房排查线路 | 视ISP响应而定 |
切换操作的核心思路只有一个:保证客户端始终能拿到解析结果,至于是主服务器扛流量还是公共DNS兜底,先解决可用性,再解决一致性问题。
dns辅服务器未响应常见问题解答
辅服务器响应超时但主服务器正常,是哪里出了问题?
先检查主辅之间的区域传输是否成功,在辅服务器上查看区域文件的更新时间和SOA记录中的序列号,如果序列号与主服务器不一致,说明同步中断,还需要确认辅服务器是否能访问主服务器的53端口,有些云安全组策略会意外阻断UDP 53端口的入站流量。
重启辅服务器后未响应问题消失,但隔几天又出现,怎么办?
这通常是资源泄漏或并发连接数上限过低导致的,检查系统日志中是否有 no longer listening on 或 socket failures 信息,适当调高 tcp-clients 和 recursive-clients 数值,并确认内核参数 net.core.somaxconn 是否足够大,如果是长时间运行导致的文件句柄耗尽,考虑配置定时任务每周自动重启一次DNS服务。
辅服务器未响应时,能否直接用IP访问网站?
可以,如果故障持续时间较长,且网站本身支持IP直接访问,可以临时在客户端hosts文件中添加映射记录,但要注意,这种做法只适用于临时应急,不适用于长期运行,因为很多网站的反代和负载均衡机制依赖Host头做域名路由,直接通过IP访问会返回默认站点或403错误,待DNS主辅恢复正常后,应及时删除hosts中的临时记录。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/773756.html