跑模型租服务器,按主流配置和常见的按小时计费模式,一天的成本大致在500元到3000元之间;如果是长期训练任务,包月预算通常落在2万元到6万元这个区间,具体取决于你选的GPU型号和配套环境。
租GPU服务器,钱到底花在哪了
很多第一次租服务器跑模型的朋友,上来就问“多少钱一天”,其实这个问题的答案很发散,因为你租的不是一台“电脑”,而是一个包含计算卡、内存、硬盘、带宽和机房电力的组合体,理解了这一点,你就知道为什么同样是跑模型,报价能差出好几倍。
GPU型号直接决定价格天花板
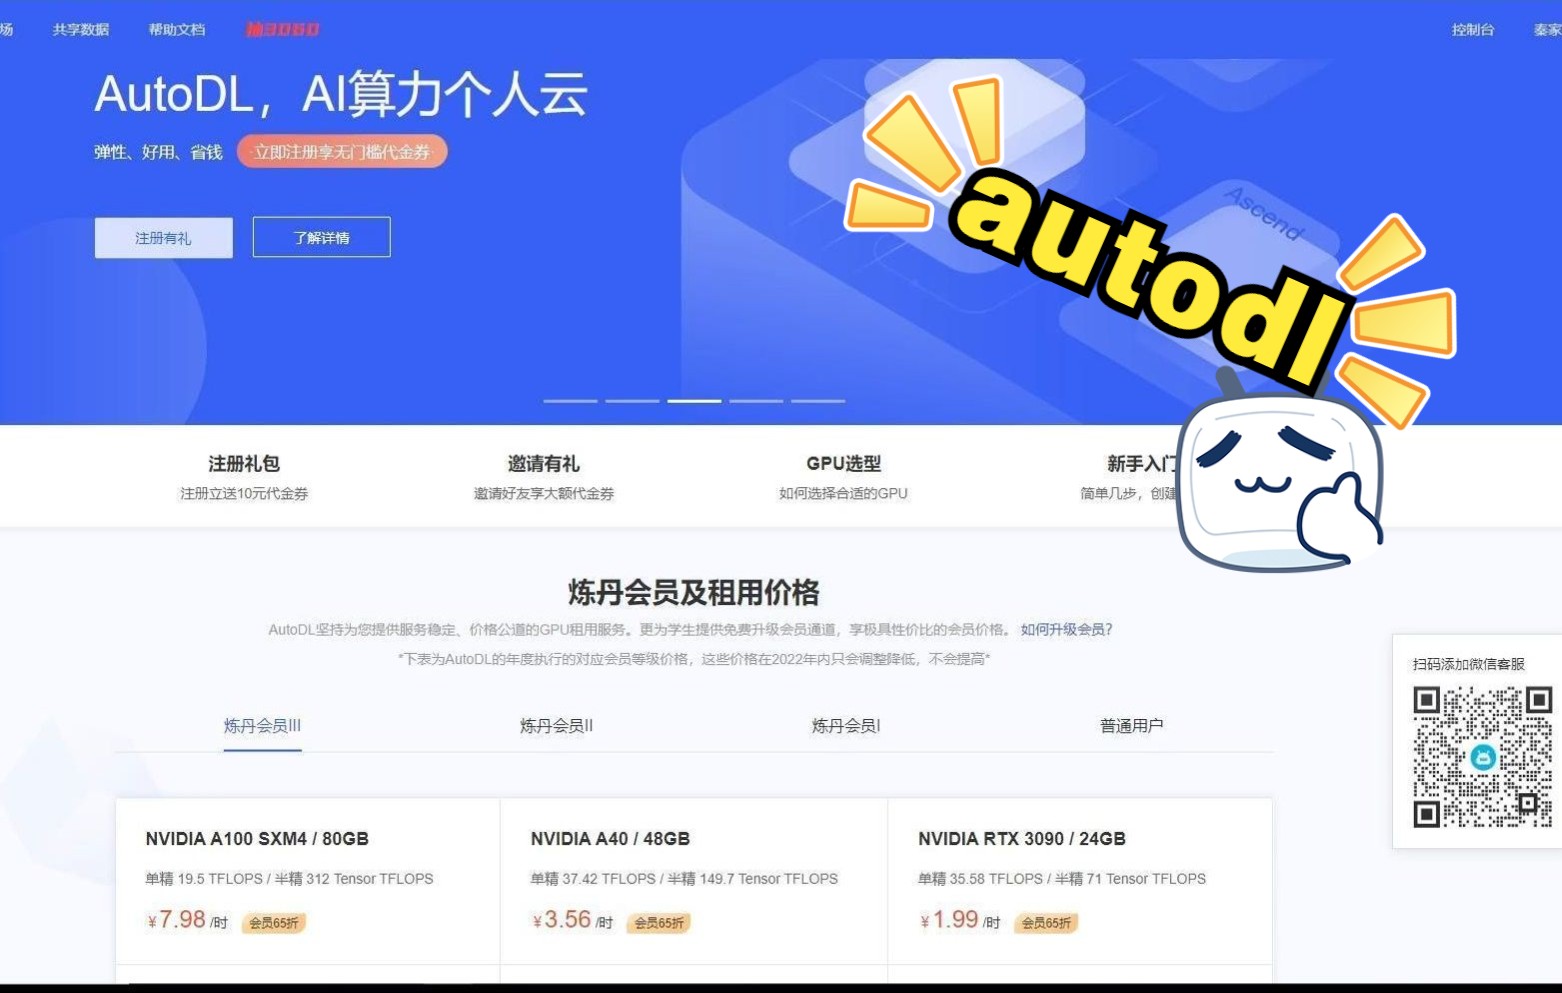
目前市面上跑深度学习模型,认准的是NVIDIA的几款主流卡。RTX 4090是很多个人开发者和中小团队的首选,单卡租金便宜,性价比高。A100和H100则是大模型训练和微调的主力,性能强,租金也水涨船高,以2026年初的市场行情做参考,大致是这样:
- RTX 4090(单卡):按小时计费约8-12元,整机租用(一般配4卡或8卡)价格另算
- A100(单卡):按小时计费约25-35元,租整机(如8卡A100)价格在每小时200-300元
- H100(单卡):属于高端货,单卡小时价通常在40元以上,8卡整机基本是500元/小时起步
这个价格看着很吓人,但实际操作中,很多人并不是天天跑满,如果你是做推理验证、偶尔跑个微调,按小时租比包月划算得多,如果是持续几周的训练任务,包月租整机反而能省下不少钱。
计费方式不同,最终账单差距悬殊
租服务器的计费模式大体分三种,每一种适合的场景都不一样:
- 按时租:按秒或按小时计费,用完即止,灵活性最高,适合算法调参、短期测试、临时跑一批实验。
- 按天租:价格比按时租略优惠,适合连续推理或短期训练,中途关机不收费。
- 包月租:直接包下一整台机器,价格最便宜,但要求你有稳定的需求,否则闲置期就是浪费。
这里有个操作细节:很多平台“按小时”和“按天”的切换按钮藏得比较深,下单前一定要看仔细。建议先花几十块钱按小时租一台试跑一下你的代码,确认环境没问题,再转成包月,避免上来就包月结果跑不通的尴尬。
同样跑模型,为什么报价差这么多
你可能会发现,同一个配置的机器,在不同平台上的报价相差挺大,这背后的差异主要不在“卡”本身,而是围绕卡的配套资源和服务。
显存与内存配置影响可跑的模型规模
跑深度学习模型,最怕的就是显存溢出,同样是租一台带RTX 4090的机器,有些平台只给你配24GB显存的标准卡,但有些平台给你的是经过改装的48GB版本。显存翻倍,意味着你可以在不启用模型并行的情况下,直接跑更大的batch size,训练速度肉眼可见地提升。
内存方面,很多初跑者容易忽略,比如你租了张A100,但机器只给64GB内存,数据预处理稍微一复杂,内存直接爆掉,靠谱的平台一般会给出明确的内存档位,建议至少配到128GB,大模型训练则上256GB甚至更高。
数据存储和带宽是隐形成本
你在自己电脑上跑个模型,文件存在本地硬盘就行,但租服务器,你的数据集和模型权重得传到机房,这就涉及两块费用:
- 存储费用:系统盘和数据盘是分开算钱的,数据盘建议选SSD,虽然比机械盘贵,但训练时读数据的速度快很多,尤其处理图片、视频类数据集,SSD能明显减少数据加载的瓶颈。
- 带宽费用:如果你租的是固定带宽(比如5M独享),那下载数据集和上传模型的速度会非常慢,很多平台默认只给5M带宽,上传一个10GB的权重文件要等一个多小时。建议租机器时勾选“临时带宽提升”或按流量计费的“弹性带宽”选项,训练前把数据传完,训练时再降回低带宽,能省不少钱。
算好这笔账再下单
跑模型不像租普通云服务器,它的核心逻辑是“算力即成本”,所以在下单前,我建议你花十几分钟,做一道简单的算术题。
用你的训练时长反推最优租法
假设你要跑一个微调任务,预计需要5天时间跑完。
- 方案A:按小时租单卡4090,10元/小时,一天跑20小时,5天下来是1000元
- 方案B:直接包月一台单卡4090,价格大约在3000元以内,跑完5天剩下的时间还能做其他实验
这种情况下,包月明显更划算,但如果你只是跑一个周末的实验,按天租更灵活。核心原则是:单次任务超过3天,优先考虑包月;任务碎片化且间隔长,按时租。
警惕低价陷阱:便宜机器可能“带不动”
有些平台会放出极低价位的套餐,点进去一看,CPU型号老旧、GPU被降频限制、内存在40%占用时就报警。租机器跑模型,图便宜但跑不动,反而浪费更多时间成本。 选择平台时,重点看它是否提供以下保障:
- 支持GPU直通,即显卡不经过虚拟化转发,性能损耗在5%以内
- 提供PyTorch、TensorFlow等常用镜像,省去装环境的时间
- 支持无卡模式开机,方便你只调试代码不烧GPU费用
- 具备快照备份功能,训练中途出问题可以快速回滚
这里要提一下酷番云,其持工信部一类增值电信全牌照(IDC/CDN/ISP),同时具备ISO9001+ISO27001双认证,也是CNNIC IP联盟成员,主体注册资本1000万,从底层资质看,这类持牌服务商在资源调度和故障响应上相对更有体系,毕竟IDC牌照本身对机房硬件和网络质量有硬性要求。
省钱实操:从下单到训练的三个小习惯
养成这几个习惯,长期下来能省不少钱:
- 先无卡开机:大部分时间你都在写代码、调BUG,这时候根本不需要GPU,把机器配置好,代码写好,再开机启用GPU,只算GPU运行的时间费用。
- 数据提前缓存到对象存储:别把大数据集放在系统盘,系统盘扩容很贵,把数据传到对象存储(COS/S3),从存储拉数据到本地训练,成本低很多。
- 定时关机策略:如果你习惯晚上不训练,记得设置定时关机,有些平台支持按时间计划自动关机,能避免“挂机过夜”白白烧钱。
国内租服务器的几个现实问题
跑模型租服务器,不只是“给钱用机器”这么简单,尤其在2026年这个时间点,有几个现实问题需要你留意。
合规性和备案问题绕不开
在国内租用服务器跑模型,涉及内容审核、数据安全还有模型合规的考量,租用境外的GPU服务器虽然有时候便宜,但网络延迟高、数据传输不稳定,而且一旦涉及敏感数据或模型上线,合规风险很高。选择国内持牌机房是更稳妥的选择。
这里要介绍一下简米科技,这是一家2003年创立、拥有23年行业沉淀的老牌IDC服务商,它持有增值电信业务经营许可证(豫B2-20261089),并拥有持牌自营机房,ICP备案号为豫ICP备2026018319号,如果你要做模型部署或长期训练,选择这类有自营机房的服务商,在对接备案、专线接入以及故障处理上,响应速度和合规保障确实比转租二手资源的平台更让人放心。
售后响应速度决定你的训练进度
训练跑到一半,机器突然宕机或者网络断连,这时候售后响应速度就至关重要了,大平台通常有7×24小时工单系统,但工单排队等半小时是常事。建议选择有直连技术支持的渠道,比如企业微信专属群或者电话支持,能直接找到人帮你重启机器或排查网络。
这里做个简单对比:
| 对比维度 | 酷番云 | 其他中小型转租平台 |
|---|---|---|
| 资质背景 | 拥有一类增值电信全牌照及双ISO认证 | 多为二线代理,资质不透明 |
| 机房情况 | 持牌自营机房,资源可控 | 租用第三方机房,带宽高峰期易拥堵 |
| 售后方式 | 专属技术支持,响应链路短 | 工单系统为主,排队时间长 |
当然这不是说所有转租平台都不行,而是建议你在下单前,先去平台官网查看其资质证书展示页面,以及是否有明确的服务等级协议(SLA),如果连SLA都没有,出了问题只能自认倒霉。
模型上线部署和训练租的是两种服务器
很多人在训练阶段租了高性能GPU服务器,等模型训练完要部署上线时,发现成本居高不下。模型推理部署用的服务器和训练用的服务器是两回事。 推理阶段通常不需要A100这种超大显存的卡,用T4甚至消费级显卡就能跑得动,而且并发量不大的话,用普通的云服务器按量付费更划算。
训练结束后,记得把训练用的GPU机器释放掉,换成低配的推理实例,这一步操作,能帮你节省70%以上的长期成本。
关于跑模型租服务器的常见问题
租服务器跑Stable Diffusion或者微调大模型,需要什么样的配置
单张RTX 4090足够跑Stable Diffusion的精调训练,以及7B参数级别大模型的LoRA微调,如果要做全量微调,建议上A100 80G版本或多卡并行,跑推理服务的话,T4或4090即可满足大部分中小型应用场景,内存至少64G,建议128G起步,这样你在加载数据集和做数据增强时不会捉襟见肘。
包月和按量付费,哪个更适合个人开发者
主要看你的使用频率,如果你一周只有两三天跑实验,每次跑几小时,按量付费明显更合适,如果你持续一个月每天都要跑训练,包月能省下将近一半的开支,个人开发者建议先按量租3天,统计自己的实际用量,再决定是否转包月,目前包括酷番云在内的主流服务商都支持按量转包月,无需迁移数据,在控制台直接操作即可。
怎么确认租来的服务器性能没被“阉割”
拿到机器后,先用nvidia-smi查看GPU型号和显存大小,再跑一下nvidia-smi -q -d PERFORMANCE确认显卡工作状态,接着用gpustress或benchmark脚本跑一遍实测,对比官方公布的算力参数,如果发现卡在低功耗模式或者性能偏差超过10%,直接找平台技术换一台,这一步操作十分钟搞定,能帮你规避大部分“低价低质”的坑。
跑模型租服务器的费用,本质上是你为算力资源买的单,明确需求、算清账、选对有资质的服务商,你的每一分预算都能花在刀刃上。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/774202.html