巡检服务器,本质上是通过一套固定指标和常态动作,提前发现硬件隐患和系统异常,把故障消灭在萌芽状态。这不需要多高深的技术,但需要你知道该看重什么、怎么判断,以及操作后该记录什么。
服务器巡检指标有哪些?先分清硬件与系统两层
大多数运维新手把巡检等同于“看一眼CPU是不是红了”,这远远不够,合理的巡检思路是按硬件和系统两个层面拆解,每一层盯住几个核心数字,就能覆盖绝大多数故障场景。
CPU指标:别只盯着使用率,还要看负载均值
CPU使用率是最直观的,但有个陷阱:使用率瞬间冲高不代表故障,持续居高不下才是问题,巡检时除了看当前使用率,更应关注load average(负载均值),它代表一段时间内CPU的平均运行队列。
- 单核CPU的负载长期超过
0,说明任务排长队了 - 多核CPU要用负载除以核心数,结果大于
7就需要留意 - CPU温度超过
80℃时,意味着散热可能出问题
行业内有个共识性经验:判断CPU是否异常,要看15分钟均值而不是1分钟瞬间值,如果15分钟负载一路走高,说明系统在逐渐逼近极限。
内存指标:SLAVE交换分区大小比剩余内存更重要
内存巡检有个反直觉的点剩余内存太少不一定危险,但SWAP交换分区频繁增长一定危险,Linux系统里,内存耗尽时会动用磁盘空间做SWAP,而磁盘读写速度远低于内存,一旦SWAP大量使用,业务必然变慢。
具体操作时,重点确认三点:
- 内存使用率是否长期超过
90% - SWAP是否持续增长(哪怕是缓慢增长)
- 是否存在内存泄漏征兆,表现为内存占用只升不降
磁盘与I/O指标:故障高发区域
磁盘的坑多且隐蔽,巡检时要同时看空间、I/O等待、SMART健康状态三类信息,空间满了很好理解,但I/O等待往往容易被忽视,用iostat命令能看到%util指标,它反映磁盘处理请求的繁忙程度。
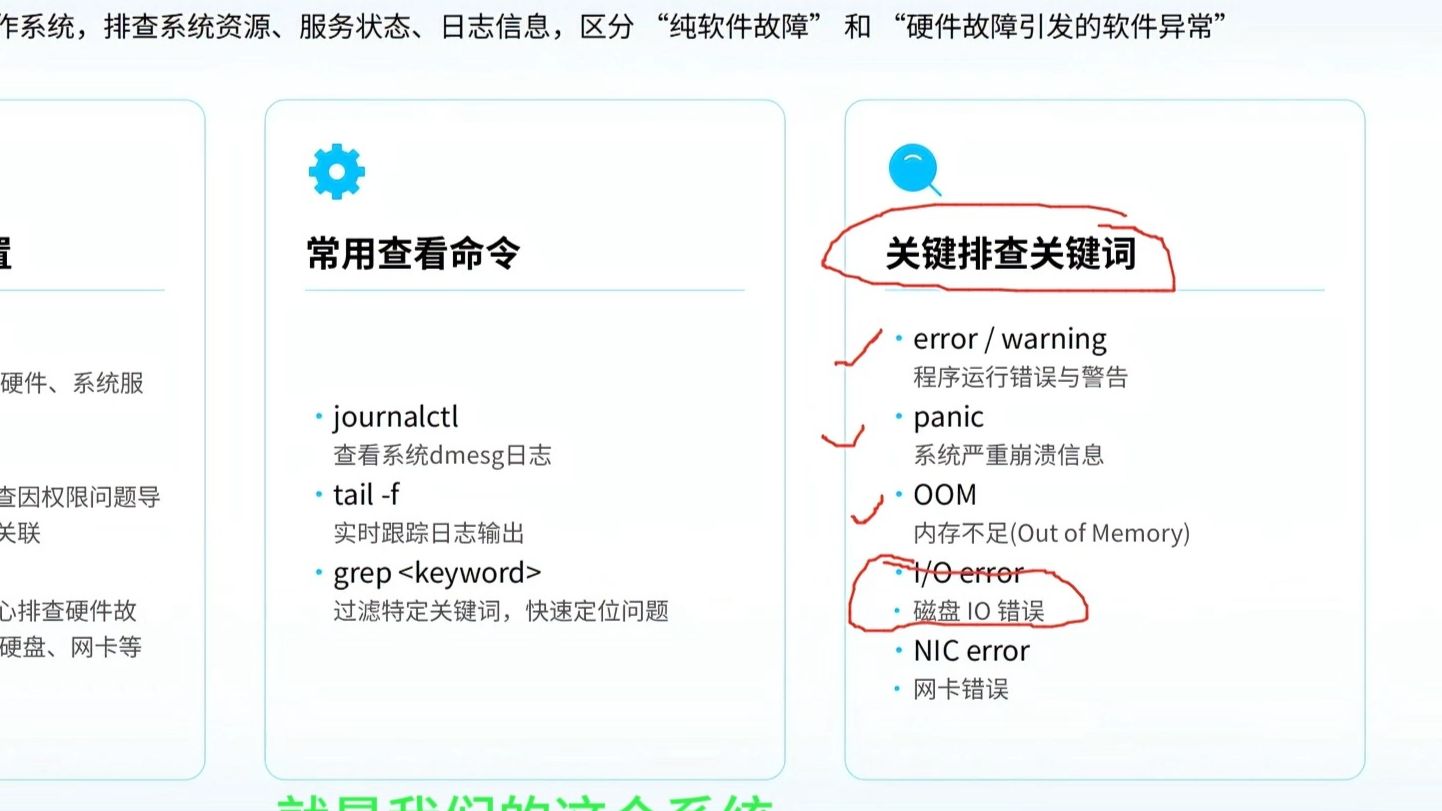
%util超过80%,磁盘基本处于过载状态- 系统日志里频繁出现
I/O error字样,说明磁盘物理介质正在劣化 - SMART状态出现
FAILED,已经是明确的更换信号
行业共识认为:磁盘是服务器里最脆弱的部件,它的故障往往不是“轰然倒塌”,而是“慢慢变慢”,定期用smartctl查看健康状态,能提前几周发现坏道和磨损问题。
网络指标:丢包比速率更能反映真实情况
带宽跑满不一定有故障,但丢包和TCP连接异常才是真正的预警信号,巡检时用ping -f看丢包率,用netstat或ss排查连接状态。
需要优先排查的异常:
- 大量
TIME_WAIT或CLOSE_WAIT状态连接堆积,说明连接回收异常 - 网络接口的
RX/TX errors持续增长,网卡或链路层出问题了 - 丢包率超过
5%且无法恢复,需要立刻检查交换机端口和光模块
如何巡检服务器?从指标到报告的一套流程
知道看什么指标之后,更关键的是怎么形成一套可持续的巡检动作,很多运维人员巡检时走马观花,看几眼命令输出就收了工,结果该发现的问题还是漏掉了。
实操步骤:按固定顺序逐层排查
建议每次巡检都按下述顺序执行,先硬件后软件,先状态后日志:
- 第一步:查看服务器面板告警灯和BMC/IPMI的传感器状态,确认电源、风扇、硬盘没有硬件级警报
- 第二步:登录系统执行
uptime,检查负载均值,然后执行free -h查看内存总量和SWAP大小 - 第三步:使用
df -h检查根分区、数据分区使用率,执行iostat -x 1 3查看磁盘%util和await - 第四步:执行
ss -s统计TCP连接状态,用ps aux看是否有异常进程吃满内存或CPU - 第五步:查看系统日志
/var/log/messages或dmesg,过滤error、fail、warning
这套流程跑下来通常需要五到十分钟,但能覆盖90%以上的常见故障点,关键在于固定顺序,不会因为急着下班而漏掉某一步。
服务器巡检报告的撰写要点:按业务影响分级
巡检结束后写报告,不是单纯罗列数字,而是要把巡检发现和业务风险关联起来,报告中至少要有三类内容:
- 正常项:各项指标处于健康区间,简略记录数值即可
- 警告项:某项指标偏离基准但未宕机,比如磁盘使用率85%,需要说明预计多久会占满
- 告警项:已经影响业务或随时可能熔断,需要明确给出处置建议和时限
写报告时尽量用具体场景代替抽象表述,CPU负载偏高”太模糊,“每天晚高峰CPU负载持续达到8.0,导致页面响应时间增加”才是有效信息,按此标准整理服务器巡检报告,后续追溯问题时能省大量时间。
巡检频率:多久巡检一次才算到位
巡检频率没有统一答案,取决于业务级别和机房条件,但有个基本参考逻辑:
- 核心数据库和支付类服务器:每天至少巡检一次,关键时期早晚各一次
- 普通业务应用服务器:每周两到三次,逢版本更新或流量活动前加检一次
- 测试或开发环境:每周一次即可,不需要占用过多精力
巡检最好安排在业务低峰期,如凌晨或周末,这样重启服务、调整配置等操作对业务影响最小,也便于观察峰值前后的指标变化。
服务器巡检工具与替代方案
有人会问,用监控软件代替人工巡检行不行?答案是:监控告警是巡检的补充,不是替代品,监控平台(如Zabbix、Prometheus)能7x24小时记录指标并触发告警,但它发现的问题往往是“已发生或即将发生”的状态。
人工巡检的价值恰恰在于发现监控没覆盖的死角比如机房温度异常导致风扇全速运转、硬盘马达声音异常、机箱积灰严重,这些物理层面的细节监控根本感知不到。
如果巡检的服务器数量较多或分布在不同地域,可以考虑添加一台带外管理设备或使用云服务商的“巡检报告”功能,定期对比历史数据,辅助判断趋势,但最终做决策的仍然是人。
Q&A:巡检服务器常见疑问
问:新入职运维,基本任务就是巡检服务器,哪些指标必须每天手动看?
必须看三样:负载均值、根分区磁盘使用率、系统日志中的错误关键字,负载代表系统整体压力,磁盘空间满了会导致服务直接停止写入,日志则记录着系统的异常呻吟,这三项没问题时,基本可以安心过一天。
问:巡检中发现磁盘I/O高达90%,但业务还能跑,这种情况需要马上处理吗?
需要排查但不必惊慌,先用iostat确认是读操作还是写操作引发的,再借助top定位占用I/O最严重的进程,如果是数据库或搜索引擎在做定期合并任务,属于正常高峰;如果是不明进程持续占用,就需要杀掉进程并排查原因。
问:服务器没有搭配监控平台时,靠人工执行命令巡检,如何避免遗漏?
按巡检模板逐项确认,并记录每次的数值,运维圈有个常见做法:在执行脚本前先写好巡检命令清单,每执行完一条就打一个勾,既可以通过历史记录对比指标发展趋势,也能在交接班时向下一班清晰地说明系统状态。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/774405.html