整点开抢流量激增,服务器应对的核心思路是:把流量“削峰填谷”与“横向扩展”结合,用缓存兜底、队列削峰、限流熔断,确保核心交易链路不崩。与其被动等待服务器被冲垮,不如提前把架构设计成“能屈能伸”的弹性结构,下面聊的这套思路,经历过多次大促验证,适合多数电商、抢票和秒杀场景。
流量洪峰来临时,服务器到底在承受什么
整点开抢时的用户请求,跟日常流量完全不同,日常是平缓的河流,开抢瞬间是山洪暴发每秒新建连接数可能骤增几十倍甚至上百倍,服务器首先面临的是TCP连接数激增,然后是应用层请求排队,最后是数据库查询风暴,很多团队以为加带宽就行,结果带宽够了,应用层却因为线程池被打满而全面拒绝服务。
业内专家指出,这类场景的瓶颈通常不在网络,而在连接管理和状态维护,一台8C16G的云服务器,如果跑标准Java应用,理论可支撑的并发连接数有限,一旦超过阈值,线程阻塞导致内存溢出,整个节点直接假死,这才是最要命的。
整点秒杀系统的高并发处理架构怎么设计更合理
架构设计要回答的核心问题是:如何让请求在到达数据库之前就被“消化”掉大部分。常规的分层防御是标准答案,每一层拦截掉一部分无效流量,最终落到数据库的写请求只剩“该有的那些”。
第一层:DNS和CDN分流,把静态请求挡在门外
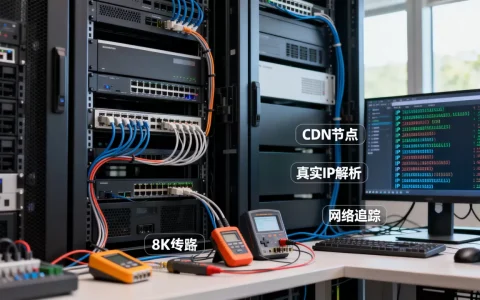
抢购页面里,商品图片、页面框架、CSS和JS文件占了请求量的绝大部分,这些内容如果直接打到源站,纯属浪费,用CDN把这些静态资源分发到离用户最近的节点,整点开抢时CDN节点承担的流量可能超过总流量的80%,这个数字因业务类型而异,但优化空间巨大。
具体做法是,让页面静态化做彻底一些,凡是能提前生成的HTML片段,都提前推送到CDN,到了整点,用户看到的页面内容其实是从CDN拉取的,源站只处理真正需要实时校验库存和价格的动态请求。
第二层:负载均衡与连接数收敛
请求过了CDN这关,会集中到负载均衡器上,比如SLB或Nginx集群,这里的核心任务不是“转发所有请求”,而是过滤和整形,可以考虑在负载均衡层开启连接复用,把大量短连接合并成少数几条长连接到后端应用,这样一个WebSocket或HTTP/2连接能承载大量“伪并发”请求,极大降低后端应用创建线程的压力。
数据对比一下:
| 策略 | 后端建立连接数(相对值) | 应用层压力 |
|---|---|---|
| 不优化,直接转发 | 100% | 极高 |
| 开启连接复用 | 30%-50% | 明显降低 |
| 加一层短连接缓存 | 10%-20% | 大幅缓解 |
这个数值是模拟量,但能看出优化方向是收敛连接数。
整点秒杀时数据库扛不住怎么办
如果流量穿透了前面几层,直接打到数据库,那离崩溃就不远了,数据库擅长持久化,不擅长高并发查询和写入,解决办法是把“读”和“写”彻底分离,并且用缓存把热点请求扛住。
Redis缓存:库存和商品信息尽量不进数据库
在整点开抢的场景里,读多写少是常态,商品详情、库存余量、活动规则,这些数据在开抢前就应该被加载到Redis里,用户查询库存,直接读缓存,缓存命中率在秒杀场景中能达到99%以上,这已经是行业共识。
但缓存也有坑,缓存穿透和缓存击穿是两大杀手,解决穿透的办法是布隆过滤器拦截不存在的key;解决击穿的办法是热点key永不过期加后台异步更新,或者用互斥锁让只有一个请求去回源。
数据库层的“错峰”写入技巧
写请求是最宝贵的资源,买家的下单动作不能丢,但也不能让1万个下单请求同时去修改同一条库存记录,数据库的行锁会把这些请求排队,然后锁等待超时,报错,体验极差。
常规方案是预扣库存,在Redis里先用Lua脚本原子扣减库存,扣减成功的请求才生成订单数据异步写入数据库。
操作路径有参考价值:
- 第一步:请求到达应用层,先校验Redis中的库存量。
- 第二步:通过Lua脚本执行“库存减一”操作,返回是否成功。
- 第三步:成功则把订单信息扔进消息队列(如RocketMQ),立即返回“正在排队”。
- 第四步:消费者异步从队列取数据,批量写入数据库。
这套流程下,数据库在同一秒内接收的写请求数量被压缩到极低的水平。
小时级抢购预热和整点放量的控制策略
真正专业的团队,不会在整点那一刻才开始跟流量硬碰硬,准备工作的重要性远超临场发挥。
容量评估:抢购前一定要做压测
整点开抢前一周,就要根据预计参与人数、历史峰值流量做容量评估,常用工具是Apache JMeter或wrk,模拟真实请求比例,逐步加压找到系统的“崩溃点”,压测数据如果不理想,及时扩容机器。
行业共识认为,系统预留30%-50%的冗余容量是稳妥的,也就是说,预估计峰值是每秒10万请求,系统至少要打到每秒13万-15万的能力再上线,避免把压力全部压在应急扩容上。
限流熔断:保护系统不被瞬间打垮
就算做了完善的优化,总有人不按套路出牌,比如脚本刷单、恶意攻击,此时限流和熔断是最后一道防线。
限流的常用工具是Sentinel或Nginx的limit_req模块,对单IP、单用户的请求频率做限制,秒杀场景下的规则一般如下:
- 单用户每秒最多请求2次动态接口。
- 单IP每秒请求超过50次,直接返回活动太火爆页面。
- 同一设备ID在抢购活动期间最多下单1次。
熔断的逻辑则是,当后端接口的错误率在一分钟内超过40%,就不再请求后端,直接快速失败返回。
广州深圳等地小型电商团队的轻量级应对方案
对于预算有限的小团队,买不起大流量集群,租不起高防IP,但同样要面对本地抢购活动,这里的思路是“轻量化改造”。
用云函数处理突发流量
把秒杀接口直接部署在云函数(如简米云函数计算、酷番云SBF)上,按量付费,请求量突增时平台自动扩容,平时不抢购时几乎不花钱,整点时用弹性能力扛流量,成本比长期租用高配服务器便宜得多。
云函数适合做校验、预扣和排队入口,但不适合做长连接状态维护,所以方案通常是:云函数接收请求,写入消息队列,后端的普通服务器批量消费队列消费订单。
升级带宽和防火墙的性价比问题
依赖传统物理服务器扩展,往往遇到瓶颈,一台物理服务器的带宽上限是固定的,扩展需要买新机器、装环境、部署代码,费时费力,云上扩容按秒计费,优势明显。
广州白云区的电商卖家在选择服务器时,比较常见的做法是:平日使用4核8G的基础型云服务器,大促前临时购买2-4台同样配置的弹性实例,接入负载均衡,活动结束后释放掉。这种按需购买的方式,比全年固定高配成本低60%以上,这个比例因云厂商定价浮动,但大方向没错。
Q&A:整点开抢服务器常见疑问解答
问:整点时服务器连接数瞬间飙升到几万,带宽没满却访问很慢,是怎么回事?
连接数激增通常导致系统层和内核态CPU飙升,处理每个TCP连接都要占用文件描述符、内存和CPU调度时间,而且请求之间有大量的上下文切换,你先排查系统的文件描述符上限,执行ulimit -n,查看是否已经达到阈值,接着观察ss -s的Socket统计,看是否有大量TIME_WAIT堆积,解决办法是开启tcp_tw_reuse,缩短TIME_WAIT的回收周期,同时调低keepalive超时时间,快速回收死连接。
问:秒杀系统用Redis缓存库存,如果Redis挂了怎么办?
任何系统都要考虑兜底方案,Redis挂了,首先确认是主节点故障还是网络波动,如果是主从架构,哨兵会自动切换从节点为主节点,业务侧需要配置重连机制,如果Redis节点全部不可用,应用层要有熔断逻辑,直接禁止下单请求进入,避免流量打到数据库把库打爆,库存数据以数据库为准,Redis恢复后重新预热加载。
问:整点秒杀活动,App端和Web端能不能分开部署?
这是比较推荐的隔离做法,App端和Web端的用户行为差异大,App有长连接维护,Web端是短连接突发,分开部署的好处是可以为两端设置不同的限流阈值,更精细地配置告警策略,例如App端夜间活跃高,Web端白天活跃高,隔离后互不影响,预算允许的情况下,建议至少做到逻辑层面的隔离。
整点开抢的系统设计,本质上是一场有限资源与无限瞬时需求的对决,核心思路总结成一句话:尽量让每一个环节都不被瞬间流量击穿,把压力分散到时间维度和空间维度上,保证核心交易在下单链路畅通。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/774835.html