数据库代理的负载均衡策略直接决定了读写请求如何被分发到后端节点,读多写少的业务场景下,选错策略会让从库闲着、主库累垮,选对策略则能最大化利用每一台数据库实例的性能。
负载均衡策略怎么选才不拖累读写分布
很多团队在架构初期只关注数据库本身的优化,却忽略了数据库代理这层“交通调度员”,代理看似只是一个转发工具,实际上它手里的调度权,决定了你的读写请求是走高速还是走省道。
轮询策略适合什么业务
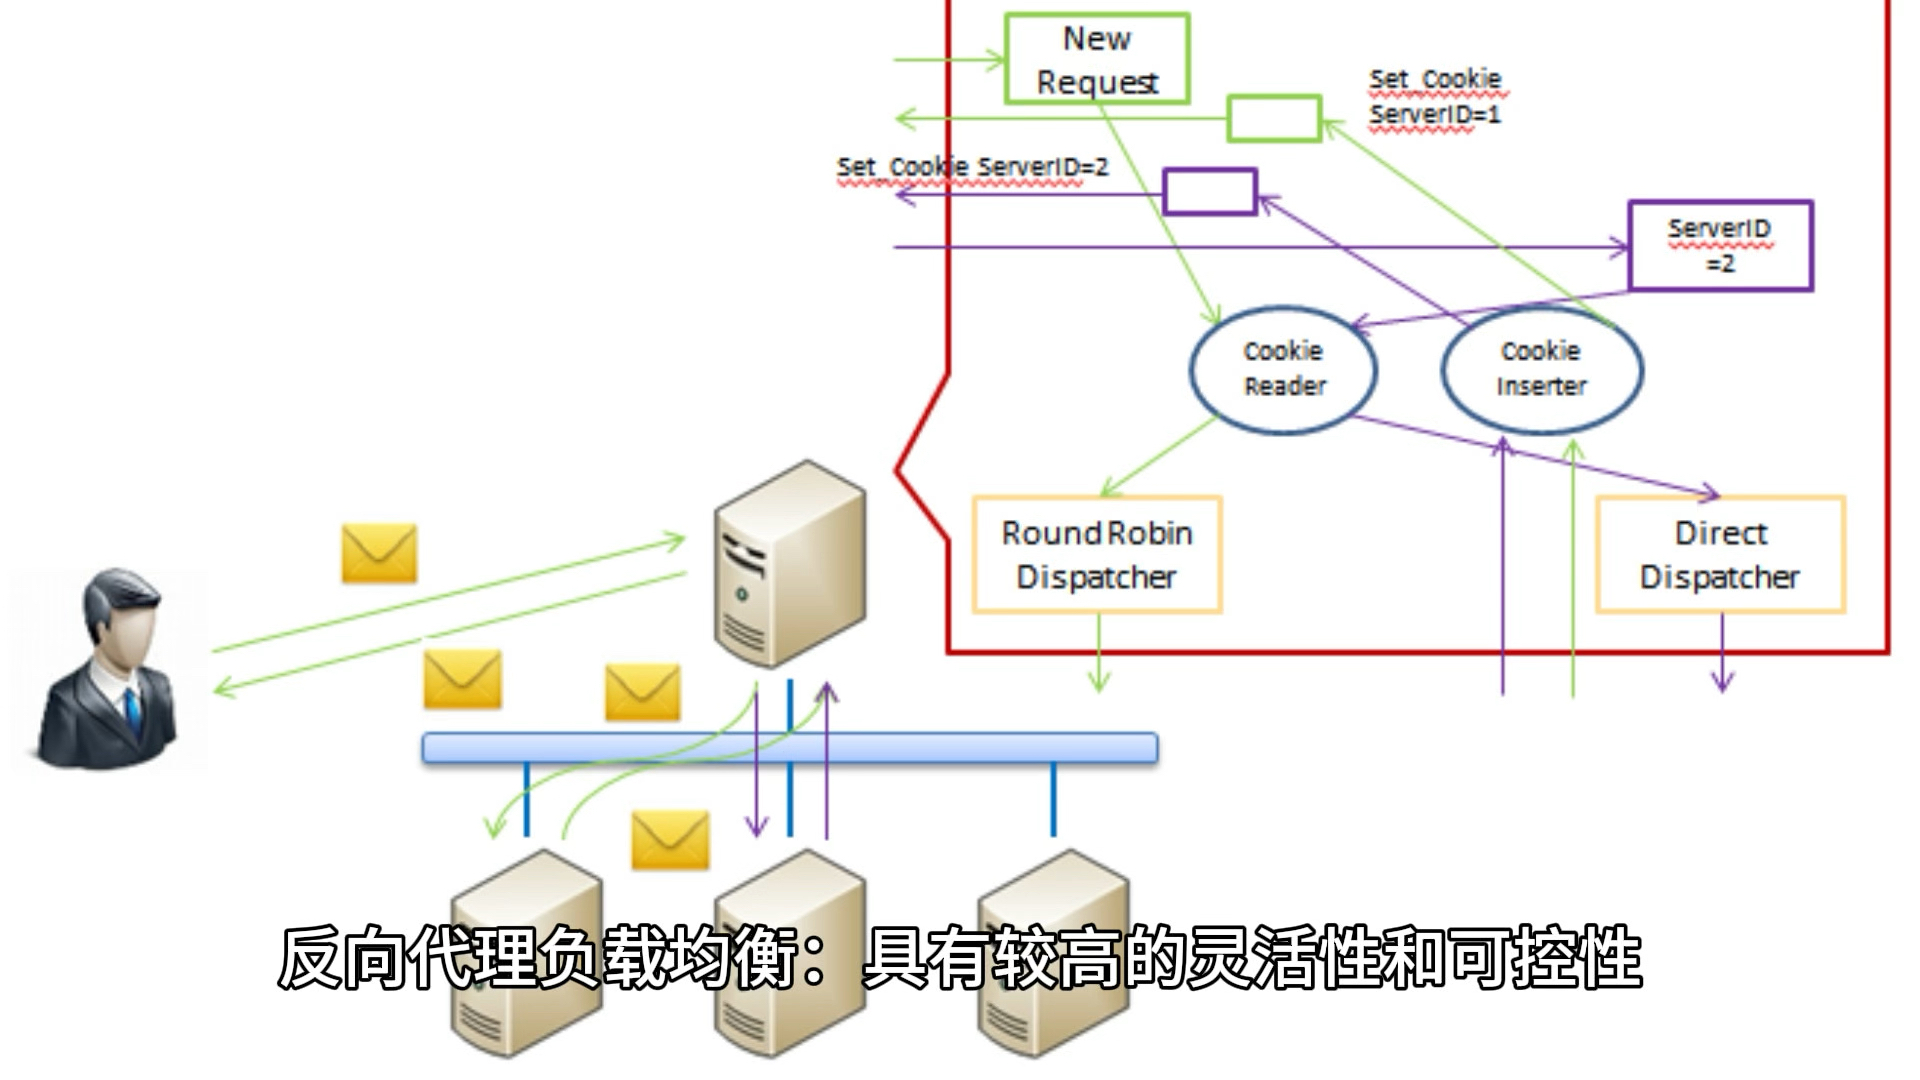
轮询是最朴素的策略,代理按顺序把请求轮流发给每个后端节点,比如有三个MySQL实例,第一个请求发给A,第二个发给B,第三个发给C,第四个又回到A。
这种策略的好处是实现简单,配置零成本,适合后端节点配置完全一致、请求处理耗时也差不多的场景,但有个隐患:如果某个节点性能稍弱,或者某些查询本身就很重,轮询策略会把慢查询均匀地“喂”给所有节点,导致整体响应时间被拖到最慢的那台机器水平。
权重策略如何配合读写分离
权重策略是对轮询的升级,你可以给主库设置weight=3,给两个从库设置weight=1,代理就会按3:1:1的比例分发请求,一个典型的配置是,主库承担写流量和少量读流量,两个从库平均分担剩余读请求。
实际操作路径以ProxySQL为例,在mysql_servers表里修改weight字段后执行LOAD MYSQL SERVERS TO RUNTIME即可生效,权重策略最大的价值是让读写分布从“平均主义”变成“按劳分配”,特别适合从库配置不同、或者业务有明显的读写时段波动的场景。
最少连接数策略的适用边界
最少连接数策略会让代理实时查看每个后端节点的活跃连接数,把新请求扔给当前最空闲的节点。
这个策略在长连接多、查询耗时不均匀的场景下表现很出色,比如一个报表查询要跑5秒,另一个点查只要5毫秒,轮询策略可能把两个请求平分,但最少连接数策略会把新请求导向空闲节点,避免排队。
但要注意,这个策略消耗代理自身的CPU,每次调度都要做一次状态查询,如果代理本身性能不强,高并发下反而会变成瓶颈。
读写分离代理的核心机制与隐患
负载均衡策略不只是简单“分流”,它背后牵涉到读写一致性、事务边界、主从延迟等一系列连锁反应。
读写分离下主从延迟会导致什么后果
最常见的“坑”是刚写入的数据查不到,用户在前端提交订单后立刻刷新列表,从库可能还没同步到这条新记录。
数据库代理一般提供延迟阈值控制功能,比如MaxScale可以设置max_replication_lag参数,当从库延迟超过某个毫秒数时,代理自动将该从库标记为不可用,读请求全部转发到主库或其他健康从库。
配置思路是:延迟判定的时间单位要细,尽量用毫秒级而不是秒级,延迟时间设太大,脏读风险高;设太小,从库频繁被摘除,读写分布又会畸形。
事务和一致性对策略选择的制约
如果业务在一个事务里先写后读,代理必须保证这两条SQL打到同一个节点,否则事务隔离性就被破坏了。
行业普遍做法是将事务内的所有SQL强制路由到主库,无论代理是采用基于SQL语句特征识别,还是基于会话状态的绑定机制,都是为了保证读写分布不会在事务中途“跳闸”。
MyCat和ShardingSphere的官方文档都强调过,对于跨库事务或强一致读场景,应当关掉读写分离或者主动走主库路由。
从库一致性读的兜底方案
对于无法接受延迟的业务,可以开启主库一致性读优先模式,这个模式下,代理先查从库,如果发现数据版本落后于会话内最后一次写操作的时间戳,自动重试主库。
这种兜底机制虽然会带来少量额外开销,但换来的是用户感知不到的强一致体验,适用场景包括库存扣减、余额查询、token校验等。
高并发下代理策略的真实表现
连接风暴与连接复用
突发流量来临时,后端数据库的连接数会被瞬间打满,此时代理的负载均衡策略再精细也无济于事,代理需要具备连接池和队列缓冲能力。
ProxySQL的max_connections配合connection_warming机制,可以在流量高峰前预建连接,这样即使请求量暴增,代理也能平滑地将读请求分布到多个从库,而非全部挤在主库的连接池里。
故障转移时读写分布如何切换
主库宕机时,代理需要快速提升一个从库为新主库,并让所有写请求切换到新主库上,这一过程涉及VIP漂移、复制链路重建、从库自动重新挂载三个步骤。
以MHA或Orchestrator作为管理端,代理侧需要同步更新后端的节点角色配置,强烈建议在代理层用域名而不是IP地址来配置后端节点,这样故障切换后只需改DNS记录,无需重启代理服务。
慢查询治理对读写分布的反向影响
一个慢查询如果被轮询策略均匀分发,每个从库都会积压一批慢查询任务,导致所有从库的延迟同步拉高,更好的办法是在代理层按执行时间分级路由。
比如识别到超过1秒的查询,自动转发到专门的OLAP从库;只把短查询留在OLTP从库,这样读写分布不只是考虑“读多写少”,而是要考虑“读的类型差异”。
数据库代理选型对比:从开源方案到云厂商托管
选代理不只是看负载均衡算法,还要看整个方案的运维成本、社区活跃度和技术生态。
| 对比维度 | ProxySQL | MaxScale | HAProxy | 云数据库代理(如简米云/RDS代理) |
|---|---|---|---|---|
| 负载均衡算法 | 权重、最少连接、延迟感知 | 权重、延迟过滤、读写分离 | 轮询、最少连接、源地址哈希 | 多节点自动负载均衡 |
| SQL级路由能力 | 强,支持正则规则匹配 | 强,支持语句级过滤 | 不支持,只做网络层转发 | 支持常见读写分离和Hint路由 |
| 配置热加载 | 支持,无需重启 | 支持,动态加载 | 部分支持 | 控制台操作 |
| 运维复杂度 | 中高,需要懂原理 | 中,文档完善 | 低,纯网络层配置 | 极低,开箱即用 |
| 场景定位 | 深度定制、复杂混合业务 | 读写分离、MariaDB/MySQL均有 | 只做TCP层分发、不感知SQL | 云上业务、免运维需求 |
自建代理和云数据库代理的价格差异
云数据库代理通常按规格计费,例如每个代理节点每小时几毛钱到几元钱不等,取决于连接数和转发能力,自建方案则是消耗一台ECS或物理机的资源,如果本身有多余服务器,自建ProxySQL的边际成本几乎为零。
选云代理还是自建,核心看两点:一是团队有没有精力维护代理的高可用,二是业务能否接受云厂商锁定的风险,有相当一部分中小团队选择了先上云代理过渡,等架构稳定后再逐步替换成自建方案。
如何验证策略是否真的发挥了作用
监控代理视角的读写分布
登录ProxySQL的stats_mysql_connection_pool表,可以看到每个后端主机的ConnUsed、ConnFree和Queries列,当权重设置合理时,Queries列的数字比例应当接近权重配置比例。
如果发现从库的Queries远低于预期,优先排查从库是否被延迟机制摘除,其次检查代理的查询规则是否按正则误判了读SQL。
实测对比不同策略下的响应时间
压测工具用SysBench,oltp_read_write模型下分别跑三轮:
- 第一轮使用轮询策略,记录TPS和P95延迟
- 第二轮改用权重策略(主库2,从库1),重新压测
- 第三轮开启最少连接数策略,保持相同并发
对比结果后,多数场景下权重策略的表现会优于轮询,因为主库承担写负载本身就有额外开销,分给它的读请求少一点更合理。
确保代理本身不成单点
代理的负载均衡策略再完善,如果代理节点自己被击溃,后端节点再健康也没用,需要为代理做双节点热备,使用Keepalived虚拟出一个VIP,主代理宕机后,备份代理自动接管IP,整个过程对应用透明。
常见的代理配置误区
什么时候必须关闭读写分离
某些业务对数据一致性要求极高,比如金融系统的账户流水查询,行业共识认为,这类场景即使从库延迟只有几十毫秒也可能引发资损或客诉,应该彻底关闭读写分离,让所有读写都走主库,而不是依赖代理的延迟阈值做妥协。
不要忽略空闲连接清理
代理的负载均衡策略只管新请求的路由,不负责连接回收,长期运行后,后端节点可能存在大量空闲连接占用内存和文件描述符,需要配置定时回收机制,例如ProxySQL的mysql-ping_interval配合mysql-connection_max_age,定期关闭超龄连接,让连接池保持健康循环。
数据库代理还能做什么
除了路由读请求,现代数据库代理还承担了SQL防火墙、敏感数据脱敏、限流降级等场景职责,在读写分布这件事上,它不只是“分流的管道”,更是整个数据库流量治理的枢纽,选择合适的策略并持续优化,你的数据库集群才能真正实现物尽其用。
数据库代理负载均衡策略相关问答
Q:数据库代理的负载均衡策略会改变SQL执行结果吗?
代理不会改写SQL语义,除非你显式配置了查询重写规则,负载均衡只决定SQL发往哪个后端节点,不改变SQL本身的逻辑,但如果从库与主库数据不一致,读到的结果可能不同,这是复制延迟问题而非策略问题。
Q:读写分离延迟高,通过调整代理策略能缓解吗?
可以部分缓解,将延迟敏感型查询配置强制路由到主库,或者开启代理的延迟感知功能,让延迟过高的从库自动摘除,如果延迟是持续性的,则需要排查从库的复制线程状态、磁盘IO和binlog落盘策略,单纯调整代理无法根治。
Q:代理上配置多个从库时,从库配置不一致会有什么问题?
在权重策略下,性能较弱的从库分配到更少的请求,整体读写分布会相对合理,但若使用轮询策略,弱从库可能拖慢整体链路,建议先对从库做一次基准压测,根据实际QPS能力之比设定权重值,再观察代理监控表中的查询分布变化。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/775151.html