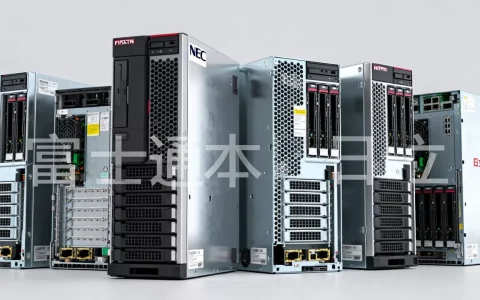
算力服务器不是单一产品,而是一整条按芯片架构、外形形态和使用场景划分的硬件谱系。 简单说,它主要包括GPU服务器、CPU服务器、ASIC/FPGA/NPU等专用加速服务器,再按机架式、刀片式、整机柜和边缘形态落地,最终对应训练、推理、通用计算和存储等不同任务。
算力服务器包括哪些类型?先按芯片架构分一遍
芯片决定了一台算力服务器的“性格”,同样是2U机箱,插满GPU和插满CPU,能干的事完全不同。
GPU算力服务器:训练和推理的主力
GPU服务器是当前大模型算力市场里存在感最强的一类,它靠大量并行核心处理矩阵运算,适合深度学习训练、推理、渲染和科学计算。
常见配置有单机4卡、8卡,主流整机以8卡为主,卡型覆盖NVIDIA的A100、H100、H200、B200以及L40S等,国产方向有昇腾、海光DCU、寒武纪等,选择时别只盯着卡的数量,显存容量、卡间互联带宽、主机PCIe通道数往往更决定实际效率。
一台8卡训练整机通常还会配双路服务器CPU、大容量内存、多块NVMe SSD,以及InfiniBand或RoCE高速网卡,业内专家指出,GPU服务器“买得起但跑不满”的情况,多数出在网络和存储没跟上。
CPU算力服务器:通用计算和调度不能少
CPU服务器是最容易被忽略的一类,它承担数据预处理、任务调度、Web服务、数据库、虚拟化,以及GPU集群的“头节点”角色。
典型配置是双路Intel Xeon或AMD EPYC,核数从几十核到上百核,内存从几百GB到数TB,国产路线有鲲鹏、飞腾等,很多AI集群里,CPU服务器数量并不少,只是不站在聚光灯下。
ASIC、FPGA、NPU等专用加速服务器
这类服务器为特定负载定制,能效比高,但通用性弱。
- NPU服务器:面向神经网络推理和训练,典型如昇腾系列。
- ASIC服务器:谷歌TPU是代表,国内也有面向视频转码、推荐推理的定制芯片方案。
- FPGA服务器:适合低延迟推理、网络加速、金融风控等可编程场景,卡型如AMD Alveo、Intel Agilex。
四类算力服务器横向对比
| 类型 | 擅长任务 | 优势 | 主要限制 |
|---|---|---|---|
| GPU服务器 | 大模型训练、推理、渲染 | 生态成熟、并行算力强 | 功耗高、采购成本高 |
| CPU服务器 | 通用计算、调度、数据库 | 通用性强、成本可控 | 并行浮点算力有限 |
| NPU/ASIC服务器 | 特定模型推理、视频处理 | 能效比高、单位算力成本低 | 生态适配成本高 |
| FPGA服务器 | 低延迟推理、网络加速 | 可编程、延迟低 | 开发门槛高 |
从外形和部署方式看,算力服务器还有哪些形态
芯片之外,机房怎么放、电怎么供、热怎么散,决定了另一套分类方式。
机架式服务器:最常见的选择
1U、2U、4U是标准机架单位,推理场景多用1U到2U,训练整机常见4U或8U,采购时先确认机柜深度、电源接口和承重,别等设备到货才发现塞不进去。
刀片式与高密度服务器
刀片服务器把计算、网络、存储做成刀片插进机箱,共享电源和散热,密度高、布线少,适合集群规模大、机房空间紧张的场景,缺点是前期投入高、异构卡型选择相对少。
整机柜与超节点
整机柜方案把数十张加速卡通过高速互联做成一个逻辑单元,典型如NVL72这类超节点形态,它解决的是“卡多了之后互联成瓶颈”的问题,适合万卡级训练集群,代价是对供电、液冷和机房改造要求高。
边缘算力服务器
边缘服务器通常深度更短、宽温设计、噪音和功耗受控,放在园区、门店或基站侧,做视频分析、工业质检等低延迟推理,它和机房里的训练服务器是两种设计思路。
GPU算力服务器和CPU服务器有什么区别
这是采购时问得最多的一组对比,区别不只在价格,而在“适合干什么”。
- 并行度:GPU有数千个计算核心,适合矩阵乘加;CPU核心少但单核强,擅长逻辑控制和串行任务。
- 显存与内存:GPU靠显存吃饭,大模型参数直接吃显存;CPU靠系统内存,容量大但带宽低。
- 互联方式:GPU之间有NVLink、NVSwitch,跨机走InfiniBand;CPU之间主要靠PCIe和以太网。
- 功耗与散热:8卡GPU整机功率可达10kW量级,普通CPU服务器通常在一两千瓦级别,机房条件完全不同。
- 成本结构:GPU服务器贵在卡,CPU服务器贵在整机规模和内存。
一个实用判断:任务能拆成大量相同的小运算,优先GPU;任务逻辑分支多、依赖数据库和调度,CPU更合适,多数AI集群是两者混部,不是二选一。
训练大模型需要什么样的算力服务器配置
场景落到训练,配置清单会变得很具体,以下是一台8卡训练节点的常见检查项。
- GPU与显存:优先看单卡显存和卡间互联带宽,其次才是峰值算力。
- CPU:双路高核数处理器,负责数据加载和预处理,别成为瓶颈。
- 内存:容量建议不低于单机显存总和的1.5到2倍,具体看数据管道。
- 本地存储:多块NVMe SSD做数据缓存,分布式存储走高速网络。
- 网络:参数面用InfiniBand或RoCE,存储面和业务面分开,避免互相抢带宽。
- 供电与散热:确认机柜功率上限,高功率整机通常需要冷板液冷或专项改造。
上机后可以用几条命令快速验证:
nvidia-smi查看卡数、显存和驱动状态;nvidia-smi topo -m查看卡间互联拓扑,确认NVLink是否正常;lspci | grep -i nvidia确认PCIe设备识别;ibstat检查InfiniBand端口状态和速率;ipmitool sensor读取进风口温度和风扇转速。
训练任务跑得慢,先查这三处:卡间互联是否降速、网卡是否跑在低带宽模式、数据加载是否卡在存储,多数情况下,问题不在算力本身。
算力服务器价格大概多少钱一台
价格跨度很大,直接报一个数没有意义,按档位看更实际。
- 入门推理型:单卡或双卡GPU、普通机架式,整机数万元起,适合小模型推理和视频分析。
- 主流训练节点:8卡整机,价格从几十万元到上百万元不等,卡型、显存和互联方案是主要变量。
- 整机柜与超节点:按柜计价,投入达到数百万元量级,还要叠加机房改造和液冷成本。
- 国产加速卡方案:单位算力价格通常更有优势,但软件适配和迁移成本要算进去。
除硬件外,别忘了电费、机柜租金、网络带宽和运维人力,行业共识认为,三年周期里电费和机房成本能占到总拥有成本的相当一部分,采购时只看设备报价容易漏算。
北京算力服务器租用还是采购,怎么选
地域差异主要体现在机房资源、电价和网络出口上,以北京为例,核心城区机房资源紧张,周边区域和京津冀集群更常见。
适合租用的情况:
- 项目周期短于一年,或算力需求波动大;
- 团队没有机房运维能力;
- 需要快速拿到卡做验证,不想等采购交付。
适合采购的情况:
- 长期稳定使用,且数据合规要求设备自主可控;
- 有自建机房或长期机柜资源;
- 需要对硬件做深度定制和调优。
不管租还是买,签约前确认三件事:实际可用卡数而非“理论卡数”、网络带宽是否独享、故障响应时限写进合同,北京地区选服务商时,优先看机房是否具备高功率机柜和液冷改造条件,这直接决定后续能不能扩容。
算力服务器包括哪些?常见疑问解答
问:算力服务器和普通服务器到底差在哪?
差在加速卡、供电散热和网络,普通服务器以CPU为核心,算力服务器围绕GPU或专用加速卡设计,卡间互联、电源冗余和散热能力都按高功率密度重新做过。
问:一台算力服务器能同时做训练和推理吗?
能,但不划算,训练卡跑推理利用率偏低,推理卡跑训练显存和互联又不够,多数团队会分开部署,训练集群和推理集群各自选型。
问:国产算力服务器能替代进口方案吗?
在推理和部分训练场景已经可以落地,关键看软件栈适配,迁移前先做模型兼容性验证,再评估算子覆盖和通信库支持,最后才谈规模化替换。
算力服务器的分类逻辑,说到底就是“芯片决定能力、形态决定部署、场景决定配置”,先把这三层想清楚,再去看具体型号和报价,选型就不会跑偏。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/776423.html