Kubernetes 里跑数据库这类有状态服务,备份和副本一致性就是命门备份解决“数据丢了能找回”,副本一致性解决“数据找回时不能是乱的”,两者缺一不可。
为什么有状态服务的备份比无状态难这么多
无状态服务挂了就重启,数据不在本地,副本之间随便同步,有状态服务完全是另一回事,以分布式数据库为例,一个节点上可能同时存着 WAL 日志、数据文件、索引文件,还有正在执行的事务状态,如果对副本的读取顺序和写入顺序控制不好,主节点和从节点看到的数据就会出现版本错位。
行业共识认为,有状态服务的副本一致性本质上是在回答三个问题:写操作以哪个副本为准、读操作能从哪些副本读、节点故障后数据如何追平,这三个问题处理不好,备份恢复出来的数据可能是一堆“半成品”文件。
备份不是复制文件那么简单
很多人以为备份就是把数据目录 tar 打包,或者用存储卷快照拍一张,这种方式对于单机应用勉强能用,但放到有状态服务的分布式架构里,就会踩坑。
原因在于,有状态服务的状态不仅有磁盘上的静态文件,还有内存中的动态状态,比如正在执行的分布式事务、尚未落盘的写入缓存,这些状态在文件系统快照里根本看不到。
- 如果只备份数据文件,不备份事务日志,恢复时会丢最后一段时间的增量数据
- 如果只备份主副本,不协调从副本的位点信息,恢复时可能连主从对齐都要重新做
副本一致性直接影响恢复时间目标
实践中经常看到这种情况:主节点故障后,运维人员从备份里恢复数据,结果发现恢复出来的数据还没从节点上的数据新,这时候只能做全量重放,恢复时间目标(RTO)被拉长到小时级甚至天级,业内专家指出,有状态服务的恢复时间长短,通常取决于副本之间的一致性能做到什么程度,而不是取决于磁盘有多快。
有状态服务副本一致性的底层原理
理解副本一致性,需要从复制协议说起,当前主流的分布式存储系统,etcd、ZooKeeper、TiKV,大多数采用 Raft 协议或者类似 Quorum 机制的方案。
Quorum 机制与数据安全
Quorum 机制的核心是“多数派确认”,在一个三节点集群中,写入操作至少需要两个节点确认才算成功,读取操作也需要凑够多数派节点,才能保证读到最新数据。
- 三节点集群容忍一台故障
- 五节点集群容忍两台故障
- 备份恢复时,同样需要遵循 Quorum 规则,才不至于恢复出一个“少数派”的分区数据
如果备份工具直接从某个落后的副本上拉数据,恢复出来的就是陈旧数据,这也是为什么很多数据库的备份工具要求从 Leader 节点或者同步副本上执行备份,保证备份数据的位点足够新。
日志复制与持久化层的一致性
日志是副本一致性的关键载体,每一次写操作都先记录日志,然后通过日志复制到其他副本,副本之间按照日志的索引顺序回放,才能保证数据一致。
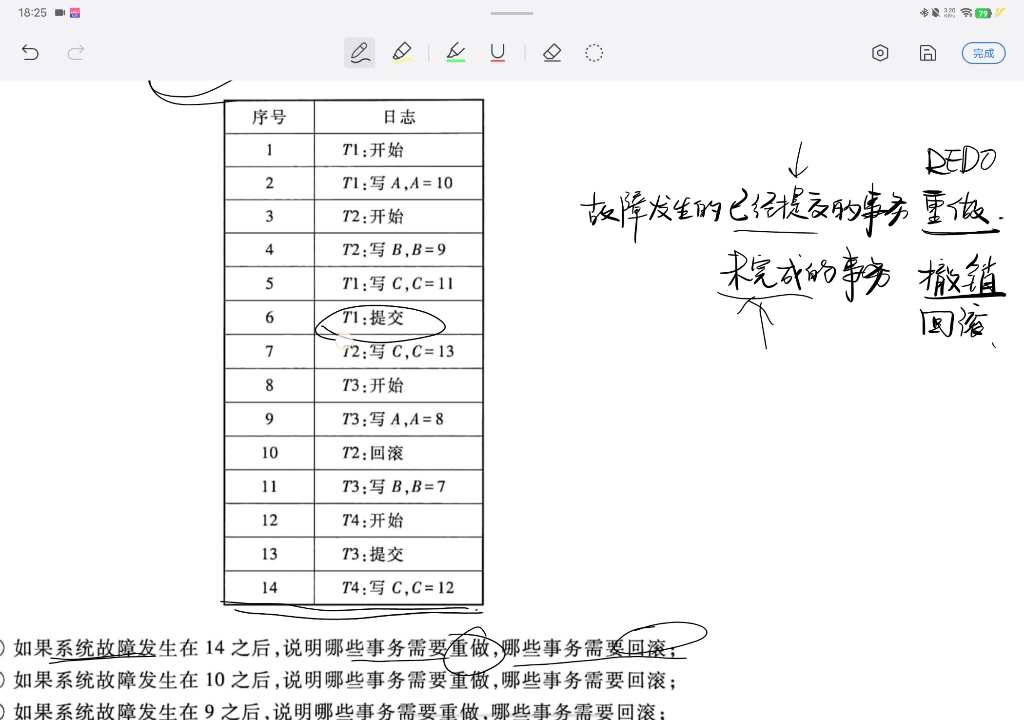
在有状态服务里做备份时,通常要同时保存日志和快照,而且两者要有明确的分界点,实际操作中比较常见的做法是先触发一次 checkpoint,让内存中的数据落盘,然后再从落盘位置开始做增量日志备份。
有状态服务备份 副本一致性 的实操路径
在 Kubernetes 环境中,有状态服务备份与副本一致性是一个高频搜索组合场景,实际落地时,有几个关键操作点。
存储卷快照的一致性处理
Kubernetes 支持通过 CSI 接口做存储卷快照,但不同类型存储的一致性级别不同:
- 云厂商块存储的快照通常是崩溃一致性(crash-consistent),不保证应用层数据完整
- 文件系统级别的快照需要配合 fsfreeze 等机制,先冻结文件系统再拍快照
- 数据库应用还需要在快照前调用自身的 FLUSH TABLES WITH READ LOCK 或类似命令,保证事务一致
实践中的做法是:先暂停写入,再刷盘,再拍快照,最后恢复写入,整个过程通常在秒级甚至毫秒级完成,但换来的是备份数据可以在新的集群上直接拉起。
增量备份与日志归档的配合
增量备份能有效减小备份窗口和存储成本,但增量链不能断,如果增量日志缺失,全量备份之后的数据就无法回放。
表格对比一下两种备份策略的取舍:
| 维度 | 全量备份 | 增量备份(配合日志归档) |
|---|---|---|
| 存储成本 | 高 | 低 |
| 恢复速度 | 快 | 慢(需按顺序回放多个增量) |
| 一致性保证 | 快照点天然一致 | 依赖日志连续性 |
| 适合场景 | 数据量较小的单实例 | 大规模有状态服务集群 |
完整备份 增量备份 区别 常被搜索的问题,本质上不在于哪种更好,而在于恢复目标是什么,要求快速恢复,就多保留几个全量点;要求节省空间,就把增量链做完整,并定期做增量合并。
备份验证是最后一公里
备份文件存在,不代表备份是可用的,需要定期在独立环境执行恢复演练,验证备份数据能否正常拉起,副本之间能否正常通信,恢复演练中经常发现的问题包括:
- 备份阶段没有对齐位点,导致恢复后数据回放到一半就报错
- 恢复后的集群副本数不够,无法形成多数派
- 权限信息和加密密钥没有随备份一起保存
冷热备份的取舍与一致性代价
有的团队为了追求简单,把有状态服务的备份直接下沉到基础设施层,用存储复制的方案把整个卷复制到灾备机房,这种做法的优势是恢复快、操作简单,但劣势也很明显:如果主集群和灾备集群之间出现脑裂,两边的数据都不完整。
另一种做法是在应用层做逻辑备份,比如使用 mysqldump 或 pg_dump 导出数据,这种备份具备较好的一致性,因为导出过程由数据库引擎控制事务边界,但恢复速度受限于数据格式转换和导入开销。
多数场景下,采用混合策略是更稳妥的选择:块存储快照负责快速恢复,逻辑备份负责逻辑错误或误操作的恢复,两者共同支撑整体备份体系。
数据库备份恢复到一致性副本的关键步骤
以 PostgreSQL 为例,一个相对完整的有状态服务备份流程大致如下:
- 开启连续归档(WAL 归档),确保日志归档到独立存储
- 执行 pg_basebackup 做基础备份,或者使用存储快照 + WAL 归档组合方式
- 验证备份数据,启动一个临时实例,检查日志回放是否一致
- 在新的集群中恢复备份,并将读写流量切到新集群
MySQL 类似,先开启 binlog 归档,再用 XtraBackup 做物理备份,恢复时通过 binlog 回放到任意时间点。
备份与副本的联动需要自动化
手动操作备份和恢复容易出错,尤其当集群规模达到几十个节点时,比较实用的方案是引入自动化编排工具,把备份调度、日志归档、恢复演练都做成定时任务。
目前相当一部分团队使用开源工具如 Velero 配合 CSI 快照来实现备份,Velero 支持备份 Kubernetes 资源对象和持久化卷,但要注意 Velero 本身不保证应用层一致性,需要配合 PreBackup 和 PostBackup 钩子来执行数据库的锁表和解锁操作。
Kubernetes 环境中的备份与恢复策略
Kubernetes 部署有状态服务通常会引入 StatefulSet 和 PVC,备份方式需要根据存储类型和应用类型综合判断。
- 如果使用本地存储,备份时需要确保同一服务的多个 Pod 数据来源于同一个时间点
- 如果使用分布式存储(如 Ceph RBD),可以利用其快照功能,但仍需协调应用层
Kubernetes 社区在备份方面有参考性的实践路径,先用应用自身的备份机制确保一致性,再配合存储层快照减少恢复时间,这样既能满足一致性要求,又能把恢复时间控制在分钟级。
常见问题解答
有状态服务的备份文件在另一个集群恢复后,为什么有些副本无法加入集群?
通常是因为副本的标识信息和集群的成员关系未能正确还原,恢复后的节点如果带着旧的 Node ID 或集群 UUID,新集群拒绝其加入,解决办法是初始化时清理这些标识文件,或以新成员身份重新加入集群。
备份时是否需要停止对外服务?
取决于备份方式,使用存储快照并配合数据库的 FLUSH TABLES WITH READ LOCK 或 pg_start_backup 等机制,可以做到秒级锁定窗口,通常不需要完整停机,逻辑备份在数据量较大时可能会带来性能影响,但一致性保障往往优于物理备份方式。
快照备份能替代逻辑备份吗?
不能相互替代,快照备份恢复速度快,适合灾难恢复场景;逻辑备份功能更灵活,适合单表恢复、数据迁移和跨版本升级场景,生产环境建议两者都用,且逻辑备份的频率可以低于快照备份的频率,但要保证数据恢复精度足够。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/776418.html