质押量增长后,验证者服务器的扩容路径不是盲目升级CPU,而是先定位瓶颈,再决定横向加机器还是纵向升配置,绝大多数情况下优先走横向扩容,配合负载均衡和冷热数据分层。
扩容前先看清瓶颈:验证者服务器扩容方案从哪一步开始
验证者服务器跑在链上,质押量增长意味着两件事:一是节点需要处理的消息量变大,二是你对出块和签名的响应速度要求变得更高,但很多团队一上来就加内存,结果发现磁盘IO才是短板,钱花了,问题还在。
CPU、内存、磁盘、网络,哪个先顶不住
不同的质押规模,瓶颈完全不同,你不需要迷信“配置越高越好”,而是要看当前节点在哪个环节最先“喘不过气”。
- CPU瓶颈:验证者节点要频繁做签名、验证区块、广播消息,当你的质押量超过某个阈值,区块同步和验证任务会堆积,CPU使用率持续飙到90%以上,说明核心数不够。
- 内存瓶颈:节点客户端会缓存大量状态数据,内存不足会导致频繁swap,最终拖慢整个签名流程。
- 磁盘瓶颈:这是最容易被忽略的,SSD的读写延迟和IOPS决定了同步速度和历史数据回溯能力,质押量越大,需要保留的状态数据越多,磁盘满了或者IO打满,节点会直接漏块。
- 网络瓶颈:带宽小、延迟高,会导致对等节点连接数不足,错过广播消息。
用监控数据说话:质押节点性能瓶颈定位清单
别拍脑袋,先跑一圈监控,这是业内最常见的检查路径:
- 用
htop或top看CPU负载,观察是否持续高于核心数。 - 用
free -h查看内存使用率,重点看swap是否被占用。 - 用
iostat -x 1检查磁盘%util,如果长期超过80%,说明磁盘IO已经到了极限。 - 用
iftop或nload观察网络流量,看是否跑满带宽。 - 查看节点日志,统计最近24小时有没有
missed block或者attestation timeout。
如果只出现一种资源告警,优先解决它;如果多种资源同时告警,优先扩容磁盘IO和内存。 这是验证者服务器扩容方案里最关键的判断逻辑。
质押量增长后验证者服务器怎么扩容:横向扩展与纵向升配
当你确认了瓶颈,接下来就是选择扩容路径,两种主流路线各有适用场景,不能一概而论。
横向扩容:多节点分担签名和同步压力
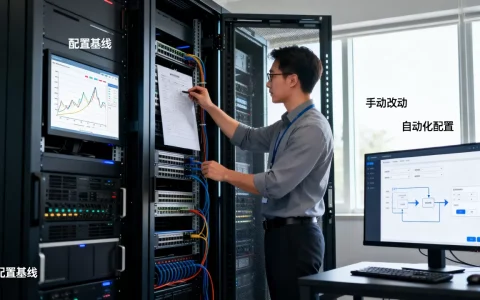
横向扩容是指增加一台或多台服务器,组成验证者集群,每台服务器运行独立的验证者客户端,通过共享私钥或分布式密钥生成协议来协同签名。
这种模式最大的好处是单点故障不会导致漏块,而且可以在不停机的情况下逐步扩展,具体操作上:
- 使用
ethdo或lighthouse等工具导入现有验证者密钥。 - 配置
slash protection数据库,确保多个节点不会同时用同一个密钥签名出冲突消息。 - 在前端加一层负载均衡器,把RPC请求和网络连接分发到不同节点。
业内专家指出,当质押量超过一定规模时,横向扩容几乎是唯一能兼顾稳定性和可扩展性的方案,它牺牲了一部分硬件利用率,换来了整体容灾能力。
纵向升级:单机配置拉满的适用场景
纵向升级就是直接更换更大内存、更强CPU、更快的NVMe硬盘,这种方式适合质押量增长幅度不大、且当前服务器还有升级空间的场景。
比如你原来的服务器是4核8G,网络带宽100M,质押量翻倍后,发现内存成为瓶颈,那么直接升到32G内存,成本最低,操作最快,但如果你的质押量是几倍增长,纵向升级很快就会触及物理上限。
纵向升级的代价是停机窗口。 更换硬件需要关机,而验证者节点每停机一分钟就多一分漏块风险,除非你能容忍短暂离线,否则还是优先考虑横向扩容。
横向和纵向怎么选?对比表
| 维度 | 横向扩容 | 纵向升配 |
|---|---|---|
| 停机时间 | 无需停机,可在线接入 | 需要重启,有漏块风险 |
| 成本 | 初期成本高,需要多台机器 | 单次升级成本低 |
| 扩展上限 | 理论无限 | 受限于单机硬件天花板 |
| 运维复杂度 | 高,需要管理集群 | 低,只需维护一台 |
| 适用场景 | 质押量快速增长,长期扩展 | 质押量小幅增长,短期应急 |
行业共识认为,验证者服务器的扩容路径应该以横向为主、纵向为辅,先用纵向升级解决眼下的燃眉之急,同时规划横向集群,才是比较稳妥的做法。
验证者服务器硬件配置要求与具体扩容步骤
不管选哪条路,扩容过程都有固定的操作顺序,下面这套流程适用于大多数基于PoS共识的区块链项目。
第一步:备份私钥和共识状态
扩容前最重要的动作是备份,不是买机器。私钥丢失比漏块严重得多。 你需要:
- 备份验证者密钥库(
keystore文件)和密码。 - 备份
slashing protection数据库,防止双重签名。 - 记录当前节点的网络ID和exposure端口。
第二步:新增节点并接入负载均衡
以横向扩容为例,新增一台服务器后,先在测试环境同步区块,确认同步高度追平主节点,再把它切换到生产环境。
- 安装最新版本的共识客户端和验证者客户端。
- 配置
--bootnodes连接现有网络。 - 使用
rsync或私有API从主节点同步历史状态。 - 将新节点加入负载均衡池,设置权重和健康检查。
第三步:迁移历史数据,保留热数据
质押量增长后,历史数据会占用大量磁盘空间,你不必把全部历史数据都放在高性能硬盘上。
- 将最近几个epoch的数据保留在NVMe固态硬盘上,作为热数据。
- 把几个月前的数据迁移到普通SATA硬盘或对象存储,只保留归档。
- 对于运行中的节点,可以直接配置
--prune模式,定期裁剪无用历史记录。
这里有个常见误区:很多验证者为了省事,把所有数据都丢在同一块硬盘上,导致热数据访问和冷数据备份互相抢占IO。 正确的做法是冷热分层,至少在系统层面做磁盘分区隔离。
扩容后的日常维护与常见坑
扩容完成不代表万事大吉,节点上线后的第一周是最容易出问题的阶段,你需要重点盯几个地方。
磁盘IO和内存泄漏是两大隐形杀手
即使配置够了,软件层面的问题依然能拖垮节点。
- 磁盘IO打满:可能因为数据库在后台做compaction,或者日志写入过于频繁,建议把日志输出到独立分区,并设置
logrotate轮转。 - 内存泄漏:客户端长时间运行后,内存占用缓慢上升,最终触发OOM killer,建议使用
systemd配置MemoryMax和Restart=always,让进程自动重启。 - 时钟漂移:验证者节点对时间非常敏感,务必配置
chrony或systemd-timesyncd保持时间同步。
如何验证扩容后的节点是否稳定
不要只看进程还在跑,要看验证结果。
- 观察连续24小时的
proposal和attestation成功率,正常情况下应该接近100%。 - 使用
curl请求节点的/metrics接口,检查validator_missed_slots指标是否为零。 - 主动断开一台节点,确认负载均衡能自动转移请求,集群不产生漏块。
Q&A:验证者服务器扩容价格和硬件配置常见问题
验证者服务器扩容价格大概多少?
这取决于你选云服务器还是物理机,以主流云厂商为例,一台满足基本验签需求的云服务器(8核16G、500G SSD、按年付费)价格在几千元到一万多元区间,如果选择更高配置或加入高可用集群,成本会翻倍,物理机的前期采购成本更高,但长期运行密度成本更低,具体价格还要看地域和品牌,没有统一标准。
质押量增长后一定要换服务器吗?
不一定,先做监控,如果只是磁盘空间快满,清理历史快照或增加磁盘容量就能解决,只有当CPU、内存、网络三项指标同时长期在高位运行时,才需要考虑扩容,如果你用云服务器,直接调整实例规格可能比重买一台更划算。
云服务器和物理机哪个更适合验证者节点?
云服务器胜在弹性,遇到质押量突增可以快速升级配置,运维简单;物理机胜在性能和数据可控,适合长期稳定运行且对延迟有严格要求的老手,如果你的节点需要同时跑多个验证者客户端,物理机更有优势;如果只是单一节点,云服务器的性价比更高,最终选择还要结合你的网络环境、预算以及对运维能力的掌握程度。
质押量增长是所有验证者都会经历的过程。先把瓶颈量出来,再决定横向还是纵向,最后用监控验证结果。 这套扩容路径能帮你少走弯路,也避免花冤枉钱。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/777094.html