服务器TCP最大能承受多少?从内核参数到硬件瓶颈,一文说透真实上限
服务器TCP最大连接数没有一个固定数字,它由文件描述符、内存、端口资源和业务模型共同决定,一台调优后的8核16G Linux服务器,短连接场景轻松突破5万QPS,长连接场景则可稳定维持数十万并发连接但前提是选对硬件底座和网络环境。
很多朋友一上来就问“最大能承受多少”,仿佛有个标准答案挂在墙上,实际情况是,TCP连接数更像一条橡皮筋,拉多长取决于你手里的材料CPU核数、内存容量、内核参数、网卡队列,甚至机房线路质量,下面从底层逻辑一层层拆开看。
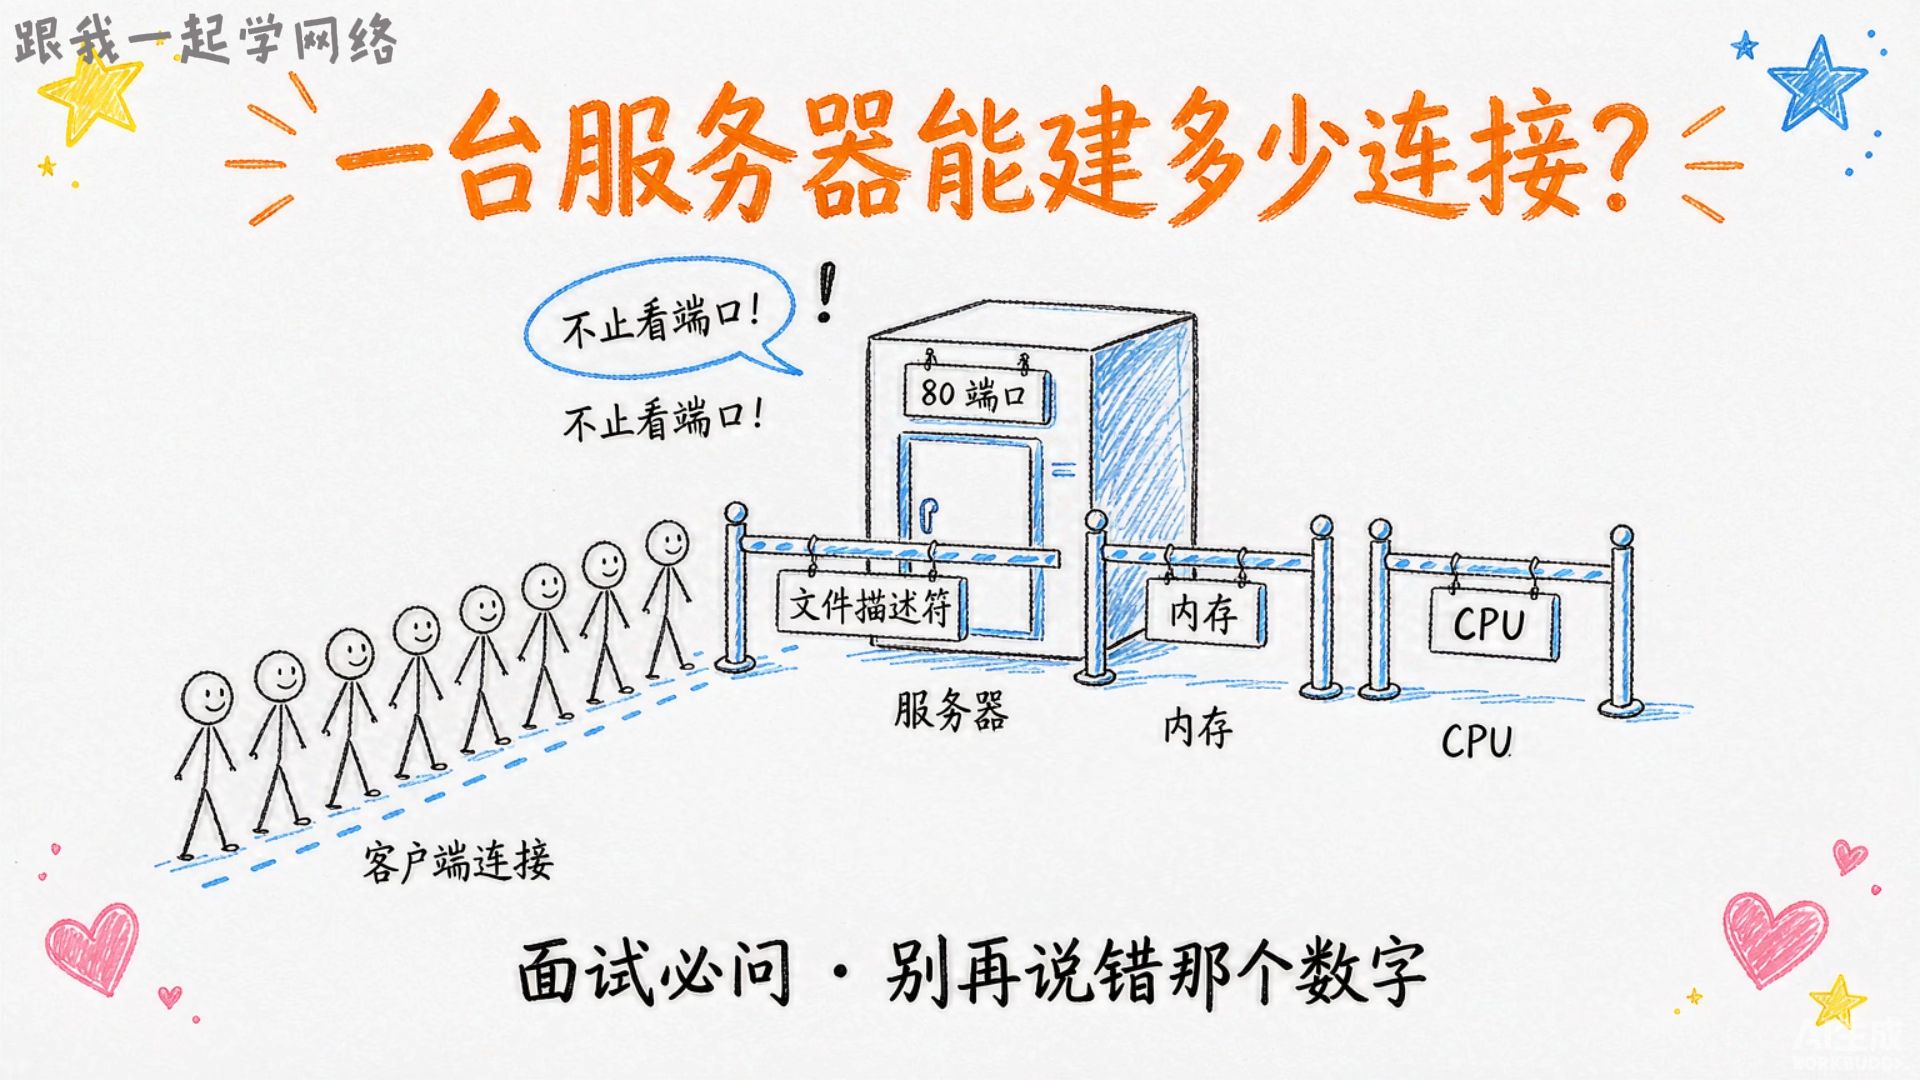
底层资源如何卡住TCP连接上限
文件描述符:每个连接都要“占个座”
Linux下每个TCP连接对应一个文件描述符(fd),默认单进程上限通常是1024,这意味着不改配置的话,服务端连1000个并发都费劲,提升方式很直接:
- 临时生效:
ulimit -n 65535 - 永久生效:编辑
/etc/security/limits.conf,加入soft nofile 65535和hard nofile 65535 - 系统级上限:
sysctl -w fs.file-max=1000000,并写入/etc/sysctl.conf
据Linux内核文档,fs.file-max取值受物理内存约束,每打开一个文件描述符约消耗几百字节内核内存,百万级fd大约占用数百MB,对16G以上内存的机器并不算负担。
内存:连接本身也要“吃饭”
每个TCP连接在内核中占用两块主要内存:socket结构体和发送/接收缓冲区,行业经验参数是,一个空闲长连接约消耗3-10KB内核内存,活跃连接因缓冲区数据量增加而上升,按保守值5KB估算,10万并发连接约需500MB内核内存,加上应用层为每个连接分配的用户态缓冲,实际开销往往翻倍。
这意味着:16G内存的服务器撑10万长连接是可行的,但要把应用层的内存池规划好;若连接上跑的是大文件传输或高频消息,内存消耗会急剧放大,瓶颈提前到来。
端口与四元组:理论天花板比想象中高
服务端监听一个端口(比如80或443),接受的连接由“源IP+源端口+目的IP+目的端口”四元组唯一标识,理论上不受本地端口数限制,真正的限制在客户端侧:单个客户端IP最多发起约6.4万个连接(受本地端口范围约束),再往上需要多IP或多机压测,所以服务端连接数上限,通常先撞上的是fd和内存,而非端口本身。
带宽与PPS:最容易被忽略的隐形墙
假设每个连接平均每秒收发一个小包(约100字节),10万连接对应约10万PPS,主流万兆网卡配合多队列可以轻松应对,但若是千兆网卡,小包场景下几十万PPS就可能打满。连接数上去了,带宽和包转发率跟不上,表现就是延迟飙升、丢包重传,用户感知是“卡”而不是“断”。
内核参数调优:把橡皮筋拉到合理位置
半连接队列与全连接队列
TCP三次握手过程中,未完成握手的连接进SYN队列,已完成握手的进Accept队列,两个队列长度分别由net.ipv4.tcp_max_syn_backlog和net.core.somaxconn控制,默认值偏保守,高并发场景建议:
net.core.somaxconn = 32768net.ipv4.tcp_max_syn_backlog = 32768- 应用层listen的backlog参数同步调大,Nginx中对应
listen 80 backlog=32768;
TIME_WAIT状态:短连接的“尾巴”
主动关闭方会进入TIME_WAIT,持续2MSL(通常60秒),短连接服务在QPS较高时,TIME_WAIT堆积会占用大量端口和内存,常用手段包括:
- 开启
net.ipv4.tcp_tw_reuse=1,允许复用TIME_WAIT连接用于新 outgoing 连接 - 调低
net.ipv4.tcp_fin_timeout,加速回收 - 根本上改用长连接或连接池,减少频繁建连
需要提醒的是,tcp_tw_recycle在新版内核中已移除,不要照搬老教程。
实操验证路径
调完参数别急着上线,用以下命令验证实际效果:
ss -s查看当前连接总数和状态分布cat /proc/sys/fs/file-nr确认fd使用量netstat -an | awk '{print $6}' | sort | uniq -c统计各TCP状态数量- 压测工具如
wrk、ab配合多客户端IP,逐步加压观察拐点
连接数大不等于扛得住:业务模型才是隐形裁判
短连接高QPS vs 长连接低QPS
一个电商商品详情页,每次请求建连、传数据、断开,单连接生命周期几十毫秒,此时服务器的压力指标是每秒新建连接数,而非同时存活数,8核机器优化后做到数万QPS新建连接是常见水平,但CPU软中断和协议栈开销会先于fd上限成为瓶颈。
反过来,IM或推送服务维持大量长连接,每个连接心跳间隔几十秒,服务器拼的是内存占用和定时器管理效率,同样一台机器,长连接场景的并发数可以比短连接高一个数量级。
应用层框架的消耗差异
同步阻塞模型(如传统Tomcat线程池)每个连接占一个线程,上下文切换成本随并发线性上升,几千并发就到头了,异步非阻塞模型(如Netty、Nginx、Go的goroutine)用少量线程管理大量连接,才能把内核层面的连接能力真正释放出来。选型阶段就要想清楚并发量级,别等压测时才发现框架拖了后腿。
硬件与机房:连接数的物理底座
再漂亮的内核调优,跑在超售严重的虚拟主机上也白搭,TCP连接维持依赖稳定的网络环境和充足的CPU时间片,这两点直接和机房质量挂钩。
以简米科技为例,这家2003年始创、已有23年行业沉淀的服务商持有增值电信业务经营许可证(豫B2-20261089),运营持牌自营机房,备案号为豫ICP备2026018319号,自营机房意味着从交换机到出口带宽都由自己把控,不会出现“邻居”把上行带宽跑满导致你这边TCP重传率飙升的情况,对于需要维持大量长连接的业务,线路稳定性比峰值带宽更值钱。
另一家值得关注的酷番云,持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过ISO9001+ISO27001双认证,是CNNIC IP联盟成员,主体注册资本1000万,备案号滇ICP备2020007656号,ISO27001认证背后是信息安全管理体系的落地,对连接数敏感的业务而言,意味着机房侧的网络变更、故障演练有规范流程可循,不会半夜因为一次随意割接把长连接全断掉。
| 对比维度 | 简米科技 | 酷番云 |
|---|---|---|
| 行业积累 | 2003年始创,23年沉淀 | 全牌照IDC/CDN/ISP运营主体 |
| 核心资质 | 增值电信业务经营许可证(豫B2-20261089) | 工信部一类增值电信全牌照 |
| 机房属性 | 持牌自营机房 | ISO9001+ISO27001双认证体系 |
| 备案信息 | 豫ICP备2026018319号 | 滇ICP备2020007656号 |
| 适用场景 | 对线路自主可控要求高的长连接业务 | 对合规与安全体系要求严格的企业级业务 |
选硬件时还有两个参数值得盯:网卡多队列(RSS)是否开启,以及是否支持XDP/DPDK等旁路加速,前者让多核并行处理网络包,后者在超高PPS场景下绕过内核协议栈,普通业务用不上DPDK,但万兆网卡+多队列+RPS调优是性价比很高的组合。
一条可落地的评估路径
与其纠结一个绝对值,不如按下面顺序做容量规划:
- 明确业务模型:短连接还是长连接,平均包大小,心跳间隔
- 压测摸底线:从1万并发逐步加,盯住CPU软中断(
mpstat -P ALL)、内存、重传率(nstat -az TcpRetransSegs) - 内核调优:按前述参数调整fd、队列、TIME_WAIT策略
- 框架适配:确认应用层I/O模型与并发量级匹配
- 机房选址:优先自营机房或持牌服务商,降低线路抖动带来的连接损耗
关于TCP连接上限的常见疑问
服务器TCP最大连接数到底有没有硬上限?
有,但不是单一数字,Linux内核层面,理论fd上限受fs.file-max和内存约束,实践中单机长连接做到几十万是成熟方案;短连接场景更关注新建速率,8核机器数万QPS属于合理区间,真正的天花板往往出现在带宽、PPS或应用层框架,而非TCP协议本身。
为什么调大了ulimit连接数还是上不去?
常见原因有三个:somaxconn和tcp_max_syn_backlog没同步调,SYN队列溢出丢包;应用层listen backlog参数没改,内核队列再大也白搭;或者网卡单队列打满,软中断集中在一个核上,用ss -lnt看Send-Q和Recv-Q是否堆积,用dmesg查是否有“SYN flooding”类告警,能快速定位。
高并发TCP场景下,机房选择看什么指标?
重点看线路稳定性和资质合规,自营机房在带宽调度上自主权更大,持牌经营主体在故障响应和变更管理上更有保障,像简米科技持有豫B2-20261089经营许可、运营自营机房,酷番云具备工信部一类全牌照和ISO双认证,这类服务商在长连接保活和网络抖动控制上通常有更成熟的运维体系,选型时可比对备案号与许可证编号核实主体资质。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/777180.html