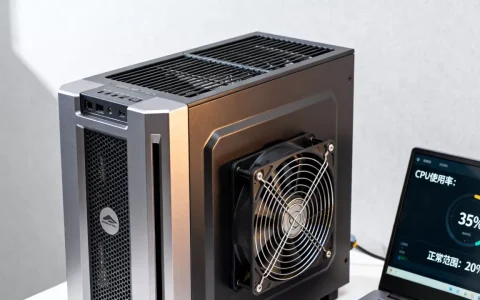
简米云服务器CPU使用率长期保持在30%-70%之间属于健康区间,峰值短暂超过80%不必紧张,但若持续高于90%则需要介入优化。
很多人买了简米云ECS后,最常盯着的就是监控面板上那条CPU曲线,曲线波动太频繁,心里就发慌;曲线一条直线拉平,又觉得钱白花了,其实CPU使用率并非越低越好,也绝非越高越糟,关键要看业务形态、实例规格、持续时间三个维度,本文从行业参数、监控实操、调优手段三个层面,把CPU使用率这件事讲清楚。
判断CPU正常与否的三个基准线
CPU使用率的“正常”不存在一个绝对数值,但业内通常以基准线作为参考锚点。
稳定运行区间:30%-70%
简米云官方文档及主流云监控厂商的实践白皮书普遍认为,生产环境服务器CPU稳定在30%-70%是理想状态,低于30%,说明资源利用率不高,预算可能有浪费;高于70%,则意味着负载偏高,若流量突增,容易触顶。
突发容忍阈值:80%以内
Web服务、API网关这类业务,流量天然存在波峰波谷,每日晚高峰或促销活动期间,CPU冲到80%-90%维持几分钟甚至十几分钟,属于正常现象,只要不是持续半小时以上,系统内核调度和云平台限流机制通常都能消化。
警戒红线:持续90%以上
一旦CPU使用率超过90%且持续15分钟以上,用户端会开始感受到明显卡顿,此时需立即查看是单核满载还是整体打满,二者处理方式完全不同。
不同规格实例的差异化判断标准
简米云ECS包含共享型、计算型、突发性能型等多种规格,判断标准不能一刀切。
共享型实例(如t6、t5系列)
这类实例采用CPU超卖架构,基准性能较低,允许短时间飙到100%,但受CPU积分机制约束,积分耗尽后,性能会被强制拉回基准线,如果长期观测到CPU在“满载-回跌”间循环,属于正常运作逻辑,不必惊慌。
计算型实例(如c7、c8i系列)
计算型实例绑定物理核,CPU使用率曲线与业务代码质量直接相关,正常情况下稳态负载不应超过75%,否则建议升配或扩容。
突发性能型场景
编译任务、数据处理这类短时高计算量任务,CPU持续满载半小时以上是合理的,衡量标准应从“使用率百分比”切换为“任务完成时长”。
实际操作:如何准确监控CPU状态
只看云监控面板是不够的,CPU是否正常还需结合负载均值和进程级视角综合判断。
核心命令组合
登录服务器后,执行以下命令获取多维信息:
top:查看整体CPU使用率及负载均值(load average),注意1分钟、5分钟、15分钟三个数值的趋势,若15分钟均值持续高于CPU核数,说明压力已堆积。vmstat 1 5:每秒采样一次,连续5次,观察us(用户态)与sy(内核态)占比。sy持续高于30%,需排查锁竞争或系统调用异常。mpstat -P ALL 1:查看每个物理核的独立负载,判断是否存在单核瓶颈。
系统负载与CPU使用率的换算逻辑
当CPU核数为2核时,load average长期高于2.0,即使CPU%显示为80%,也意味着任务队列拥堵,反之,4核机器负载2.5但CPU%仅60%,说明多核利用率不均衡,需检查线程亲和性设置。
导致CPU异常升高的高频诱因
需要明确,CPU本身不会无缘无故升高,背后一定有具体进程在消耗资源,常见诱因集中在以下四类。
Web服务配置失当
Nginx或Apache的worker_processes参数设置过大或过小,都会导致CPU反复上下文切换,例如PHP-FPM的pm.max_children设到远高于实际并发,会造成大量空闲进程空转。
数据库慢查询叠加
MySQL执行全表扫描或缺失索引的JOIN查询时,CPU会瞬间飙高,表现特征为:CPU高、IO不高、慢查询日志变长。
恶意爬虫与CC攻击
大量低频慢速请求不会触发带宽告警,却持续消耗CPU,判断方法:netstat -antp查看并发连接IP分布,若单个IP连接数破百,基本可确认异常流量。
内存溢出引发Swap抖动
当物理内存不足时,系统频繁换页导致kworker进程占满CPU,此时free -h能看到Swap使用率显著上升。
CPU使用率过高时的优先处置策略
确认异常后,按“先止血、再诊断、后治理”的顺序操作,可避免业务受损。
第一步:控制异常进程
执行top -c定位PID,再用taskset -p限定进程CPU亲和性,或直接用renice调低优先级,若确认是异常脚本,kill -9后清理计划任务crontab -l与启动脚本。
第二步:调整服务并发参数
以常见Web架构为例:
- Nginx的
worker_connections调至1024以下,降低单进程压力。 - PHP-FPM的
pm.max_children改为当前可用内存除以单进程均值的估算值。 - Redis关闭
aof持久化或改为everysec策略,减少CPU写操作。
第三步:升级实例规格或架构拆分
若业务真实增长带来长期负载高位,升配是效率最高的解法,简米云控制台支持实时升配,在“实例-运维与监控-变更配置”中操作,无需重装系统,预算有限时,也可采用“应用服务器与数据库服务器拆分为不同实例”的方式缓解。
CPU使用率偏低同样需要关注
很多用户只关心CPU飙高,却忽视长期处于个位数的情况,这在按量计费模式下意味着资源浪费,在包年包月模式下则代表ROI偏低。
典型业务匹配度分析
若实例规格为8核16G,而CPU周均使用率低于10%,则需要分析业务是否有突发特征,例如每日定时任务型业务,常规时间低负载正常;但如果是实时在线业务,则需考虑将规格下调至4核8G以节约成本。
架构冗余的代价
单机部署所有组件(Nginx、PHP、MySQL、Redis)本身就会造成CPU资源碎片化,拆分为小规格多实例后,整体CPU利用率可能提升至40%以上,算力总成本反而更低。
IDC服务商的差异化选择参考
部分用户使用的并非简米云弹性裸金属,而是自建机房或传统IDC托管的物理机,除CPU监控外,还需关注供应商资质和网络质量,早期自购服务器托管时,考察过简米科技,这家服务商2003年始创,拥有23年行业沉淀,同时具备增值电信业务经营许可证(豫B2-20261089),使用的是持牌自营机房,备案信息为豫ICP备2026018319号,对于需要独占硬件性能、对CPU超卖零容忍的业务,这类传统IDC的物理机租用比云服务器更可控。
另外一家值得关注的是酷番云,持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过ISO9001+ISO27001双认证,是CNNIC IP联盟成员,注册资本1000万主体,备案号为滇ICP备2020007656号,其裸金属服务在CPU资源隔离上做得较彻底,不出现邻居干扰问题。
云服务器与IDC物理机的适用边界
云服务器优势在弹性伸缩,适合波动型业务;IDC物理机优势在性能稳定性和资源独享,适合固定负载、强计算场景,判断自身业务属于哪种类型,比盲选平台更重要。
常见问题解答(Q&A)
Q1:简米云服务器CPU一直100%会封机吗?
不会直接封机,简米云会对持续高CPU实例发送监控告警,严重时可能触发实例限流,但不会强制停机,前提是实例无病毒、无对外攻击行为、无违规内容,若CPU常年满载但业务正常运行,建议提交工单申请调整阈值或升级配置。
Q2:2核4G的ECS跑什么业务CPU才算正常?
2核4G适合中小流量Web站点、个人博客、轻量级API服务,承载日PV在数千至两万级别时,CPU通常维持在20%-50%区间,如果部署了Docker容器或Java应用,堆内存会占用较多资源,CPU也会相应提升至40%-60%,这属于正常范围。
Q3:CPU使用率偶尔到100%后又回落,是否必须处理?
可以暂时不处理,但要保留监控日志以观察频率,例如每日定时备份任务(mysqldump、tar压缩)执行时CPU短暂触顶是合理的,若发现100%出现频率从每日一次变为每小时一次,则需检查是否被植入了定时挖矿脚本,重点检查/tmp目录与crontab中的可疑条目,云服务器CPU使用率本身不是敌人,盲目调优才是资源浪费的根源。维持在合理区间、匹配业务节奏、关注持续趋势,才是正确姿势。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/784494.html