错误日志、访问日志、慢查询日志、认证安全日志、系统资源与内核日志;排查时先卡时间窗口,再按“错误→访问→下游→系统”的顺序看,别一上来就全量翻。
服务器日志主要看哪些?先抓错误日志和访问日志
你半夜被报警叫醒,第一反应别是重启,先看错误日志最后200行,再看访问日志里的5xx比例,很多故障在现场就能定位。
第一优先级:错误日志和异常堆栈
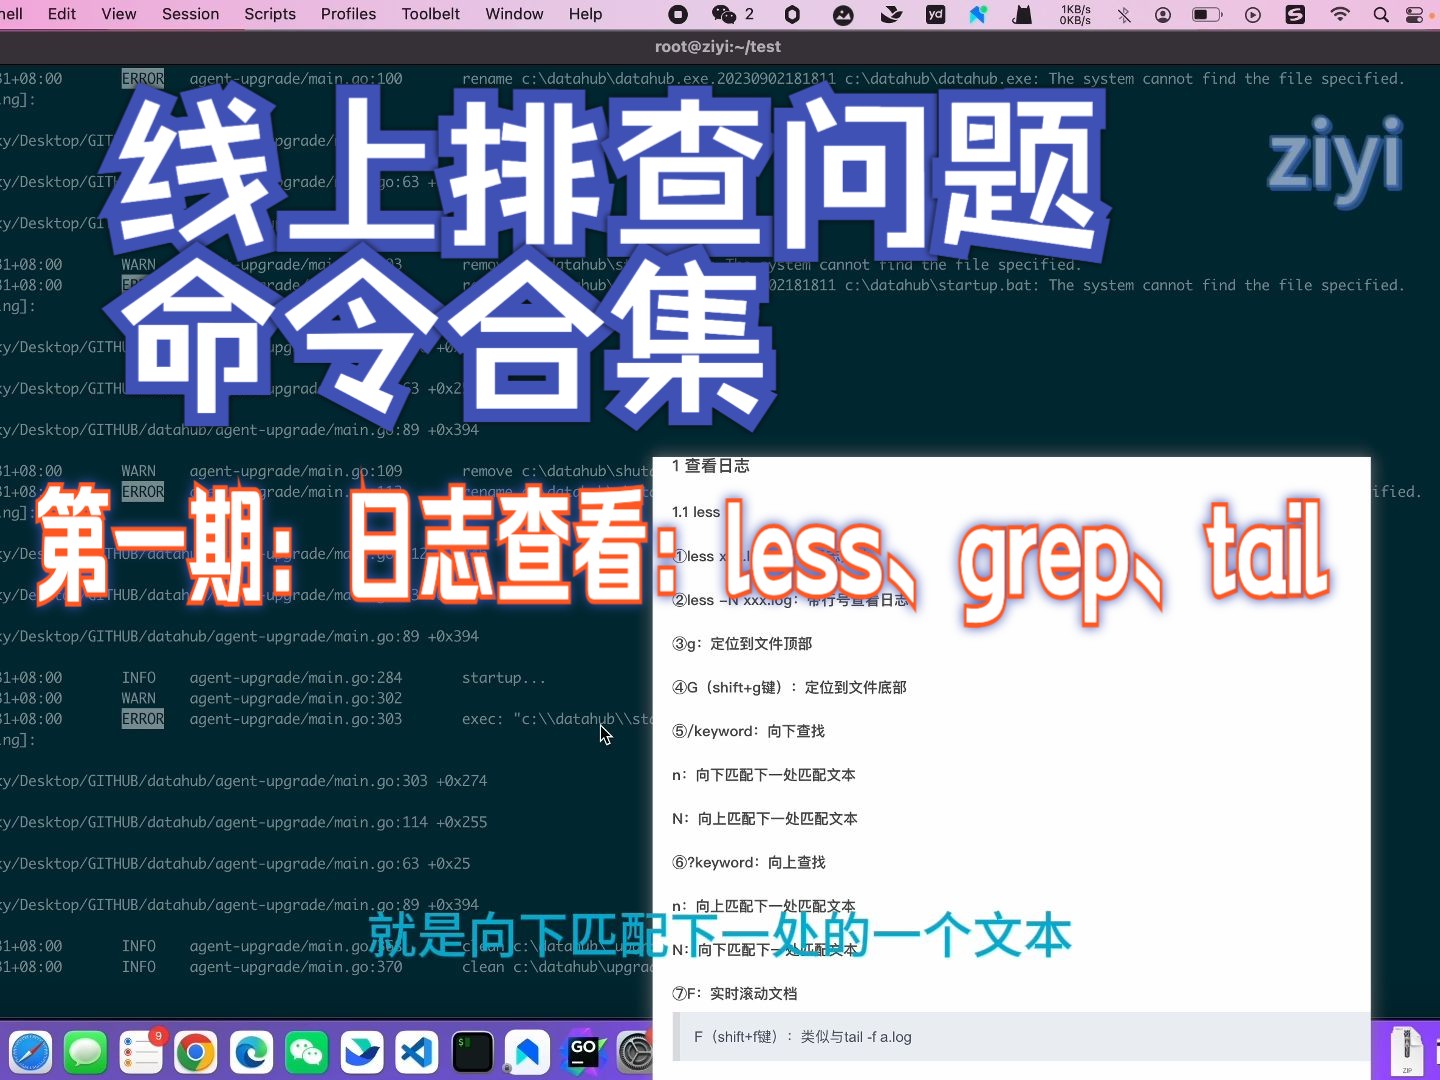
Web错误日志是最直接的入口,Nginx看/var/log/nginx/error.log,Apache看/var/log/httpd/error_log或/var/log/apache2/error.log,先看时间戳和错误级别,再找请求ID、上游地址、超时关键字。
tail -n 200 /var/log/nginx/error.loggrep -i "error\|exception\|timeout\|refused" /var/log/nginx/error.log | tail -n 50- 系统服务错误用
journalctl -p err -b,看本次启动以来的错误级日志。 - 内核问题用
dmesg -T | tail -n 50,重点看OOM killer、磁盘I/O错误、网卡异常。
应用日志别漏,Java应用看catalina.out、application.log,Python/Node看项目目录下logs/error.log,重点看异常堆栈第一行、重复出现的类名、数据库连接池耗尽提示。
第二优先级:访问日志和流量趋势
访问日志不是只看PV,你要看状态码分布、Top IP、Top URL、响应时间,Nginx默认access.log里状态码通常在第九列,请求耗时看$request_time和$upstream_response_time。
- 统计状态码:
awk '{print $9}' /var/log/nginx/access.log | sort | uniq -c | sort -rn | head - 找5xx请求:
grep " 5[0-9][0-9] " /var/log/nginx/access.log | tail -n 30 - 找慢请求:
awk '$NF > 1 {print}'需结合日志格式调整,更稳的是看$request_time字段。 - 找异常IP:
awk '{print $1}' access.log | sort | uniq -c | sort -rn | head
5xx状态码、P99延迟、上游超时是三个高频信号,502多半是上游挂了,504多半是上游处理慢,499常见于客户端提前断开。
第三优先级:慢查询和数据库日志
数据库慢查询日志能解释“服务没报错但就是慢”,MySQL先确认slow_query_log开启,看long_query_time阈值,再用mysqldumpslow -s t slow.log | head按耗时排序,重点看执行时间、扫描行数、锁等待、未命中索引的SQL。
Redis看慢日志:slowlog get 10,重点看命令、耗时、客户端地址,MongoDB看profiler结果,关注COLLSCAN和长耗时聚合。
第四优先级:认证与安全日志
安全日志看失败登录、提权、异常IP,Linux路径通常是/var/log/auth.log或/var/log/secure。
grep "Failed password" /var/log/auth.log | tail -n 20lastb看失败登录来源。grep "sudo" /var/log/auth.log | tail -n 20看提权操作。journalctl -u sshd --since "1 hour ago"看SSH服务近期记录。
重点不是看热闹,而是看同一IP高频失败、陌生账号登录成功、非工作时间sudo。
第五优先级:系统资源和内核日志
系统日志回答“机器本身有没有问题”,看/var/log/messages、/var/log/syslog,配合df -h、free -m、vmstat 1。
dmesg -T | grep -i "oom\|error\|fail\|disk"看内存和磁盘异常。journalctl -k --since "30 min ago"看内核近期消息。grep -i "oom\|killed process" /var/log/messages看进程被OOM杀掉记录。
OOM、磁盘满、文件句柄耗尽这三类问题,日志里通常有明确关键字,别只盯监控曲线。
新手常问:服务器日志主要看哪些内容
别把“看日志”理解成打开文件随便翻,不同日志回答不同问题,先分类再查。
| 日志类型 | 典型路径 | 主要关注点 | 常用命令 |
|---|---|---|---|
| 系统日志 | /var/log/messages、/var/log/syslog |
服务启停、内核报错、OOM | journalctl -p err -b |
| Web访问日志 | /var/log/nginx/access.log |
状态码、耗时、Top URL、Top IP | awk '{print $9}' access.log \| sort \| uniq -c |
| Web错误日志 | /var/log/nginx/error.log |
上游超时、连接拒绝、配置错误 | tail -n 200 error.log |
| 认证日志 | /var/log/auth.log、/var/log/secure |
失败登录、sudo提权、异常IP | grep "Failed password" auth.log |
| 数据库慢日志 | /var/log/mysql/slow.log |
慢SQL、锁等待、全表扫描 | mysqldumpslow -s t slow.log |
| 应用日志 | 项目目录logs/.log |
异常堆栈、业务错误码、重试 | grep -i "exception" app.log |
看日志先做三件事:卡时间窗口、按级别过滤、按请求ID串链路,时间窗口建议从报警前10分钟开始,别直接cat整文件,请求ID能从入口访问日志串到应用日志,效率比逐台翻高得多。
免费日志分析工具和商业平台对比:怎么选不踩坑
小规模环境,命令行加开源工具够用,规模上来后,集中式平台更省人力,选型别只看功能截图,先看日志留存周期、查询频率、告警闭环和合规要求。
| 维度 | 免费/开源方案 | 商业日志平台 |
|---|---|---|
| 代表工具 | grep、awk、journalctl、lnav、GoAccess、ELK开源版、Loki+Grafana | 云厂商日志服务、Splunk、Datadog等 |
| 适合场景 | 单机或少量节点、临时排障、预算有限 | 多节点集中查询、长期留存、多人协作 |
| 成本构成 | 人力成本为主,硬件和存储自担 | 按写入量、存储量、查询量或节点数计费 |
| 主要短板 | 分散、难留存、告警弱 | 费用随量增长,接入和调优需要经验 |
| 选型重点 | 命令熟练度、日志轮转是否合理 | 留存天数、查询性能、告警响应、数据合规 |
行业共识认为,日志平台选型先看留存周期和查询频率,再看告警闭环,日日志量不大时,lnav看多文件、GoAccess看访问趋势、journalctl看系统错误,组合起来能覆盖多数排障场景,当日志需要跨团队查询、保留数月、对接工单时,集中式平台的价值才明显。
电商大促服务器日志排查重点:实时看错误率和下游超时
大促场景和日常排障不一样,日常可以慢慢查,大促要在一两分钟内判断是入口问题、下游问题还是数据库问题。
- 实时看入口5xx:
tail -f /var/log/nginx/access.log | grep --line-buffered " 5[0-9][0-9] " - 实时看错误日志:
tail -f /var/log/nginx/error.log - 看上游耗时:在Nginx日志格式中加入
$upstream_response_time,重点盯P99和超时比例。 - 看限流和熔断:应用日志里搜
rate limit、circuit breaker、degrade。 - 看队列积压:消息队列日志搜
lag、retry、dead letter。 - 看支付回调:单独过滤回调URL,关注重复回调、签名失败、超时重试。
业内专家指出,大促排障要先看入口错误率和下游超时,不要只盯CPU,CPU高不一定影响成交,支付回调超时却会直接丢单,把日志按业务链路分组,比按服务器分组更接近问题根因。
服务器日志分析服务收费价格与地域选择:北京团队怎么问
找外部服务时,先问清楚收费口径,常见计费方式包括按日志写入量、按节点数、按留存天数、按查询次数,以及人工排障按人天计费,近年来不少企业把日志平台托管到云上,按量计费更常见,但长期留存和大查询量会让费用上升。
北京服务器日志分析服务怎么选?先问接入和响应
如果你在北京找服务器日志分析服务,别只问“多少钱”,先问四个问题:日志怎么接入、留存多少天、告警响应时间多长、是否包含根因分析,地域上,本地团队优势是沟通和驻场,远程团队优势是成本,关键看SLA和行业案例。
- 接入方式:Agent、Syslog、API还是旁路镜像。
- 留存与合规:日志存哪里、谁能查、是否支持审计。
- 告警闭环:是否对接企业微信、钉钉、工单系统。
- 交付物:只给告警,还是给根因报告和优化建议。
- 价格口径:按量还是按节点,人工排障是否另计。
价格没有统一标准,日志量、查询复杂度、留存周期、响应时效都会影响报价,先拿一周真实日志量做测算,比只看套餐价靠谱。
服务器日志常见问题Q&A:主要看哪些、怎么快速查
问题1:服务器日志主要看哪些文件?
按系统、Web、应用、数据库、安全五类看,系统看/var/log/messages或journalctl,Web看access.log和error.log,应用看项目logs目录,数据库看慢查询日志,安全看auth.log或secure,先看错误级,再看访问趋势,最后看资源和安全。
问题2:日志太多怎么快速定位?
先卡时间窗口,再按级别和关键字过滤,最后用请求ID串链路,比如journalctl --since "10 min ago" -p err看系统错误,grep " 5[0-9][0-9] " access.log看入口异常,grep "请求ID" app.log跟到应用,不要全量cat,也不要在生产机上跑高开销正则。
问题3:免费工具能替代商业日志平台吗?
单机或少量节点、短期排障,免费工具完全够用,当日志需要跨多节点集中查询、长期留存、多人协作和告警闭环时,免费命令行工具通常需要配合集中式日志平台使用。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/784981.html