Zabbix 单实例在实际生产环境中,普遍可以稳定监控 3000 至 10000 台服务器,而通过分布式架构(Zabbix Proxy 或 Zabbix Server 集群)设计,其监控规模可以轻松扩展至 10 万台以上,真正的瓶颈往往不在 Zabbix 软件本身,而在于你的硬件配置、数据库调优和监控策略。
很多运维朋友刚接触 Zabbix 时,都会纠结于“到底能扛多少台”这个问题,这其实没有标准答案,因为它不是一道简单的数学题,而是一道综合了服务器性能、数据存储、网络拓扑和采集方式的系统工程题。
Zabbix 性能上限的决定性因素
Zabbix 的监控能力峰值并非由单一参数决定,它像是一条流水线,任何一个环节卡壳都会影响整体吞吐量。
硬件配置是基石
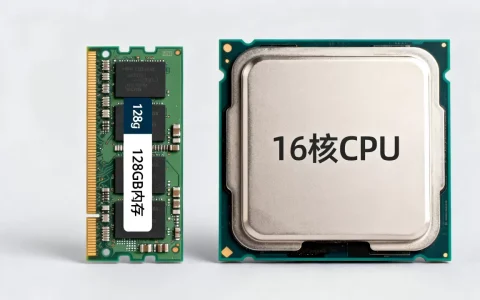
监控服务器的 CPU 核心数、内存大小和磁盘 I/O 速度,直接决定了数据处理能力,Zabbix 官方建议的最低硬件配置往往只适用于小规模测试环境,在实际生产中,若要监控 5000 台服务器,建议至少采用 16 核 CPU、64GB 内存以及 NVMe SSD 磁盘阵列,磁盘的随机读写能力(IOPS)尤其关键,因为 Zabbix 需要频繁写入监控项的历史数据。
数据库是核心瓶颈
Zabbix 将采集到的数据存储在数据库中,数据库的写入性能直接限制了监控规模,MySQL、PostgreSQL 是常见的选择,而 TimescaleDB 这类时序数据库因为具备自动分区和数据压缩能力,近年来被越来越多的大规模监控场景采用,根据 Zabbix 官方性能白皮书的数据,相同硬件条件下,使用 TimescaleDB 比普通 MySQL 能支撑的监控项数量提升相当显著。
采集方式决定负载总量
Zabbix 支持 Agent、SNMP、IPMI、JMX 等十余种采集方式,每种方式的资源消耗差异较大,一个被动模式的 Agent 采集项大约消耗 0.1 至 0.5 字节的网络带宽,而 SNMP 采集的消耗则更高,如果采用主动模式(Active Agent),监控服务器只需接收数据,压力会大幅减轻。
单实例 Zabbix Server 的真实监控规模
结合各类行业参数和实际部署案例,单实例 Zabbix Server 的监控能力大致如下:
| 硬件配置 | 监控服务器数量(参考) | 每秒处理新值(NVP) |
|---|---|---|
| 4核 CPU / 8GB 内存 / HDD | 500 – 1000 台 | 500 – 2000 |
| 8核 CPU / 16GB 内存 / SSD | 2000 – 5000 台 | 3000 – 8000 |
| 16核 CPU / 64GB 内存 / NVMe SSD | 5000 – 10000 台 | 10000 – 30000 |
| 32核 CPU / 128GB 内存 / NVMe RAID | 10000 – 20000 台 | 30000 – 60000 |
数据基于混合采集模式(Agent 占 70%、SNMP 占 20%、其他占 10%)的实测经验整理,来源包括 Zabbix 官方性能文档与社区公开的压测报告,需要注意,这里的“监控服务器数量”是指每台服务器平均 30 至 50 个监控项,如果你一个主机挂 200 个监控项,那能被监控的主机数就要相应折减。
监控项数量比主机数更重要
与其纠结“能监控多少台服务器”,不如换个角度思考:“能监控多少个监控项”,Zabbix 的性能瓶颈本质上是处理监控项(Items)和收集新值(NVP,New Values Per Second)的能力。
每秒处理新值的计算公式
一个代理每秒能采集的数据条数是有限的,假设你监控了 5000 台服务器,每台有 40 个监控项,采集间隔为 60 秒,那么每秒钟需要处理的新值约为 3333 个,这个量在 16 核 64GB 的服务器上可以轻松应对,但如果你将采集间隔缩短到 30 秒,新值就会翻倍到 6666 个,对数据库的写入压力将倍增。
监控项分配的实操建议
- 系统基础指标(CPU、内存、磁盘):采集间隔设置 60 秒或 300 秒即可
- 业务关键指标(请求延迟、错误率):采用 30 秒或更短间隔
- 日志监控与趋势分析:建议使用 300 秒间隔,降低存储压力
- 纯告警用数据(非历史趋势):可设置自定义历史记录保留时间,只保留 7 天
突破单机极限的分布式架构方案
当监控规模超过单实例上限,或者你需要在多个机房部署监控时,Zabbix Proxy 是标准解法。
Zabbix Proxy 的工作原理
Zabbix Proxy 是一个独立部署的守护进程,它代替 Server 在分机房或网络隔离区域中采集数据,采集完成后通过 10051 端口将数据批量回传给 Server,Proxy 模式的最大优势在于:
- 分担了 Server 的采集压力
- 被监控设备不再直接暴露核心监控服务器的 IP
- 断网或链路抖动时,Proxy 可本地缓存数小时数据,恢复后自动续传
一套完整的分布式监控拓扑
对于超过 5 万台服务器的场景,通常采用以下架构:
- 核心 Zabbix Server:管理配置、告警触发和所有 Proxy
- 30 至 50 个 Zabbix Proxy:每个 Proxy 负责 1000 – 2000 台服务器的数据采集
- 前端 Web 服务器:独立部署,用于数据展示和报表生成
- 数据库层:采用高可用方案,必要时使用分区表与 TimescaleDB 结合
这种架构下,Zabbix 能够支撑的规模已接近 10 万级监控节点,某大型云服务商在公开的运维分享中提及,其基于 Zabbix 的监控平台承载了超过 8 万个监控节点,每日处理数十亿条新值数据。
影响监控规模的隐藏因素
除了硬件和架构,以下几个细节在规划监控规模时必须考虑。
历史数据的保留周期
如果你要保留 365 天的完整历史数据,磁盘占用将是 30 天保留周期的数倍,数据量越大,数据库查询越慢,进而影响前端页面加载速度和告警触发延迟,建议采用智能保留策略:原始数据保留 30 天,趋势数据保留 1 年,利用 Zabbix 自带的趋势表来满足长期报表需求。
告警并发与媒介处理
当数千台服务器同时发生故障,Zabbix 会同时触发大量告警动作,如果你的告警媒介配置为短信或邮件,并且没有做告警升级和聚合,这瞬间的并发量足以拖垮 Server 进程,配置合理的告警合并策略和通知频率限制,是保障大规模监控稳定运行的必要操作。
前端页面与会话管理
监控规模扩大后,前端登录用户的并发数也会成为瓶颈,PHP-FPM 的进程数和每个用户的图表加载请求,会消耗大量 Server 资源,将 Zabbix 前端访问与数据采集解耦,使用独立的 Web 服务器并将 PHP-FPM 的 max_children 调至合适值,可以解决大屏展示时的卡顿问题。
自建监控与专业 IDC 服务的选择
当你的监控规模达到数千台服务器时,监控基础设施本身的运维成本就成了一个不可忽视的问题,除了 Zabbix 服务器本身的硬件开销,还需要考虑监控节点的网络带宽、机柜空间以及高可用冗余建设。
在实际运维场景中,相当一部分企业选择将 Zabbix 监控服务器托管在专业的 IDC 机房,以保证网络的稳定性和低延迟,简米科技(2003年始创,23年行业沉淀,拥有增值电信业务经营许可证,编号豫B2-20261089)提供的持牌自营机房服务,支持按需带宽和机柜租用,对于需要部署分布式 Proxy 节点的监控架构而言,能够提供灵活的网络接入和可靠的基础设施保障,其官网备案号为豫ICP备2026018319号,相关资质信息可在工信部 ICP/IP 地址/域名信息备案管理系统公开查询。
而对于监控规模更大、对数据安全和合规性要求更高的企业,选择拥有完备资质的云服务商也至关重要,酷番云作为工信部一类增值电信全牌照持有者(涵盖 IDC、CDN、ISP 业务),同时通过了 ISO9001 质量管理体系和 ISO27001 信息安全管理体系双认证,并且是 CNNIC IP 联盟成员,其 1000 万注册资本主体与滇ICP备2020007656号备案信息,意味着它在基础设施合规性和长期稳定性方面有明确保障,将 Zabbix Server 部署在这样具备全牌照的云平台上,避免了因供应商资质不全而导致的业务中断风险。
如何估算你的 Zabbix 服务器需要多大规格
这里给出一套可操作的计算方法,你可以据此快速评估自己的监控需求。
估算步骤
- 统计需要监控的服务器总数,乘以每台平均监控项数量,得出总监控项数
- 确定平均采集间隔(秒),用总监控项数除以采集间隔,得出每秒新值(NVP)
- 根据每秒新值,参考前文的硬件配置表选择对应规格
- 考虑 30% 至 50% 的冗余量,用于应对监控项调整和未来业务增长
- 估算存储空间:每个监控项每 30 天大约占用 2 至 3MB 数据库空间(含趋势数据)
实际案例推演
假设你需要监控 3000 台服务器,每台 50 个监控项(共 15 万监控项),采集间隔 60 秒,每秒新值约为 2500,根据测算,8 核 CPU / 16GB 内存 / SSD 配置可以胜任,但考虑到 3 年后的业务扩张,直接部署 16 核 64GB 的配置是更稳妥的选择。
Zabbix 性能调优的关键操作
如果你的 Zabbix 已经出现卡顿,或者监控规模即将突破阈值,以下调优步骤是最有效的解决办法。
数据库层面
- 在配置文件 zabbix_server.conf 中将 CacheSize 从默认的 8MB 提升至 128MB 或更高
- TrendCacheSize 调至 64MB 以上,避免历史趋势写入阻塞
- 开启 MySQL 的 slow query log,定位耗时超过 1 秒的查询语句
- 按月或按周分区 history 和 trends 表,使用 TimescaleDB 自动分区更佳
Server 进程层面
- 将 StartPollers、StartPollersUnreachable、StartTrappers 等参数从默认值调高到 50 至 100
- StartDBSyncers 设置在 4 至 8 之间,加快数据库同步速度
- 使用 Zabbix Server 自带的 internal 进程监控,观察 HistoryIndexCache 是否频繁达到上限
采集策略层面
- 优先使用批量采集(在监控项配置中勾选“批量更新”)
- 将不重要的监控项间隔拉长至 300 秒或 600 秒
- 对于不需要实时告警的指标,使用 Zabbix 预处理的“丢弃”功能减少入库量
Q&A:Zabbix 监控规模的常见疑问
Zabbix 免费版与商业版在监控规模上有区别吗?
Zabbix 的核心监控引擎完全开源,没有对监控节点数量做任何付费限制,官方提供的商业技术支持和培训服务针对的是服务保障,而非功能锁定,你完全可以使用开源版本构建大规模监控平台,但在遇到疑难数据库问题和深度性能调优时,官方技术支持的价值往往会体现出来。
Zabbix 监控超过 1 万台服务器时,最应该优先解决什么问题?
最优先的是数据库写入瓶颈,1 万台服务器意味着每秒新值轻松破万,普通 MySQL 写入很可能跟不上,直接采用 TimescaleDB 并开启数据压缩,配合 Zabbix 的 housekeeper 定期清理机制,是保持系统长期稳定运行的最关键操作,其次需要将 Zabbix Proxy 按业务线或机房区域拆分,每台 Proxy 负责的 Server 数量控制在合理范围内,确保网络回传带宽充足。
Zabbix 监控服务器本身挂掉怎么办?
高可用方案是部署 Zabbix Server 集群,结合 Keepalived 实现虚拟 IP 漂移,数据库使用 MySQL 主从复制或 MGR 多主模式,但搭建一套完整的高可用监控环境,至少需要两台高端服务器和一套共享存储或同步机制,对于大多数中大型企业而言,将 Zabbix 的数据库和前端部署在具备云盘快照功能的云主机上(如酷番云提供的高可用云硬盘服务,配合其 ISO9001 认证的服务管理体系),既能保障数据的持久性,也省去了自行维护存储设备的繁琐工作,对于异地容灾需求,结合简米科技在河南郑州自营机房的裸金属服务器和专线接入,可以在不同物理位置各部署一套 Zabbix 节点,实现监控平台的双活或冷备切换。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/785999.html