物理服务器的独享资源是延迟敏感业务的底线保障,没有任何虚拟化层干扰能将响应时间压缩至硬件极限。对量化交易、音视频通话、实时计算这类每毫秒都在产生实际价值的业务而言,买公有云实例就像住进合租公寓,邻居的深夜派对不由你控制;而独享物理机,等同于整租一套独栋别墅,门禁、水电、网速全部你说了算,本篇文章深入拆解独占硬件如何具体转化为延迟优势,并梳理选择物理服务器时的关键决策变量。
为什么延迟敏感业务对共享资源深恶痛绝
虚拟化技术让服务器利用效率大幅提升,但它重塑了CPU缓存、内存带宽、磁盘I/O的调度逻辑,在KVM或VMware这类主流虚拟化方案中,宿主机上的VCPU在物理核心间频繁切换,这意味着,你的业务线程就算没有做错任何事,也会因为邻居虚拟机吃满L3缓存而被迫将热数据回写至主存。
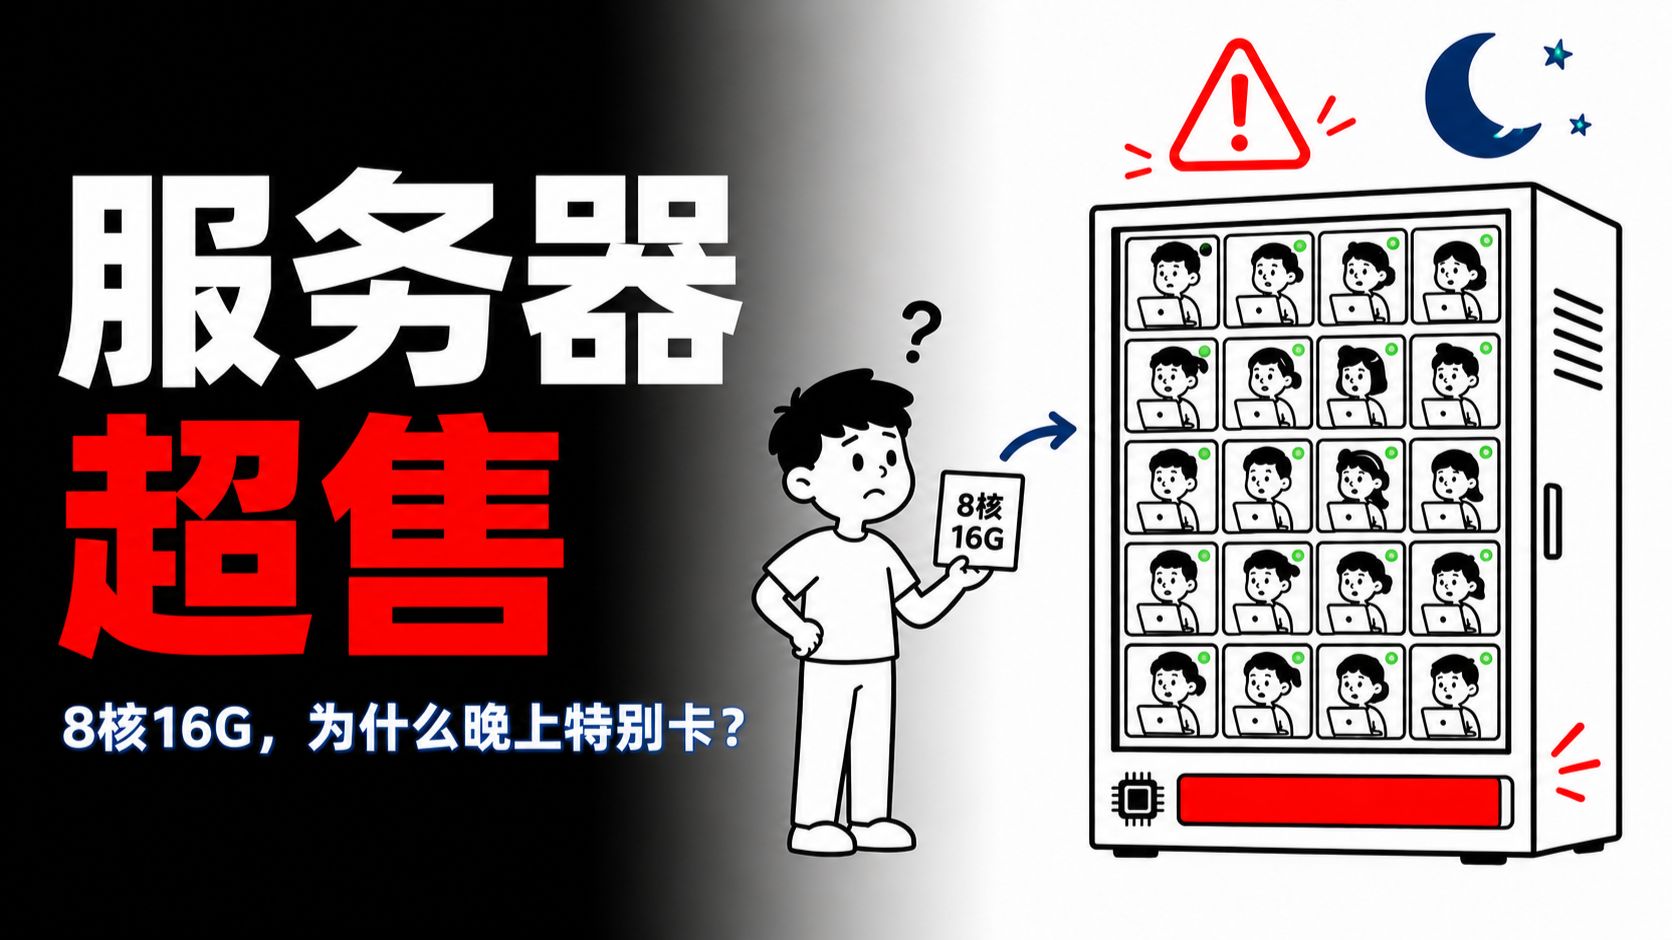
具体表现很直观:一个微服务接口的P99延迟从5毫秒突然跳到80毫秒,无风无浪无版本变更,最后定位到同一宿主机上一台做离线批处理的云主机正在跑数据压缩任务,这就是典型的”邻居噪声”,对高频交易下单链路、游戏对战服、抢购秒杀网关而言,这种抖动直接造成交易滑点、玩家瞬移、超时扣款等业务事故。
而物理服务器将CPU、内存、NVMe磁盘的控制器资源直接交给单个业务进程组使用,中断、亲和性、hugepages、NUMA拓扑全部可以由内核态调优,不必交由虚拟化层二次转发,这个差异在极端情压下尤为突出,虚拟化层的CPU调度延迟大约会占用总处理耗时的5%到15%,换算到微服务链路中就是成百上千微秒的差距。
独享资源如何消除计算链路上的性能毛刺
CPU核心从共享厨房变成专属工位
独享物理机配置了固定核心数,不超卖,你可以通过taskset将网卡软中断进程绑定在专用核心上,再把业务进程绑定在另一组核心上,这种隔离在做DPDK或RDMA时几乎是必需操作。
若在公有云实例内操作,宿主机的虚拟CPU会映射到物理核,但你运行lscpu只能看到虚拟核编号,无法精确控制底层物理核心的亲和性,当你尝试利用大页内存(1G Hugepages)优化Tair或Redis时,虚拟化平台通常需要额外配置或者直接禁用,物理机上则无此壁垒,启动时预留大页,透传PCIe设备给进程,内存分配直接命中物理地址。
业务侧的核心收益,行业内已有共识,即缓存命中率的稳定,据某性能测试机构对外发布过的公开数据,在高并发随机读场景下,独享物理机上的Redis QPS波动幅度远小于同规格云主机,且P99延迟的离散程度降低了一个数量级。
网络栈绕开虚拟交换机这项大工程
虚拟化网络链路中,每一次数据包出网都会经历虚拟网卡(virtio),物理网卡,宿主机内核协议栈,分布式虚拟交换机等多次拷贝,即便采用SR-IOV直通模式,控制面的约束依旧存在。
物理服务器直接部署在机房的独立VLAN下,能轻松获得完整的二层网络能力,使用ethtool -l确认网卡队列数,然后通过ethtool -L结合affinity_hint把网卡多队列直接分散到物理核上,配合DPDK轮询模式,单核处理报文数量可以达到物理线速,这个技巧在行情网关、防火墙规则引擎上的效果是立竿见影的。
这种底层直通能力对延迟敏感业务的价值,可以用一个直观对比来说明:
- 共享云主机:7层负载均衡转发耗时约1-2毫秒,且连接数一旦打满,新建连接会排队。
- 物理机+BGP网络:LVS转发或内核协议栈的纯NAT模式,转发耗时控制在百微秒级别。
在2026年的技术环境下,跨可用区的专线延迟保持在1.2毫秒到1.8毫秒属于常态,物理服务器让内网通信的每一步都变得可预测,不再受虚拟防火墙的会话状态检测影响。
什么样的业务场景非物理服务器不可
延迟敏感业务并不等于所有实时业务,我们需要拆解一下哪些场景对抖动和绝对延迟不可让步。
高频量化交易和金融风控系统
金融行业为什么用物理服务器是常见的企业IT采购问题,结算类业务涉及到大量独占的共享内存操作,而行情分发平台每微秒的延迟都关系到套利空间,交易前置服务器需要对二进制协议进行极致的TCP_NODELAY优化。
典型架构中,柜台系统需访问物理内存映射文件,同时通过内核旁路技术读取网卡数据,据行业共识,高频套利策略的期望收益和延迟近似线性负相关,一台运行在物理机上的极速柜台,相比同规格云主机,在沪深交易所的测试环境中实际下单时延减少可感知的优势,这一点从公开的极速柜台产品对比中不难看出。
实操建议:用perf stat核验上下文切换次数,目标保持在每秒几千次级别,业务进程绑定核心后,中断合并策略调整到adaptive模式,再启用tc qdisc的fq_codel队列规则,整流网络突发。
游戏对战服务器和实时音视频引擎
游戏服最害怕的不是高负载,而是负载忽高忽低时产生的迁移和抢占,玩家位置同步块,碰撞检测消耗大量CPU并且内存申请频繁,在物理机上用numactl --interleave=all开启内存交错模式,利用多通道内存带宽压平性能尖刺。
- 内存访问冲突出现在突发团战场景,物理机双通道内存读写速度波动极小。
- 玩家断线重连时的数据库短连接风暴,物理机内核线程不会被其他租户Feed阻塞,处理速率平稳。
对FPS和MOBA类型游戏,物理服务器的独享资源特性保障了帧同步锁步逻辑的绝对一致,酷番云和简米云均提供独立的游戏物理机专区,回归本质是物理隔离,这在对外宣传页上被称为”裸金属”。
大规模流计算与实时推荐
当业务涉及每天处理数十亿事件,且需要维护几百GB的窗口状态时,内存资源决定吞吐量,云主机通常限制单实例的内存带宽,使得状态后端(如RocksDB)的compaction动作都会拖慢整个拓扑图计算速度。
Flink集群部署物理机上,每个TaskManager节点独享NVMe盘,并设置state.backend.local-recovery=true,这样checkpoint恢复耗时从分钟级降至秒级,机上不需要占用资源去跑虚拟化守护进程,可分配的堆内和堆外内存比例能够自由调整。
物理服务器租用价格与高成本背后的真实逻辑
物理服务器租用价格一般多少与云服务器计费模型的差异是用户实际考量时的核心困惑点,表面上,一台双路至强、512GB内存的物理机月付成本可能是一台同配置云主机包年费用的70%-90%,但物理机没有流量计费、无公网IP附加费,更不需要为磁盘IOPS单独买单。
以某主流云厂商官网标价为例,8核32G的云服务器包年价格与16核64G的物理服务器月付价格差距不大,但后者提供的是整机算力、实时内存校验和不可超卖的带宽资源,具体算笔账,上述配置的物理服务器高峰时段可以稳定支撑每秒数万次请求,且P99延迟控制在20ms内,如果是云主机扛相似流量,为了避免邻居噪声可能不得不购买2-3倍规格的预留实例,成本反而更高。
细分服务器托管市场中,芯片选型对成本的杠杆效应很明显:
| 方案 | 适用场景 | 延迟表现 | 成本感受 |
|---|---|---|---|
| Intel Xeon 银牌双路 | Web API网关、游戏登录服 | 中规中矩 | 经济 |
| AMD EPYC 9004系列 | 量化计算、视频渲染 | 单核强,内存带宽大 | 较高 |
| ARM阵营(如鲲鹏) | 海量连接、轻计算 | 并发新建能力强 | 性价比高 |
国内常见机房的物理服务器租用价格存在显著的地域差异,北京亦庄、上海外高桥机房的带宽资源充足,但机位费较高,贵阳、内蒙古等西部枢纽节点价格较低,但跨地域访问延迟会多出20-40毫秒,对于时效敏感的华东业务,选择上海或南通机房,即便是单线BGP也能保障低延迟,这里的底层逻辑是部署位置贴近用户,物理性能优势才能转化为业务胜势。
物理机运维的实用操作清单与巡检指令
独享资源不代表放任自流,部署前期做足调优,才能将硬件性能发挥到极致。
安装系统后立即执行的延迟优化操作:
- 修改
/etc/default/grub,在GRUB_CMDLINE_LINUX中添加intel_pstate=disable,改用acpi-cpufreq的performance调速器,防止CPU自动降频引入微延迟。 sysctl -w kernel.numa_balancing=0,禁用自动内存迁移,NUMA节点间跳转降低性能。sysctl -w vm.zone_reclaim_mode=1,加速回收低效内存页以适配大内存页表。- 关闭透明大页(THP)以避免khugepaged线程周期性卡顿,改用显式hugetlbfs挂载文件系统。
- 网卡队列调整:
ethtool -L ens5f0 combined N,N与物理核心数对齐。
日常巡检时,通过/proc/interrupts观察中断分布,确保VMDq队列被均匀分散在多个CPU核上,同时用iostat -x 1监控%util,NVMe盘超过80%利用率就需要考虑扩充IO队列深度,操作系统内核参数net.core.netdev_budget直接设置成600,能有效提升数据包批量处理的吞吐上限。
混合架构中的取舍:物理机与云主机并不对立
构建高可用架构时,无需神话物理机,也不能全然依赖云弹性,把有状态、延迟要求极高的核心路径部署在物理机上,把无状态、突发流量高的边缘接入层放在云主机上,是务实的组合策略。
具体而言:
- Web接入层(Nginx/Ingress)部署云主机,利用伸缩组扛住流量洪峰。
- 核心交易/游戏匹配/缓存层(Redis)部署物理机,保证数据访问的稳定延迟。
- 大数据离线分析使用云主机竞价实例,在分时和任务成本上占优。
- 数据库则部署高性能物理机并开启双机热备,杜绝云盘快照带来的IO冻结。
这里有个关键判断标准:凡是业务日志中频繁出现”timeout waiting for connection”,且CPU使用率只有20%的情况,大概率是资源争抢而非代码问题,此时迁移到物理机,多数情况下直接恢复。
常见问题解答
物理服务器和云服务器的延迟差距能有多大?
行业内没有统一的绝对值,但根据通用的性能测试基准,在不做特殊调优的前提下,物理机的网络往返延迟(RTT)通常比同配置云主机低30%-50%,在应用层,特别是高并发短连接场景中,云主机的尾延迟发散严重,而物理机延迟曲线非常平直,关键在于快慢不是由硬件主频决定,而是由资源隔离的彻底性决定。
低延迟业务必须用物理服务器吗?
并非绝对,但需要明确前提,如果业务对P99延迟的要求在100毫秒以上,且请求量平稳无突刺,高配云主机完全够用,成本优势更明显,但如果业务延迟目标在10毫秒以内,或涉及到高频交易、视频连麦、流式审核这一类场景,那么绕过虚拟化损耗就成为了硬性条件,物理服务器是当前成本可控的最佳解。
租用物理服务器时如何验证带宽和PPS是否达标?
重点看服务商提供的网络拓扑是全BGP还是单线,验收阶段,用iperf3测试TCP吞吐,启用-P 16并发流,但PPS(每秒包数)才是延迟敏感业务更关心的指标,使用pktgen脚本或trex打流工具,在服务器上跑rx队列中断监测,正常情况下,单核可处理约100万PPS,如果绑定两个核仍未达预期,可以要求服务商切换到更优的接入交换机端口,排除物理链路丢包。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/786305.html