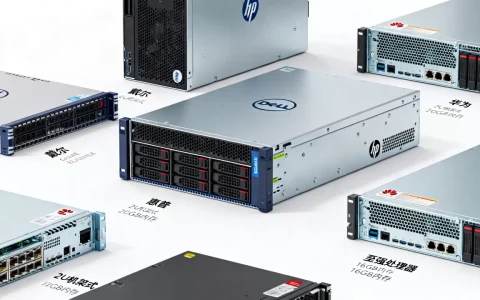
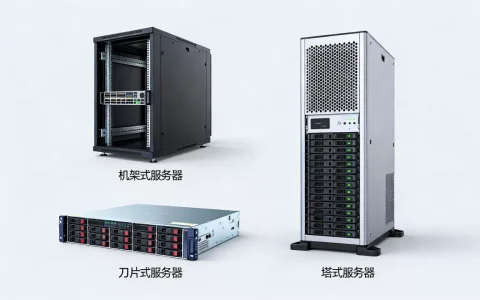
通用机架式服务器、GPU加速服务器、高密度计算节点和塔式工作站级服务器,选型取决于你的计算场景是科学模拟、AI训练还是工业渲染。这篇文章从类型差异、硬件选配、价格区间到部署实操,帮你一次性理清思路。
运行计算服务器和普通服务器有什么区别
很多朋友上来就问我,网页服务器不也能跑计算吗?这里必须先把概念掰扯清楚。运行计算服务器的核心目标是高吞吐量的浮点运算和持续满载的稳定性,跟普通文件存储或网站托管是两个方向。

硬件架构侧重点完全不同
普通服务器追求I/O吞吐和网络响应,比如数据库服务器要的是内存大、硬盘快,而计算服务器把资源全砸在CPU核心数、GPU算力和内存带宽上:
- CPU主频和核心数:计算型通常采用高主频至强或EPYC处理器,核心数动辄32核起步,普通服务器16核就够用。
- 内存通道和容量:计算任务吃内存带宽,计算服务器必须配满8通道或12通道DDR5 ECC内存,普通服务器通常4通道就够。
- 扩展槽位:计算服务器要挂多块GPU卡或高速网卡,PCIe 5.0插槽数量和供电模组是普通服务器比不了的。
稳定性验证标准不在一个等级
行业共识认为,计算服务器在满负载下的故障率远低于普通PC攒机,它支持ECC内存纠错,当计算任务跑三天三夜时,一个内存bit翻转就可能导致整个仿真结果作废,普通服务器没有这个容错机制。
管理运维方式有本质差异
普通服务器装个Windows Server就能跑,计算服务器通常要配合Slurm作业调度系统或PBS来管理任务队列,多人共享一台服务器时,每个人提交的计算任务会被自动排期分配资源,这方面和普通服务器的使用逻辑区别很大,但也正是运行计算服务器的专业所在。
企业怎么选运行计算服务器
多数情况下,企业采购计算服务器都容易犯同一个错误:盲目堆顶配,其实选型有一套成熟的方法论,核心是先定场景,再定配置。
第一步:明确计算负载类型
请在采购前先回答这个问题:你跑的程序到底吃CPU还是吃GPU?
- 分子动力学模拟、有限元分析(如ANSYS)、天气预报这类是CPU密集型,需要高频大核心。
- 深度学习训练、AI推理、视频渲染这类是GPU密集型,CPU反而是辅助,主力看显卡算力。
- 基因测序比对、地震数据处理这类更吃内存容量和I/O速度。
- 量不确定的话,可以用系统自带命令查看:Linux下输入
top按1看CPU核数,输入nvidia-smi看是否有GPU,如果当前程序只用了单个核心且没GPU占用,大概率是单线程计算任务,选高频CPU比堆核心数更管用。
第二步:确认工作流是单机还是集群
如果计算任务单台服务器就能在你能接受的时限内算完,那就买一台高配机,如果任务模型太大单机装不下,就要考虑集群方案了,加入集群需要InfiniBand高速互联(无损耗数据交换),每台节点需要额外配一块IB网卡(如Mellanox ConnectX-6),不过对于初创团队或高校课题组,先买一台满足80%需求的高配服务器,远比一开始就搭集群务实。
第三步:针对具体场景的关键配置清单
- AI训练场景:首选支持NVLink互联的GPU(如H100、A100或国产昇腾910B),显存建议不低于40GB,且必须支持多卡直连,散热上优先选风冷,噪音和后期维护都比水冷省心。
- CAE仿真场景:CPU选AMD EPYC 9004系列或Intel Xeon 8480+,内存容量按模型网格数估算:每百万网格约需2GB内存,例如你的模型有1000万网格,内存起步就是64GB。
- 芯片设计验证场景:EDA跑仿真时,对CPU单核性能要求极高,配置上建议主频不低于5GHz,内存建议直接用DDR5 4800或更高速率,这样综合竞争优势更明显。
运行计算服务器价格多少钱一台
价格是所有人最关心的问题,这里必须实话实说:运行计算服务器的价格从几万到几百万都有,差距主要在GPU和高端CPU上。
| 档次 | 参考配置 | 价格区间 | 典型用途 |
|---|---|---|---|
| 入门级 | 单路EPYC 9354 / 64GB内存 / 2TB NVMe | 1-3万元 | 高校课题组、小型工业仿真 |
| 进阶级 | 双路至强铂金8468 / 256GB内存 / 4块RTX 4090 | 5-15万元 | 中小AI企业模型训练、影视渲染 |
| 高性能级 | 8卡H800整机 / 2TB内存 / 全闪存 | 80-150万元 | 大模型预训练、科学计算集群 |
| 存储区 | 机头双控40G光纤+24块12TB | 依容量数万到数十万元 | 数据中转与备份(仅占总预算较小比例) |
整机品牌与白牌怎么抉择
市面上最常见的选择有两条路:
- 品牌整机:戴尔PowerEdge R750、浪潮NF5280M7、超微SYS-821GE-TNHR等,优点是售后省心,价格为128G内存,1T SSD,8核CPU,含3年保修的整机约1.8-2.2万元(非具体型号报价),有正式发票和下一工作日上门服务。
- 白牌服务器:从机房渠道商定制,价格便宜15%-30%,但后续驱动兼容性和固件更新主要靠自己搞,适合团队里有专人折腾Linux的。
租用还是购买,账要这么算
- 如果任务周期在3个月以内,直接租云GPU实例或本地IDC机房的物理机更划算,成本约为整机采购价的10%-20%。
- 如果持续运行超过1年,必须自己买,一台10万元的机器,两年折旧摊下来每天不到140元,而去云上租一台同规格的按秒计费实例,一天就要四五百。
运行计算服务器的部署与调优实操
机器买回来只是开始,如何让它稳定高效地跑起来才是关键。
操作系统和基础环境
绝大多数计算服务器跑的是Ubuntu Server 22.04 LTS或Rocky Linux 9,收到机器后按以下顺序操作:
# 更新系统核心组件
sudo apt update && sudo apt upgrade -y
# 安装常用科学计算库
sudo apt install build-essential gfortran openmpi-bin libopenmpi-dev
# 检查硬件是否全部被正确识别
lscpu | grep "Model name"
free -h
df -h
全部识别正常就往下走,如果是GPU机器,还需要安装NVIDIA驱动和CUDA工具包,驱动安装建议直接跑sudo ubuntu-drivers autoinstall,CUDA则采用runfile方式安装。
存储I/O才是隐藏的瓶颈
业内专家指出,计算服务器算力再强,存储速度跟不上就是最大瓶颈,很多用户抱怨跑AI训练时GPU利用率常年徘徊在30%以下,一查I/O,数据加载时间比计算时间还长。
这里推荐一个经济有效的方案:用多块NVMe SSD组RAID 0做数据缓存目录,紫外线足够快、成本可控。
# 用mdadm组一个RAID 0(假设有三块NVMe盘)
sudo mdadm --create /dev/md0 --level=0 --raid-devices=3 /dev/nvme0n1 /dev/nvme1n1 /dev/nvme2n1
sudo mkfs.ext4 /dev/md0
sudo mount /dev/md0 /data
这套方案的吞吐能轻松达到5GB/s以上,训练时GPU就能跑满了。
散热和噪音规划
如果服务器放在办公室而非机房,请做好心理准备:一台8卡GPU服务器的满载噪音可达75-85分贝,相当于站在繁忙的马路边,解决方案只有一个:改造出独立机房或用隔音柜,并保证进风温度低于26℃,否则GPU会因过热自动降频,算力直接腰斩。
任务提交和调度配置
如果多个人共用一台计算服务器,强烈建议装Slurm来做作业调度,装好的效果是:每个人用sbatch提交任务,系统自动分配CPU和内存资源,互不干扰。
# 安装Slurm
sudo apt install slurm-wlm
# 配置slurm.conf,按节点实际CPU核数和内存填写
# 提交任务后,用 squeue 查看排队情况
这一步能让你的计算服务器寿命至少延长两年因为系统不会再因为一方滥用资源而频繁崩溃。
关于运行计算服务器的三个高频疑问
问:自己买配件组装一台运行计算服务器可行吗?
可行但完全不推荐,零售市场买不到服务器专用的持续供电电源和机箱风道设计,更重要的是消费级主板不支持RDIMM内存,ECC纠错功能无法启用,多GPU也无法通过NVSwitch互联,非要在个人电脑上跑计算任务,建议直接买一台二手双路至强工作站,比如戴尔T7920,比攒机稳定得多。
问:运行计算服务器和云服务器怎么选?
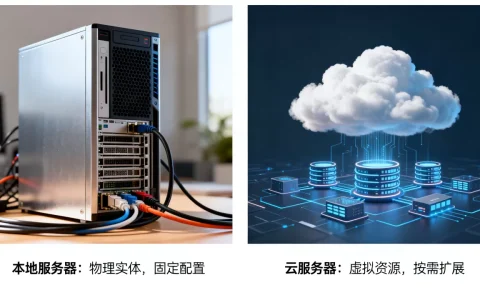
单次任务时间小于2个月的项目,云服务器更省事;长期固定负载务必自建,若预算有限但注重合规,可以关注政务云或国资云推出的“算力券”,能直接抵扣物理机租用费用,据工信部相关指导文件,该类补贴旨在降低中小企业实际落地成本,另外注意,涉及“涉密或核心研发数据”的场景就别上公有云了,数据回传带宽和泄密风险不划算。
问:国产CPU的计算服务器现在能打吗?
近年来信创领域规模明显扩大,海光C86、华为鲲鹏920和飞腾S2500在OFFICE办公和Web服务场景已能替代传统方案,但科学计算场景下,海光C86由于兼容x86指令集,跑GROMACS、VASP等常见软件问题不大;如果是ARM架构的鲲鹏或飞腾,这些软件的源码和依赖库支持仍不完整,照着官方文档编译往往要额外耗费两周以上时间。
一句话总结:运行计算服务器的本质是算力、存储和调度三者平衡的硬件系统,选型时不要被参数表迷惑,回到你的计算任务本身,算清极限负载和长期成本,才能让花出去的每一分钱都转化为可用算力。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/786517.html