网络层清洗依靠访问控制与黑洞路由阻断异常,核心做法是先用ACL按五元组精确筛掉已知异常,再用RTBH把持续被打的目标IP快速黑洞止损;ACL负责“筛”,黑洞负责“断”,顺序和边界不能乱。这套组合不能替代清洗中心,但在突发流量打满链路前,往往是最先生效的两道闸门。
网络层清洗依靠访问控制与黑洞路由阻断异常:先把两道闸门分工说清
网络层清洗不是一上来就把流量全丢,全丢等于业务下线,误杀范围不可控,更稳的做法是分层处理:能识别的异常交给访问控制列表,持续大流量打单IP交给黑洞路由,核心业务再引到清洗中心。
访问控制列表怎么在入方向挡住异常流量
ACL适合处理“已知的坏流量”,比如固定恶意源IP、异常目的端口、被利用的反射服务端口,关键动作是:在路由器或交换机接口的入方向应用,规则顺序先deny后permit,并给deny加日志采样。
实操路径可以按这个顺序走:
- 明确业务白名单:目的IP、协议、端口、源地址段。
- 把确认异常的源IP或端口写成deny规则。
- 最后放行正常业务流量,避免默认拒绝导致业务中断。
- 在接口入方向应用ACL,先小范围观察命中计数。
- 日志只采样记录,不要全量打印,防止设备CPU被日志拖垮。
Cisco风格的关键片段如下,实际语法按厂商调整:
ip access-list extended EDGE-IN
 deny ip host 198.51.100.23 any log
 deny tcp any host 203.0.113.10 eq 23
 permit ip any any
interface GigabitEthernet0/0/1
 ip access-group EDGE-IN in
这里192.0.2.0/24、198.51.100.0/24、203.0.113.0/24都是文档示例地址,生产环境不要直接照抄源IP,要先看流量采样和告警来源,ACL的优点是粒度细,缺点是规则越多维护越重,接口性能也有开销,临时封禁表要设置过期时间,避免几个月后还在误封老客户。
黑洞路由怎么做到分钟级止损
黑洞路由RTBH解决的是另一个问题:某个目标IP被持续大流量攻击,ACL规则来不及跟,链路已经快被打满,此时把目标IP的/32路由指向Null0,再通过BGP把这条路由和黑洞社区发给上游,让流量在上游被丢弃。
它适合短时止损,不适合长期防护,因为目标IP会完全不可达,正常用户也进不来,所以业内专家指出,RTBH的关键不在“会不会配”,而在授权、回退和影响范围控制。
配置前先确认三件事:
- 上游是否支持RTBH,黑洞社区值是多少,不要自行猜。
- 允许黑洞的前缀长度,通常只允许单IP /32。
- 谁有权触发,多久自动撤销,有没有值班工单记录。
两道闸门怎么配合不误伤业务
顺序上,ACL先上,RTBH后上,ACL处理可识别的异常源和端口,RTBH处理“目标IP已经被打穿”的紧急情况,核心业务、支付接口、登录入口不要轻易黑洞,优先用FlowSpec限速或清洗中心引流。
一个可落地的判断流程:
- 告警出现,先看流量方向和目的IP。
- 能定位恶意源或异常端口,先加ACL临时封禁。
- 单IP流量持续上涨,ACL跟不上,再评估RTBH。
- 核心业务被打,直接走清洗中心或上游FlowSpec。
- 每次处置后记录命中规则、生效时间、回退时间。
行业共识认为,RTBH是止损工具,不是清洗替代品,把它当长期防护,业务可用性会被误伤拖垮。
云清洗和本地清洗哪个更划算:看攻击场景不看单价
这个问题不能只比报价单,云清洗和本地清洗的成本结构不同,适合的场景也不同,2026年流量型攻击更常见的是混合攻击,单看清洗峰值容易漏掉引流和运营成本。
三种方案的成本结构对比
| 手段 | 作用层 | 适合场景 | 主要代价 |
|---|---|---|---|
| 访问控制ACL | 三层/四层 | 已知恶意源、异常端口、临时封禁 | 规则维护、接口性能开销 |
| 黑洞路由RTBH | 路由层 | 单IP持续大流量、短时止损 | 目标完全不可达、误伤面大 |
| FlowSpec | 路由层 | 精细化丢弃、限速、按协议处理 | 设备与上游支持要求高 |
| 云清洗中心 | 引流清洗层 | 核心业务、混合攻击、持续防护 | 保底费用、引流复杂度 |
本地清洗的优势是可控,数据不出机房,适合有专门网络团队和清洗设备的IDC,云清洗的优势是弹性,攻击峰值超过本地设备能力时,引流到清洗中心更稳,混合方案常见做法是本地ACL和RTBH做第一层止损,清洗中心做第二层兜底。
北京网络层DDoS清洗服务价格怎么判断
北京网络层DDoS清洗服务价格差异大,原因通常不在“清洗”两个字,而在计费口径,判断报价时重点看五项:
- 保底带宽:保底10G和保底100G,价格不在一个量级。
- 清洗峰值:按清洗能力买,还是按攻击峰值临时弹性。
- 引流方式:BGP引流、DNS调度、Anycast,部署复杂度不同。
- SLA:告警响应、清洗生效时间、回退责任是否写清。
- RTBH运营:是否包含黑洞社区配置、授权流程和值班支持。
同一城市不同机房到清洗中心的链路不同,回注路径也会影响体验,只比“每G多少钱”容易漏掉后续运营成本,据工信部公开的网络安全信息,针对云服务和IDC的流量型攻击仍是常见风险之一,报价单里写清保底、峰值和回退责任,比单纯压单价更有意义。
中小IDC机房DDoS清洗方案怎么落地
中小IDC不必一开始就堆全套设备,可以按资产分级落地:
- 核心业务IP:不直接RTBH,优先FlowSpec限速和清洗中心。
- 普通业务IP:ACL封已知恶意源,设置临时封禁过期时间。
- 测试和边缘IP:可纳入RTBH快速止损名单。
- 上游联动:提前确认黑洞社区和FlowSpec支持情况。
- 演练:每季度模拟一次攻击,验证从告警到封禁的路径。
操作上,先把资产清单和业务端口白名单整理出来,没有清单,ACL很容易误封,再建一张临时封禁表,记录IP、原因、触发人、过期时间,最后把RTBH授权收到值班主管,不要人人可触发。
网络层清洗黑洞路由怎么配置:演练、上线与回退
上线前的三项确认
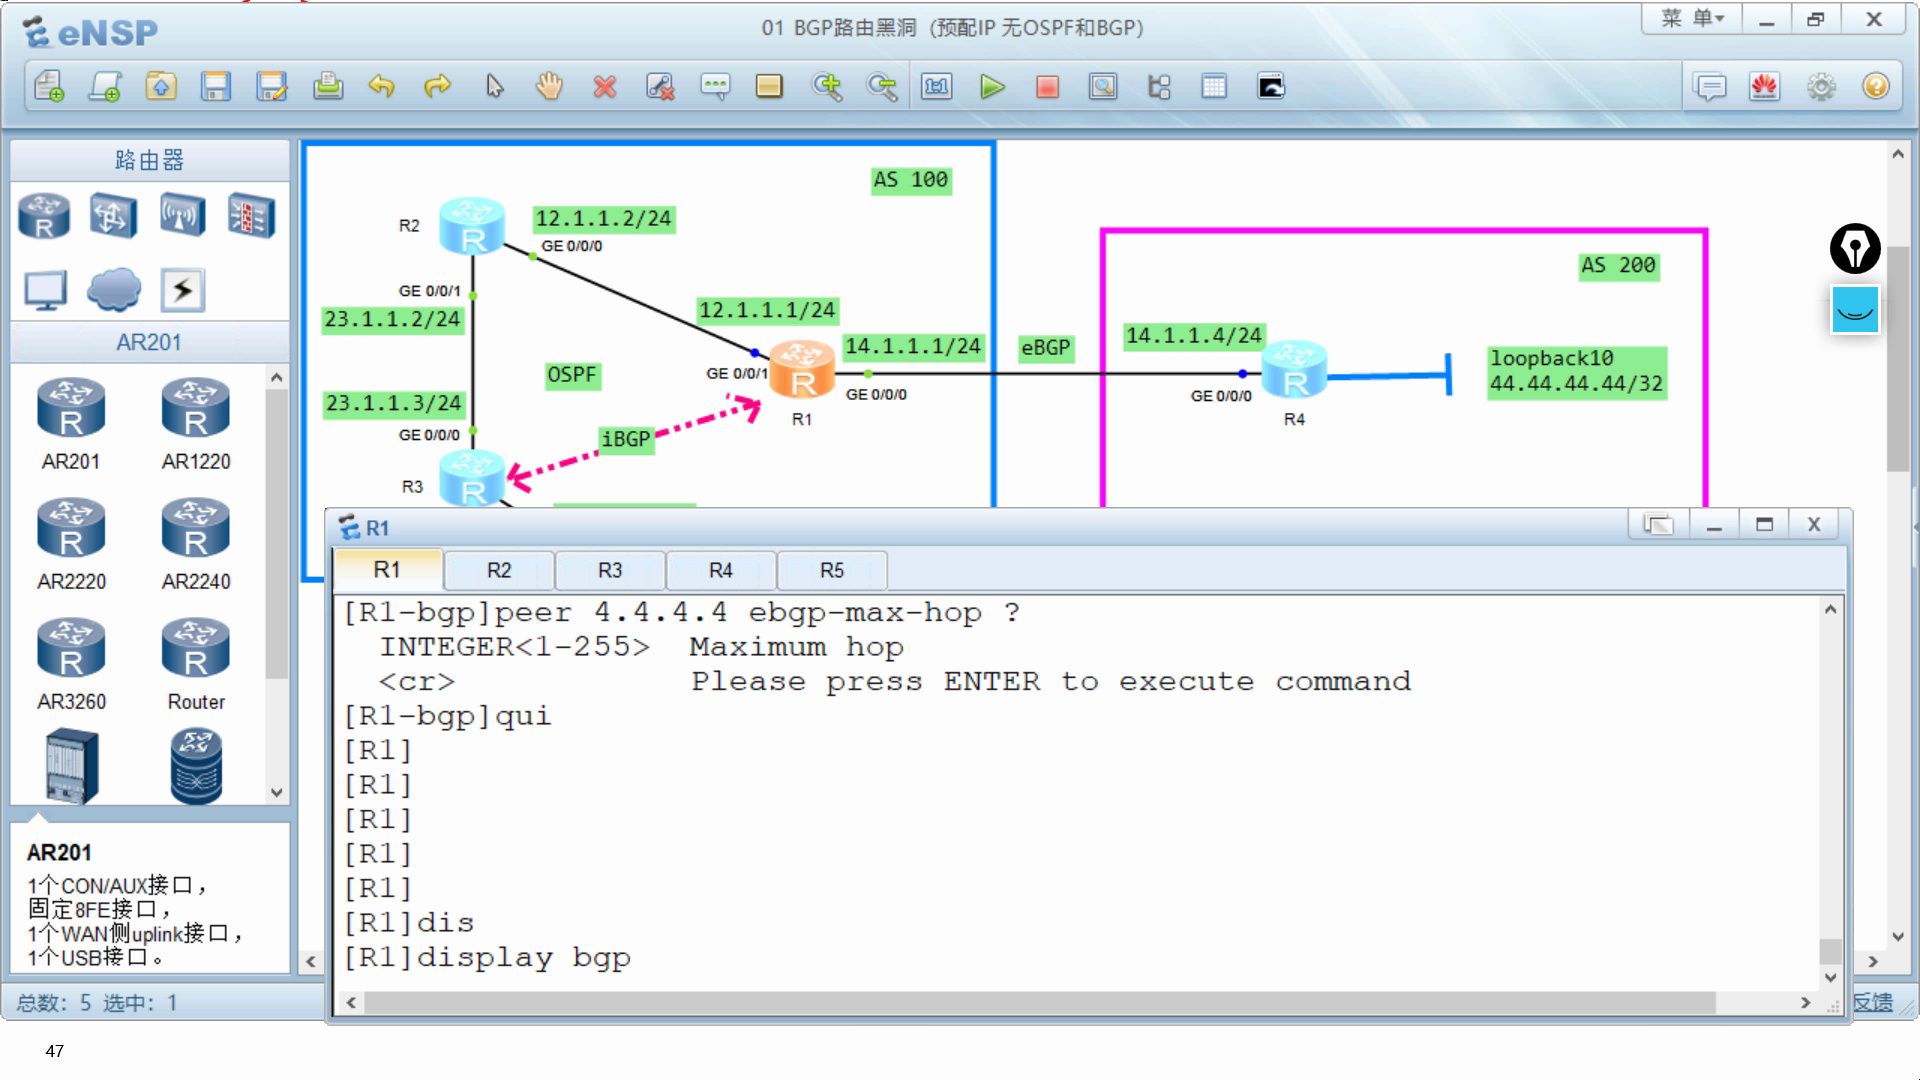
黑洞路由配置不难,难在边界,上线前确认上游社区值、允许前缀长度、自动回退时间,社区值以运营商分配为准,示例里的65000:666只是占位,不能直接套用。
配置与验证路径
Cisco风格的关键片段如下:
ip route 203.0.113.10 255.255.255.255 Null0 tag 666
route-map RTBH-OUT permit 10
 match tag 666
 set community 65000:666 no-export
route-map RTBH-OUT permit 20
router bgp 65000
 redistribute static
 neighbor 198.51.100.1 send-community
 neighbor 198.51.100.1 route-map RTBH-OUT out
生产环境要用前缀列表约束重分发范围,避免把不该通告的静态路由带出去,验证时看三个点:
show ip route 203.0.113.10确认指向Null0。show bgp ipv4 unicast 203.0.113.10确认路由已通告。- 从外部做
traceroute,确认流量在上游被丢弃。
回退与监控
回退动作要提前写进预案:删除Null0静态路由,或撤销黑洞社区,等待BGP收敛,监控要同时看业务可用性和误杀告警,黑洞期间目标IP不可达是预期结果,但不能让它悄悄挂几个小时,自动回退时间建议按业务等级设置,核心业务缩短,边缘业务可适当放宽。
网络层清洗依靠访问控制与黑洞路由阻断异常:常见问答
访问控制列表和黑洞路由应该谁先触发?
ACL先触发,因为粒度细、影响面小,RTBH后触发,因为目标IP会完全不可达,核心业务被打时,优先FlowSpec限速或清洗中心引流,不要直接黑洞。
黑洞路由会不会误伤正常用户?
会,黑洞路由会让目标IP的所有流量不可达,正常用户也进不来,所以只对非核心IP、边缘业务或短时止损使用,并设置自动回退和值班授权。
北京网络层DDoS清洗服务价格为什么差异大?
差异主要来自保底带宽、清洗峰值、引流方式、SLA和是否包含RTBH运营支持,报价单里不写清保底、清洗峰值和回退责任,后续运营成本通常更难控制。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/787236.html