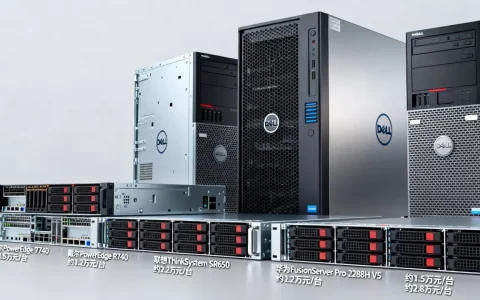
AI服务器能干的事远超常规计算设备,它既是训练大模型的“发动机”,也是企业落地AI应用的“中枢神经”,核心价值在于用并行计算能力加速一切数据密集型任务。
AI服务器的核心应用场景
大模型训练与微调
近两年大模型热潮中,真正承担“炼丹”任务的就是AI服务器,以行业常用的8卡GPU服务器为例,训练一个千亿参数模型动辄需要几百台服务器并行工作数周,这期间,服务器内部的NVLink高速互联、高带宽内存以及液冷散热系统都处于满负荷运转状态。
对于中小企业而言,完整的预训练成本过高,多数情况下选择开源模型做微调,在AI服务器上部署LoRA或QLoRA方案,单机即可完成垂直领域模型的适配训练,业内专家指出,一套搭配4张RTX 4090或L40S显卡的服务器,就能满足大部分中小型企业的微调需求。
“AI服务器能跑大模型吗”是搜索频率很高的问题,核心取决于显存容量,一张24GB显存的显卡最多支持约7B参数的模型全精度推理,量化后则可以运行13B甚至更大的模型。
AI推理与实时服务
训练只是一次性的投入,推理才是持续产生的算力消耗,当模型训练完成后,AI服务器需要承担面向用户的实时推理任务:
- 智能客服系统:自然语言理解、意图识别、知识库检索,每次交互都触发一次模型推理审核:图片分类、文字过滤、视频内容识别,处理千万级请求需要稳定的吞吐能力
- 个性化推荐:电商平台的推荐算法、短视频的流量分发,背后都需要实时计算用户特征
推理场景更看重延迟和吞吐量的平衡,与训练场景追求极致算力不同,推理服务器常选用T4、L4、A10等性价比更优的显卡方案。
垂直行业的多模态应用
AI服务器的应用范围早已突破文本对话,在制造业,视觉质检服务器每天分析数万张产线照片,通过目标检测模型识别瑕疵品,替代人工目检,效率和稳定性均有明显提升。
医疗领域内,搭载医学影像模型的AI服务器帮助放射科医生标记肺结节、骨折等疑似病灶,处理一份CT影像的时间从十几分钟缩短到几十秒,缓解了大医院影像科的压力。
创作领域,设计师用部署了Stable Diffusion的AI服务器批量生成电商详情页素材,一次出图数量可达常规制图软件的数十倍,数字人直播、短视频配音、脚本生成等应用,更是建立在推理服务器的实时响应之上。
AI服务器与普通服务器的关键区别
很多准备上AI项目的团队会困惑“ai服务器和普通服务器有什么区别”,两者的核心差异体现在硬件架构和任务分工上:
| 对比维度 | AI服务器 | 普通服务器 |
|---|---|---|
| 核心硬件 | GPU/NPU为主,CPU辅助 | CPU为主 |
| 计算模式 | 大规模并行计算 | 逻辑运算与串行处理 |
| 存储带宽 | 高带宽HBM显存,NVLink互联 | 常规DDR内存,PCIe通道 |
| 能耗水平 | 单机功率1500W-8000W | 单机功率300W-1000W |
| 适用任务 | 矩阵运算、张量处理、模型推理 | 数据库、网站托管、API接口 |
| 采购成本 | 5万-200万不等 | 1万-10万为主流区间 |
普通服务器处理的是指令流,AI服务器处理的是数据流,不存在谁完全替代谁,绝大多数机房都是AI服务器与普通服务器混布,前者提供计算能力,后者负责网络请求分发和结果回传。
AI服务器部署与采购的实操路径
自建机房和租用云算力怎么选
“ai服务器多少钱一台”是决策者最关注的问题,以市场上主流的方案来看:
- 单卡RTX 4090工作站级别:3万-5万元,适合个人开发者和算法工程师
- 4卡4090服务器整机:8万-12万元,满足中小团队微调和推理需求
- 8卡A800/H800服务器:80万-120万元,面向大模型训练和大型企业业务
- 8卡L20/L40S服务器:40万-60万元,兼顾训练与推理的均衡方案
做决策前必须先算“效能账”,如果GPU年利用率预估不足三成,租用云GPU实例远比自购划算,以简米云、酷番云、火山引擎的租用价格来看,单卡A100按小时计费在20-40元区间,一个月不间断跑满约1.5万-3万元,三年租用成本约等于一张高性能显卡的售价。
自建方案的优势在于数据安全可控和数据主权清晰,适合金融、政务、医疗等强监管行业,灵活部署方面,中小团队可以先租云GPU验证模型效果,再考虑自建。
从购买到上线的五个步骤
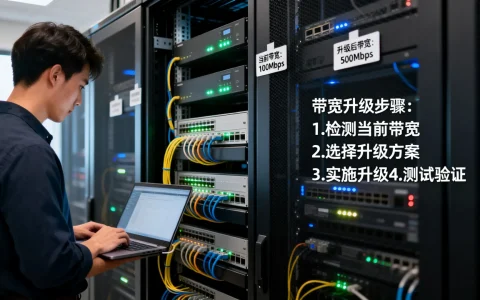
- 需求盘点:明确峰值并发量、模型参数量、推理延迟要求,据此推算显存总量和GPU卡数
- 硬件选型:训练场景优先算力密度,选H800、A800、L40S;推理场景优先显存容量和能耗比,选L20、T4、4090
- 基础环境搭建:安装Ubuntu Server系统,配置NVIDIA驱动和CUDA工具链,再部署Docker容器环境
- 框架安装:安装PyTorch、TensorFlow或国产框架PaddlePaddle,配置Python虚拟环境
- 业务对接:将模型文件通过模型服务化框架(如vLLM、Triton)发布为API接口,接入业务系统
液冷改造正在成为趋势
单张A100显卡的功耗达到400W,一台8卡满载服务器功率超过6.5kW,风冷方案在如此高的热密度下显得力不从心,近年来,液冷服务器在新建智算中心中的占比持续提升,液冷方案将PUE从1.5降到1.1以下,虽然初期采购成本高一些,长期运行的电费节省相当可观。
长三角、珠三角的智算中心大都强制要求新建机柜支持液冷,多数服务器厂商在交付AI服务器时都提供风冷和液冷两种选项,采购前要确认机房是否具备液冷改造条件。
AI服务器的运维挑战
AI服务器不是买回来插上电就能稳定运行,它比其他任何IT设备都更“娇贵”:
- 驱动兼容性:GPU驱动和CUDA版本不匹配是故障第一来源,通常一套稳定运行的环境由特定驱动版本、特定容器镜像和固定CUDA版本共同锁定
- 显存ECC纠错:在高负载状态下显存可能出现单比特翻转,导致训练中断,定期运行显存自检程序,使用纠错码内存可以提前发现故障隐患
- 多卡通信瓶颈:数据并行训练中,梯度同步占据大量通信时间,使用NVLink全互联架构而非普通PCIe交换,能显著提升多卡扩展效率
在人员配置上,多数传统企业没有专职的AI运维工程师,普遍做法是找服务器厂商的增值服务团队做维保,或使用云厂商的托管集群服务。
AI服务器会取代传统服务器吗
行业共识认为,未来数据中心的形态是异构算力融合,通用计算仍然承担业务逻辑和存储调度,AI服务器专注张量计算,两者各有定位、协同工作。
从企业进化的角度,AI能力正在成为基础设施的一等公民,越来越多的行业软件原生融入模型能力,比如数据库内置向量检索、ERP系统自带智能分析、客服平台标配大模型插件,这些功能落到硬件层面都需要在机房中加入AI算力节点。
企业在做2026年的IT规划时,AI服务器的预算占比不应再被归入“创新项目”或者“试点投入”,而应当作为与存储、网络并列的核心基础设施来安排。
AI服务器选型与部署的常见问题
中小企业怎么选AI服务器性价比更高
如果主要任务是跑推理和轻量微调,选择搭载2-4张L20或L40S显卡的服务器即可,单机投资控制在15万以内,这类机器放在办公区旁边噪音尚可接受,供10-50人规模的技术团队使用绰绰有余,如果训练压力持续增加,优先扩容GPU节点而不是更换整机。
国内AI服务器哪家比较好
国内主流的AI服务器厂商有浪潮信息、新华三、宁畅、超聚变、宝德等,产品同质化程度较高,核心差距在交付周期、售后响应速度和液冷方案成熟度,浪潮信息在互联网大厂订单中份额领先,宁畅主攻高密度液冷方案,宝德在政企市场渠道较深,选购时重点比较故障响应时效和备件库覆盖城市,这两项比纸面硬件参数更能反映真实服务水平。
AI服务器部署难不难,需要什么样的技术人员
基础推理环境部署大约需要一周,前提是具备Linux操作经验,至少要有一名熟悉Python和Docker的工程师负责环境维护,模型微调则还需要一名算法工程师,如果团队内部没有相关能力,可以依赖AI服务器厂商的部署服务完成初始化,或选择云厂商的GPU容器服务直接跳过硬件环节。
算力基础设施的选型考虑的是未来三到五年的业务演进,AI服务器的核心意义不在于跑分和数据,而在于它承载的是企业数字化升级的智能底座,从训练到推理、从视觉到语言、从云端到边缘,AI服务器的价值最终体现在业务实效上,无论是自建还是租用,越早建立AI算力规划,越能在下一轮行业变革中占得先机。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/787422.html