从并发估算到GPU选型的完整落地路径
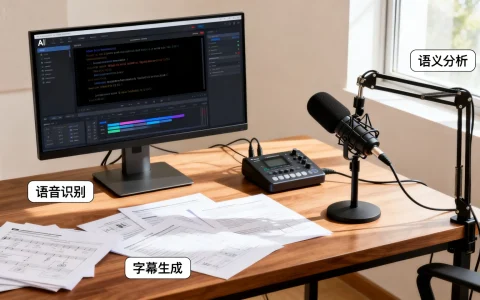
语音识别业务上线前的算力准备,核心就三件事:用峰值并发反推GPU数量,按实时流式与离线转写分开做容量规划,再预留1.5到2倍冗余并用真实音频压测验证,把这三步做完,采购或租用才不会拍脑袋。
很多团队在模型效果调得差不多时才开始想算力,结果要么上线当天排队严重,要么买多了卡在机房里吃灰,算力准备本质是一道工程算术题,不是玄学,下面按实际落地顺序拆开讲。
语音识别上线前需要准备多少算力:从并发路数反推GPU数量
先明确一个概念:语音识别的算力消耗不能只看”多少用户”,要看”同时有多少路音频在跑”,实时流式场景下,每路音频持续占用推理资源;离线转写则是批量任务,按音频总时长折算,两者混在一起估算,必然算错。
语音识别并发路数怎么估算:三个系数定容量
业内常用的粗算模型是这样的:
- 峰值并发 = 日活用户数 × 峰值时段活跃比例 × 语音功能触发率
- 单卡承载路数 = 通过压测得到的稳定并发值,再打八折作为安全值
- 所需卡数 = 峰值并发 ÷ 单卡安全承载路数 × 冗余系数
冗余系数通常取1.5到2,为什么?模型更新、单卡故障、突发流量都得留出空间,一个常见的误区是拿平均并发去买卡,上线后第一个晚高峰就会被打回原形。
单卡到底能扛多少路,和模型结构强相关,中等规模的流式模型,在推理卡上单路实时率(RTF)通常远小于1,意味着实时性有富余,真正瓶颈往往在显存和批处理调度上,行业共识认为,流式识别场景下批处理策略对吞吐的影响,有时比换一张更贵的卡还明显。
实时流式与离线转写的算力要分开算
这两类业务的资源特征完全不同:
- 实时流式识别:长连接、低延迟敏感,关注首字延迟和尾点延迟,GPU利用率波动大,适合独立资源池。
- 离线音频转写:批量提交、延迟容忍度高,适合用队列削峰,甚至可以跑在闲时资源或抢占式实例上。
- 混合部署的坑:把离线任务和实时任务放同一张卡,离线批量一上来就会把实时请求的P99延迟拉爆,建议物理隔离或用MIG切分。
实操上可以先用ffmpeg把历史音频按真实时长切片,回放压测,观察RTF和队列长度两个指标,比看理论值靠谱得多。
语音识别GPU服务器选型对比:别在推理场景盲目上旗舰卡
选型这件事,训练和推理要分开看,语音识别业务上线后,绝大部分算力花在推理上,而推理看重的是显存容量、显存带宽和能效比,不是单纯的浮点算力峰值。
推理卡与训练卡的取舍逻辑
- 训练阶段:需要大显存和高互联带宽,用于模型微调、数据并行,卡数不多但单卡规格要高。
- 推理阶段:追求单位成本下的并发吞吐,中端推理卡往往比旗舰训练卡更划算。
- 国产卡:在信创要求明确的场景下需要提前适配,重点是算子库和推理框架的支持程度,别等上线前才发现某个算子没实现。
下面这张表把常见档位做个相对对比,具体型号和价格以实际询价为准。
| 卡型档位 | 显存特征 | 适用场景 | 采购倾向 |
|---|---|---|---|
| 入门推理卡 | 16GB级 | 小模型流式识别、试点验证 | 租赁优先,验证后再买 |
| 中端推理卡 | 24-48GB | 主力流式识别、中等并发 | 采购与租赁均可 |
| 高端训练卡 | 80GB级 | 模型微调、大模型推理 | 按训练周期租赁更灵活 |
| 国产加速卡 | 视型号而定 | 信创合规场景 | 先做算子适配验证 |
显存带宽往往比算力更关键
语音识别模型单次推理的计算量不算大,但音频帧序列长、中间激活多,显存带宽不够,GPU计算单元就会等数据,选型时建议重点看三个指标:显存容量能否放下模型加批处理激活、显存带宽是否匹配吞吐需求、单卡功耗是否超出机房供电上限。
业内专家指出,推理集群的实际瓶颈常常出现在调度层和预处理环节,而不是GPU本身,音频解码、重采样、特征提取这些CPU侧工作如果没做好,GPU利用率会一直上不去。
私有化部署语音识别算力成本:一次性采购和租赁怎么选
成本这块最容易算漏,采购价只是冰山一角,电费、机房托管、运维人力、折旧周期都要摊进去。
成本构成拆解
- 硬件采购:GPU服务器整机,含CPU、内存、NVMe存储,音频数据量大时存储别省钱。
- 机房与电力:单机柜功率密度、带宽、冗余电源,一线城市机房成本明显更高。
- 软件授权:推理框架商业版、调度平台,部分方案按卡或按路数计费。
- 运维人力:驱动升级、故障替换、容量巡检,长期看是持续支出。
华东地区语音识别算力租赁的适用场景
业务波动大、上线初期不确定并发规模的团队,先租后买更稳妥,华东地区语音识别算力租赁的供给相对充足,适合做上线前的压测环境和突发流量兜底,租赁时要问清三件事:是否独享整卡、网络带宽是否计费、故障响应时间写不写进合同,按卡时计费的方案,适合离线转写这类可中断任务;实时业务则建议签独享资源。
上线前的算力准备清单:照着逐项打钩
前面是账,这里是清单,建议在上线前两周完成全部验证。
环境与软件栈验证
- 确认CUDA、cuDNN与推理框架版本匹配,执行
nvidia-smi核对驱动版本和显存占用。 - 用
nvidia-smi topo -m检查多卡互联拓扑,避免跨NUMA节点通信拖慢批处理。 - 部署Triton或同类推理服务,验证模型加载耗时和动态批处理配置。
- 在Kubernetes环境下确认GPU device plugin正常,执行
kubectl describe node查看卡资源是否被正确调度。
压测与监控
- 用真实业务音频回放,模拟峰值并发,持续压测至少2小时。
- 重点采集四项指标:RTF、首字延迟、P99响应时间、GPU显存峰值。
- 用dcgm-exporter采集GPU指标,接入Prometheus,配置显存和队列长度告警。
- 做一次单卡故障演练,验证流量能否自动摘除和迁移。
容灾与扩容预案
- 预留至少一个可快速启用的备用节点,或提前开通云上弹性资源。
- 明确扩容触发阈值,例如队列长度持续超过设定值几分钟就告警。
- 记录本次压测的单卡承载路数,作为后续容量规划的基线数据。
语音识别算力准备常见问题解答
语音识别上线前,消费级显卡能用来做推理吗?
小规模试点可以,正式上线不建议,消费级卡缺少数据中心级的散热和长时间满载稳定性设计,也通常不支持vGPU切分和ECC显存,业务一旦跑起来,稳定性比省下的采购差价重要得多。
实时语音识别和离线转写能共用一套算力池吗?
技术上可以,通过队列和优先级调度实现隔离,但前提是资源池足够大且调度策略足够细,多数情况下,两类任务混部会互相干扰,尤其是离线批量任务容易抢占实时请求的资源,稳妥做法是分池部署,或至少用MIG做物理切分。
语音识别算力准备清单里最容易被忽略的是哪一项?
音频预处理链路的CPU资源,解码、重采样、VAD切分都在CPU侧完成,这部分配置不足会直接导致GPU等数据、利用率虚低,压测时需要同时观察CPU使用率和GPU利用率,两者不匹配就说明预处理成了瓶颈。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/788659.html