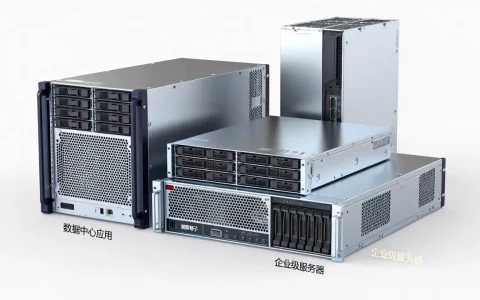
创新服务器系统并非单一产品,而是涵盖异构计算、软件定义、液冷散热、边缘部署四大方向的整机与架构体系,企业选型的核心逻辑是先锁定业务场景,再匹配硬件形态与软件栈,而不是反过来追新求异。
创新服务器系统有哪些类型与形态
把“创新”拆开看,服务器系统的进化主要沿着算力密度、能效比、部署位置三条线走,下面按硬件形态和软件架构两个维度梳理。
异构计算服务器:GPU与专用加速卡成标配
传统通用CPU服务器在处理AI推理、视频编解码、科学计算时开始吃力,异构计算服务器把CPU与GPU、FPGA、ASIC等加速器装进同一机箱,通过高速互联总线(如PCIe 5.0/6.0、NVLink)共享内存与带宽。
业内专家指出,当前主流AI训练集群中,加速卡与CPU的配比已经从此前的1:8向1:4甚至更高密度演进,具体落地时,常见形态包括:
- GPU训练服务器:8卡或16卡整机,适合大模型预训练与微调
- 推理优化服务器:低功耗加速卡加高主频CPU,侧重吞吐与延迟平衡
- FPGA可编程服务器:金融风控、基因测序等需要低延迟自定义流水线的场景
部署这类系统时,运维人员需要在BIOS中开启Above 4G Decoding和大BAR支持,并在操作系统侧加载对应加速卡驱动(如NVIDIA Data Center Driver),再用nvidia-smi或rocm-smi验证设备识别状态。
液冷服务器系统:从冷板到浸没的两条路线
风冷散热在单机柜功率突破20kW后开始遇到瓶颈,液冷服务器系统通过液体介质直接或间接带走热量,常见两种形式:
- 冷板式液冷:冷却液流经贴在CPU/GPU上的冷板,改造成本相对低,适合存量机房渐进升级
- 浸没式液冷:整机或主板浸入绝缘冷却液中,散热效率更高,但对硬盘、电源等部件的耐液性有额外要求
据工信部相关节能技术目录信息,液冷方案在同等算力下可显著降低数据中心PUE,实际操作中,冷板式液冷服务器部署前需要确认机房是否具备一次侧冷源和二次侧分液器接口,管路连接后要做保压测试,确认无渗漏再上电。
边缘服务器系统:把算力推到离数据最近的地方
工厂车间、零售门店、基站机房这些场景,把数据全部回传云端既不经济也不满足时延要求,边缘服务器系统通常采用短机箱、宽温设计、无风扇或低转速风扇,支持DC-48V或宽压交流输入。
典型配置是单路CPU加少量加速卡,预装轻量级容器运行时(如containerd或CRI-O),通过K3s或MicroK8s做编排,现场部署时,运维人员常用kubectl get nodes -o wide确认边缘节点状态,并通过GitOps工具下发应用配置。
软件定义与超融合系统:硬件资源池化的推手
超融合基础设施(HCI)把计算、存储、网络虚拟化打包到标准x86服务器上,通过分布式存储软件把本地硬盘组成共享存储池,近年来国内多家厂商推出自研超融合系统,支持一键扩容和跨集群迁移。
从运维角度看,超融合系统的价值在于把“采购服务器+采购存储+采购交换机”的分散流程变成“加节点”一个动作,扩容时通常只需将新节点加入集群,运行cluster-add-node类命令完成纳管,数据会自动重平衡。
企业如何选择创新服务器系统:场景与需求匹配指南
创新服务器系统和传统服务器哪个好先看业务负载特征
这个问题没有统一答案,但有清晰的判断框架:
| 对比维度 | 传统通用服务器 | 创新服务器系统 |
|---|---|---|
| 适用负载 | Web服务、轻量数据库、文件共享 | AI训练推理、高性能计算、边缘实时处理 |
| 算力密度 | 单机柜10-15kW常见 | 液冷方案可达30kW以上 |
| 部署周期 | 标准化上架,快速交付 | 涉及液冷管路或加速卡驱动,周期略长 |
| 运维复杂度 | 较低,工具链成熟 | 需要额外关注加速卡健康度、冷却液状态 |
| 初始投入 | 较低 | 异构与液冷方案前期成本较高 |
行业共识认为,当业务中AI推理请求占比持续上升,或者机房单柜功率密度逼近风冷极限时,就该认真评估创新服务器系统了,反之,如果业务以稳态Web应用为主,传统架构仍是性价比更高的选择。
具体选型步骤与验证方法
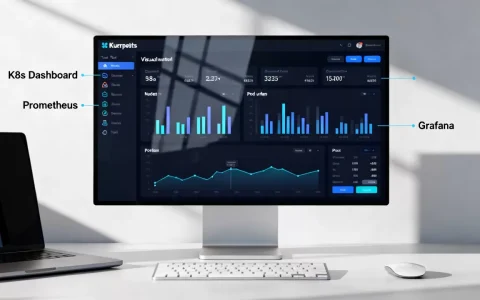
- 盘点负载类型:用监控工具(如Prometheus加Grafana)采集一周的CPU、内存、GPU利用率曲线,识别峰值特征
- 测算功率密度:统计单机柜实际功耗,超过15kW时把液冷方案纳入候选
- 确认机房条件:检查供电容量、承重、制冷方式,液冷方案需确认是否具备改造空间
- 小规模PoC验证:选2-4台目标机型跑真实业务镜像,对比吞吐、延迟和功耗
- 核算三年总拥有成本:把硬件、软件授权、电费、运维人力合并计算,而非只看采购单价
以AI推理场景为例,PoC阶段可以部署TensorRT-LLM或vLLM框架,用ab或wrk压测不同并发下的首token延迟和吞吐量,拿到数据再决策。
创新服务器系统部署要多少钱成本结构拆解
价格问题不能笼统回答,但可以拆开看构成。
硬件成本:加速卡与液冷套件是大头
一台8卡GPU训练服务器的硬件成本中,加速卡占据较大比例,液冷方案额外增加冷板、分液器、管路和冷却液的成本,冷板式改造成本通常低于浸没式,边缘服务器因为批量部署,单台成本相对可控,但现场安装调试的人力成本需要计入。
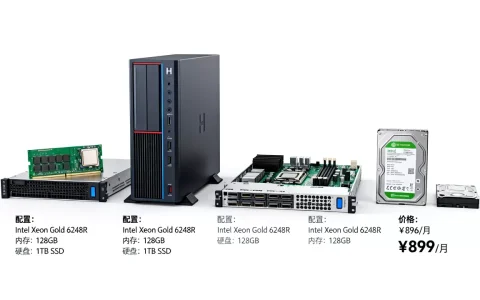
近年来国产加速卡和国产CPU的整机方案逐步成熟,在信创合规场景下提供了更多价格区间选择,采购时建议要求供应商提供整机BOM清单,逐项核对加速卡型号、内存容量、硬盘类型和电源冗余配置。
软件与运维成本:容易被忽略的部分
- 虚拟化/云平台授权:按CPU插槽或核心数计费,规模越大单价越低
- 加速卡管理软件:部分厂商的集群管理套件需要单独授权
- 液冷运维:冷却液需定期检测电导率和pH值,管路接头有更换周期
- 人力成本:异构算力运维需要具备CUDA/ROCm调优经验的工程师
实际操作中,可以用简单公式估算三年TCO:硬件采购价 + 软件授权×3 + 年电费×3 + 运维人力×3,液冷方案虽然硬件贵,但电费节省在三年周期内可能抵消差价,具体取决于当地电价和负载率。
地域与供应商选择
北京、上海、深圳等地的数据中心在液冷改造和异构算力部署上经验更丰富,本地供应商能提供更快的现场响应,中西部地区依托能源优势,大型训练集群的电力成本更有竞争力,选供应商时重点考察三点:是否有同场景落地案例、能否提供PoC样机、售后备件库距离多远。
创新服务器系统常见问题解答
创新服务器系统有哪些主流的国产化选项?
国产创新服务器系统已覆盖通用计算、AI加速、液冷整机和边缘形态,CPU侧有海光、鲲鹏等平台,加速卡侧有寒武纪、昇腾等系列,整机厂商基于这些核心部件推出自研或联合品牌服务器,选型时重点确认操作系统、数据库、中间件是否在目标平台的兼容性列表内,避免上线后出现驱动缺失或性能回退。
中小企业部署创新服务器系统从哪入手?
不建议一步到位上大规模集群,可以从一台边缘服务器或两台异构推理节点切入,先跑通容器化部署和监控告警链路,软件侧优先选用社区活跃的框架(如Kubernetes加Prometheus),硬件侧选择售后响应快、备件通用的品牌,等业务量增长、运维流程成熟后再横向扩展。
液冷服务器系统日常运维需要注意什么?
冷板式液冷系统需要定期检查管路接头是否有渗漏痕迹,监测冷却液进出温差和流量是否在正常区间,浸没式系统要关注冷却液的颜色和透明度变化,按厂商建议周期送检电导率,上电前务必确认液冷回路已充满且排尽气泡,否则局部热点可能触发降频保护。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/788711.html