模型训练中途换更大显存的机器,答案是肯定的,但你要做好断点续训的功课。训练跑了一半发现显存不够,或者想提速,这是深度学习老炮儿和新手都会遇到的尴尬事,换不换机器,关键不在于显卡插槽,而在于你的训练代码和checkpoint文件支不支持中途换乘。
模型训练中途换机器可以吗:断点续训是分水岭
很多人误以为深度学习训练跟烙饼一样,翻个面就得重新揉面,主流框架(PyTorch、TensorFlow)早就把“存档”功能做成了常规操作,行业共识认为,训练过程本质上是一个不断迭代参数的循环,每一次迭代产生的新权重、优化器状态、学习率调度器进度,都能序列化到磁盘上,业内专家指出,只要你有完整的checkpoint文件,换机器就是改改路径、动动加载代码的事。
检查你的训练脚本是否有续训逻辑
这是第一个分水岭,如果你的训练代码只在开头写了一个model.build(),从头开始迭代,那换机器就意味着之前烧掉的电费、占用的几百小时GPU时间全打水漂,判断标准很简单:你的训练循环里有没有类似if os.path.exists(checkpoint_path): load_checkpoint(...)的逻辑分支,没有?那先别急着租新机器,先把续训功能补上。
换机器后第一步不是跑代码,而是验证环境
新机器的CUDA版本、cuDNN、PyTorch编译版本如果和旧机器不一致,即使加载了权重,跑起来也可能报出诡异的RuntimeError: CUDA error: device-side assert triggered,大部分情况下,PyTorch的checkpoint文件是平台无关的,只保存张量数据,但PyTorch版本跨大版本(比如1.x到2.x)加载旧权重时,偶发兼容性警告,遇到时先升级或回退版本,确认无误再开启长训。
换到显存更大的机器,训练参数和路径怎么处理
换机器的核心操作,就像把家从60平米搬到120平米,你不用重新装修,但得把家具(模型权重)搬进去,再把水电(数据加载路径)接上。
显存迁移三步走:保存、搬运、加载
第一步,在原机器上保存完整快照,完整意味着不能只有model.state_dict(),必须包含接着训练的必备项,推荐打包保存为字典文件,
torch.save({
    'epoch': epoch,
    'model_state_dict': model.state_dict(),
    'optimizer_state_dict': optimizer.state_dict(),
    'scheduler_state_dict': scheduler.state_dict(),
    'loss': loss
}, 'checkpoint.pt')
第二步,把checkpoint文件传到新机器上,scp、rsync、网盘都行,这里有个反直觉的坑:文件传输完成后,先用CPU加载一次模型,跑一个前向推理,确认模型结构和权重匹配,再落到GPU上,因为GPU显存报错往往比CPU报错更晚,定位更难。
第三步,修改训练脚本里的加载路径和batch_size,显存变大了,通常意味着你可以把batch_size翻倍,这时候要记住:batch_size变了,学习率通常也要按比例调整(线性缩放法则),否则损失曲线大概率会原地抖腿。
多卡并行和单卡转移要注意什么
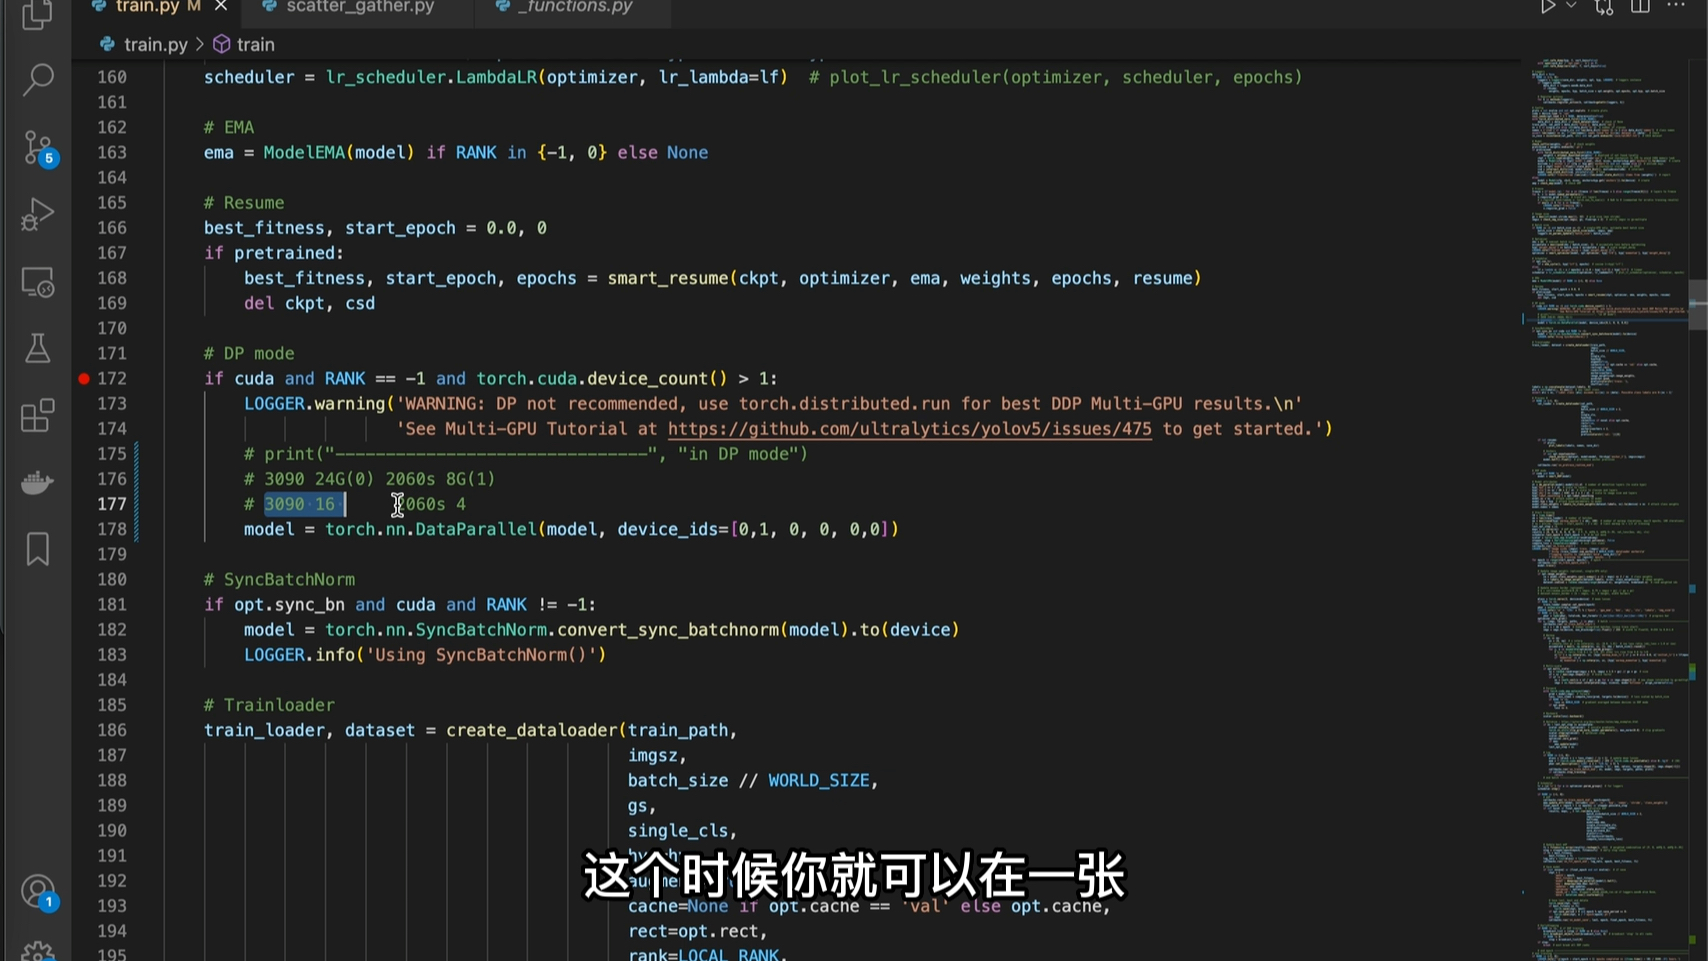
如果你从单卡A100换到单卡H100,代码几乎不用动,但如果从一张卡换到四张卡,或者从单机多卡换到多机多卡,情况就复杂了,对应的分布式代码(DDP或DeepSpeed)在加载checkpoint时,必须保证加载逻辑和保存时的并行策略一致,比如保存时用了DistributedDataParallel,加载时就不要用裸模型加载,否则权重名带不带module.前缀往往对不上,加载直接报键值不匹配的错误,解决办法是加载后再包DDP,或者用model = torch.nn.DataParallel(model)后加载。
实操中容易踩的坑:优化器状态和随机种子
这是换机器时最容易翻车的地方,比搬运权重本身更让人头疼。
优化器状态:Adam的动量不是玄学
Adam优化器内部存了每个参数的动量估计和方差估计,如果你图省事只保存了模型权重,换机器后从零开始用Adam训练,相当于一个人突然失忆,但身体还是那个身体。前期训练积累的方向感全没了,损失函数大概率先飙升一阵子再慢慢降回来,严重时直接发散,只要你想续训,就必须保存优化器状态,这属于行业公认的保命操作。
随机种子:数据顺序变了,损失曲线会抖
换机器后,DataLoader的shuffle顺序变了,数据增强的随机性也变了,即便权重和优化器都对,损失曲线也会出现一个明显的跳动,但这是正常现象,不代表代码出了问题,想要完全复现原训练节奏,就得把PyTorch的、NumPy的、Python的random种子全部固定下来,并在加载ckpt后手动重置一下RNG状态。
CUDA缓存和显存碎片化
新机器显存大,不一定代表能跑更大的batch,PyTorch的allocator非常“抠门”,它申请显存时是一个块一个块拿的,显存碎片化严重时,哪怕卡上还有十几GB剩余,也可能报CUDA out of memory,遇到这种情况,先设置os.environ['PYTORCH_CUDA_ALLOC_CONF'] = 'expandable_segments:True',这个参数在PyTorch 2.0以上效果尤其明显,加上之后,显存利用率会明显提升一个台阶。
什么时候换机器反而更麻烦
换机器并非银弹,在以下三个场景里,换机器带来的迁移成本可能比收益更大。
数据并行训练中断
多卡数据并行训练进行到一半,比如8卡崩了2张卡,这时候换机器,不是简单把checkpoint搬过去就完事,分布式训练有rank和world_size概念,torch.distributed包的初始化参数,进程组状态,这些都得重新配置,如果训练代码没有对分布式checkpoint做专门处理,大概率按文档跑都会报Address already in use或者Connection reset by peer。
模型并行跑大模型
当你用DeepSpeed ZeRO-3或张量并行来跑百亿参数模型时,checkpoint数据是按层、按分片分布的,这时候换机器、换显卡数量,意味着你需要重分片,操作复杂度直线上升,如果不熟悉框架的save/load流程,很容易把分片文件搞混,导致模型在某个层上加载错权重。
显存变小了
如果你是从24GB的3090换到16GB的V100,或者从A100换到消费级卡,那不是更轻松,而是更麻烦,显存变小,batch_size必须压缩,梯度累积步数必须增加,学习率又得重新调,这种情况下,建议优先考虑梯度检查点(gradient checkpointing)和混合精度训练,而不是换卡。
换机器前先解决显存碎片化
很多人的真实需求不是换机器,而是显存不够用了,但显存不够用,未必非换机器不可,有一个百试不爽的排查顺序:
- 先用
nvidia-smi看显存占用,如果显存占用率看着很高,但实际计算单元利用率很低,大概率是数据加载瓶颈,不是显存问题。 - 尝试梯度累积(gradient accumulation),把batch拆成micro-batch,显存占用瞬间降一个量级。
- 尝试混合精度训练(AMP),开启后显存占用通常能降低30%-50%,效果极其显著。
- 检查输入图片的尺寸,如果不是必须的,不要全都缩放到最大分辨率。
几个方案实践下来,多数情况下显存需求都会明显回落,如果全试过了还是爆显存,再考虑换机器,租卡方面,近年来云计算厂商按小时计费的GPU实例已经非常普及,相比一次性买新卡,租一台临时的高显存服务器是更划算的选择,以常见的租GPU服务器训练模型为例,价格和配置在不同地域差异不大,北京、上海、杭州等城市的算力中心机房价格,主要取决于卡型、续费时长和带宽,直接按需购买即可。
换机器后如何确认训练没跑偏
加载checkpoint并启动训练后,别急着干别的,认准三个信号来判断恢复状态是否健康:
- 第一,损失值应该在原训练轮次附近波动,不会出现断崖式飙升。
- 第二,验证集准确率应该维持在原水平附近,如果出现明显下降且长时间不回升,说明加载过程有遗漏。
- 第三,对比新旧机器的训练日志,确保训练数据集的shuffle顺序确实不同,但数据总量一致。
如果跟踪的是验证集损失剧烈升高后又快速下落,不用慌张,这是正常现象,持续跑几十个迭代就会回归正常。
问题答疑
Q:模型训练换显卡后,之前跑的步数还算数吗?
算数,只要保存了完整的checkpoint文件(权重、优化器、epoch计数),新机器就从指定epoch继续跑,损失的浮动和轻微振荡属于换机后的正常现象,通常在几十步内回归正常。
Q:换了更大的显存,batch_size能翻倍吗?
原则上能翻倍,但学习率也要跟着调,经验规则是batch_size翻倍时学习率也翻倍,但这个规则并非万能,更稳妥的做法是先用小学习率跑几十步,再切换到原有学习率。
Q:训练中途换机器,是否需要重新安装所有依赖?
需要,但不用从零开始,新建一个新的Conda环境,然后按原环境的requirements.txt安装即可,建议在启动训练前先跑一次10步的小训练,确认环境就绪,再跑全量训练。
Q:checkpoint体积太大,拷贝太慢怎么办?
常规做法是先压缩再传输,用tar -czf打包,如果模型本身是几十GB级别,建议改用共享存储(NFS或云盘),直接把checkpoint挂载到新机器上,省去拷贝时间。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/788768.html