在相同模型、相同序列长度和相同精度下,LoRA的显存需求通常只有全量微调的一小部分;7B模型用LoRA或QLoRA可以在24GB消费级卡上跑起来,而全量微调往往要动用多张80GB级显卡。 显存账不能只看参数量,得把权重、梯度、优化器状态和激活值拆开算,否则很容易在训练启动几分钟后遇到OOM。
LoRA微调和全量微调显存差多少?先看这笔显存账
全量微调会更新模型里的每一个参数,每个参数不仅要存权重,还要存梯度,Adam这类优化器还要保存一阶矩和二阶矩,混合精度训练下,行业里常用“每个参数需要十几个字节”来粗略估算参数状态占用,7B模型光参数状态就可能吃掉几十GB,再叠加激活值和临时缓冲,单张消费级卡基本扛不住。
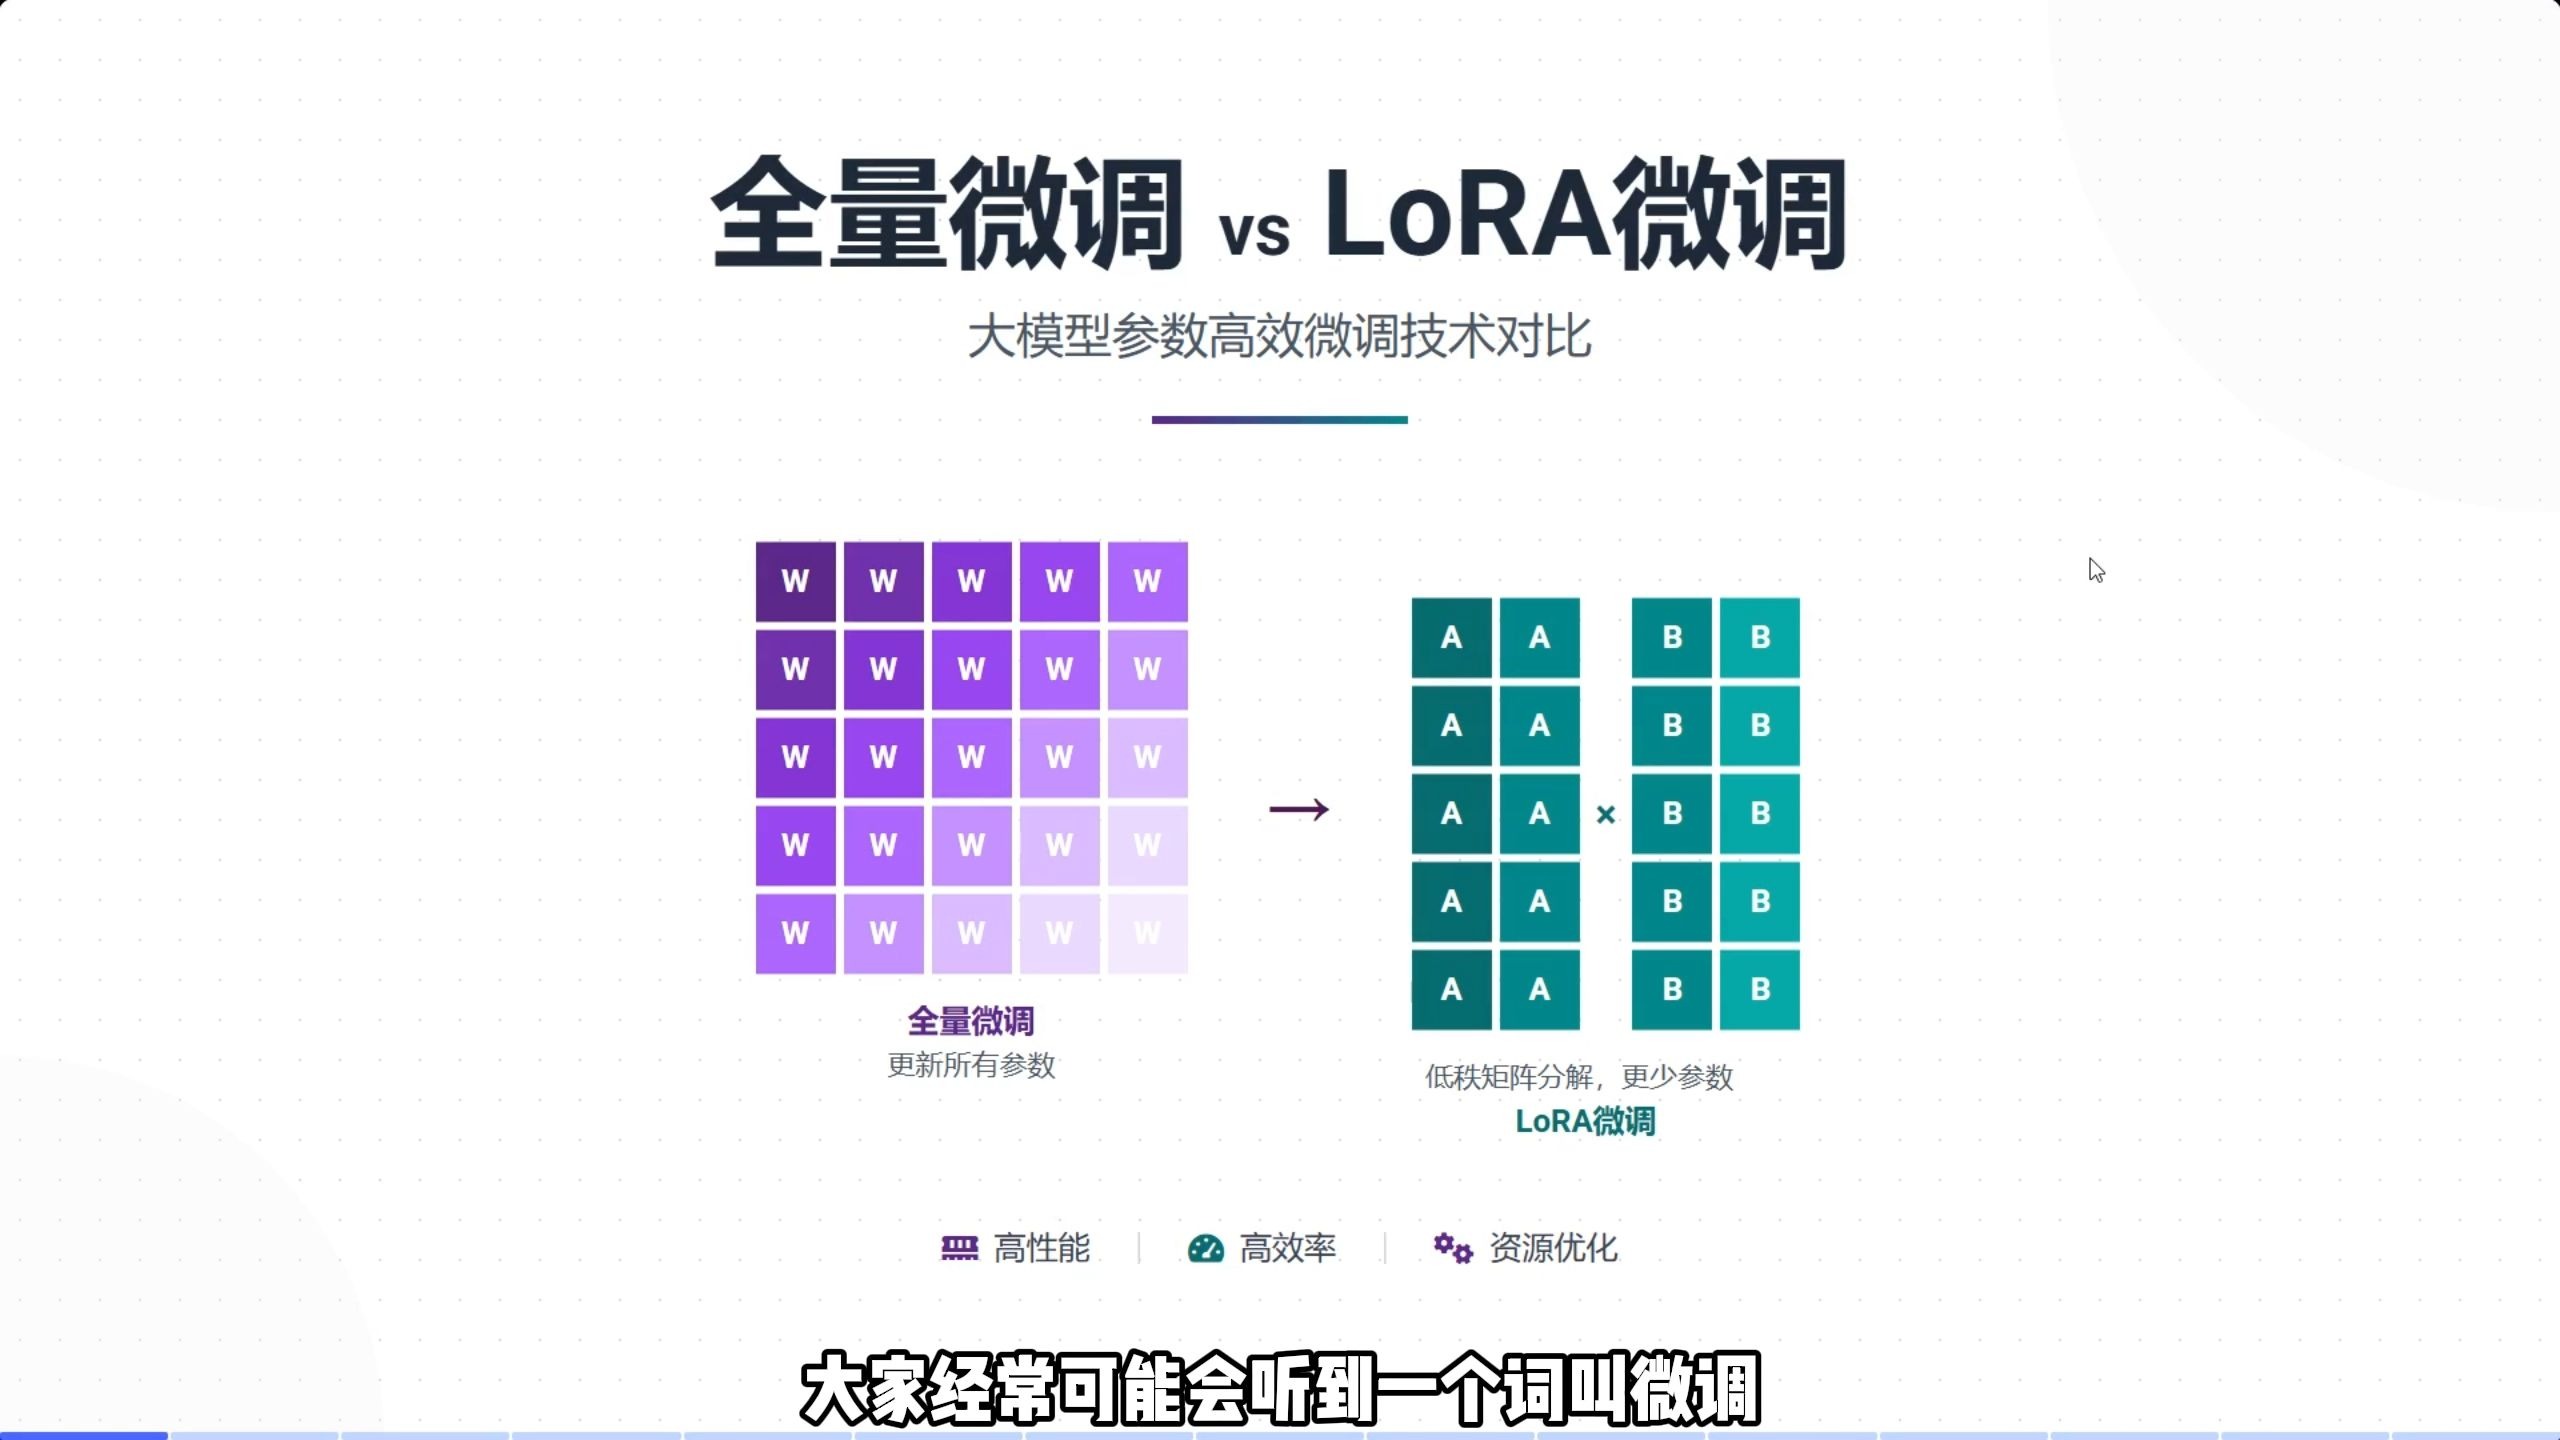
LoRA走的是另一条路:冻结主干权重,只训练低秩适配器矩阵,可训练参数少几个数量级,梯度和优化器状态也跟着大幅缩小,主干权重仍然要加载进显存,但不需要为它保存梯度,QLoRA再把主干量化到4bit,显存门槛还能往下压一截。
| 显存占用项 | LoRA/QLoRA | 全量微调 |
|---|---|---|
| 主干权重 | 需加载,QLoRA可4bit | 需加载,通常fp16/bf16 |
| 梯度 | 只存适配器梯度,量小 | 所有参数梯度,量大 |
| 优化器状态 | 只存适配器状态,量小 | 所有参数状态,量大 |
| 激活值 | 与batch、序列长度相关 | 同样相关,通常更高 |
| 典型硬件 | 单张24GB/48GB可试7B | 多张80GB级或大显存卡 |
| 显存成本 | 较低 | 较高 |
这张表也解释了一个常见现象:同样叫“微调7B”,有人一张4090跑得起来,有人八卡A100还嫌紧,差别不在模型名字,而在训练方式和并行策略。
消费级显卡做LoRA微调需要多少显存
以24GB显存的RTX 4090或3090为例,跑7B模型LoRA是比较现实的起点,建议用QLoRA加载4bit主干,batch size先设1,序列长度从512或1024起步,打开gradient checkpointing,下面是一组可验证的参数路径:
python train.py \
  --model_name_or_path Qwen/Qwen2.5-7B \
  --per_device_train_batch_size 1 \
  --gradient_accumulation_steps 8 \
  --gradient_checkpointing true \
  --fp16 true \
  --use_peft true \
  --lora_r 8 \
  --lora_alpha 16
训练时另开一个终端盯显存:
nvidia-smi -l 1
代码里也可以打印峰值显存:
import torch
print(torch.cuda.max_memory_allocated() / 10243)
实操建议按这个顺序调:
- 先保证能跑通,batch设1,序列长度别一上来就拉满。
- 出现OOM先开gradient checkpointing,再降序列长度。
- 13B/14B模型在24GB卡上要更保守,通常得配合QLoRA和更小batch。
- 32B模型一般建议48GB显存起步,或者直接上多卡。
- rank不是越大越好,任务简单时r=8或r=16够用,盲目加rank会增加适配器状态和激活压力。
如果你在本地微调7B模型,LoRA和全量哪个省显存?答案很直接:LoRA省,因为可训练状态少,主干只做前向,全量微调则要把整个模型的梯度与优化器状态都塞进显存,单卡很难舒服地跑完。
全量微调大模型显存需求怎么算
全量微调的显存大致由五块组成:模型权重、梯度、优化器状态、激活值、临时缓冲,业内专家指出,混合精度Adam下,参数状态本身就要占掉相当大一块,激活值则随batch size和序列长度快速上升,估算时可以按这个顺序拆:
- 权重:参数量乘以精度字节数,fp16大约每参数2字节。
- 梯度:通常与权重同量级。
- 优化器状态:Adam会额外保存动量和方差,是大头。
- 激活值:与层数、batch、序列长度相关,gradient checkpointing可以用计算换显存。
- 临时缓冲:矩阵运算、通信、碎片都会占一部分。
一个7B模型做全量微调,参数状态加激活值后,往往要落到多张80GB级显卡的区间,13B、70B更明显,实操里可以用小batch先试跑,再执行:
import torch
print(torch.cuda.memory_summary())
如果要用单机多卡,DeepSpeed ZeRO-3配合CPU offload能把部分状态挪到内存,但速度会慢下来,行业共识认为,全量微调的显存瓶颈主要在优化器状态和激活值,不在权重加载本身,所以只看“模型能不能加载”没有意义,得看训练状态能不能放下。
本地微调7B模型LoRA和全量哪个省显存
把场景缩到本地单机,结论更清楚:
- LoRA/QLoRA:24GB卡可试7B,48GB卡更从容;适合快速迭代、验证数据格式、跑小规模实验。
- 全量微调:通常需要多卡或大显存单卡;适合数据量大、需要充分改变模型行为的任务。
- QLoRA:4bit加载进一步降显存,但量化会带来精度损失,需要看任务容忍度。
- 成本角度:按云GPU小时计费时,LoRA单卡跑几小时就能出第一版,全量多卡训练时间更长,从北京AI团队微调显存成本的角度看,LoRA起步的预算压力小很多。
这不是说全量微调没必要,数据量足够、效果要求高、需要改全部参数时,全量仍然有它的位置,更常见的做法是先用LoRA做方向和数据的验证,再决定要不要上全量。
显存不够时,怎么把微调跑起来
显存不够不代表任务做不了,关键是按优先级换空间,可以照着下面这个清单调:
- 降batch size和序列长度,这是最直接的两刀。
- 打开gradient checkpointing,用重算换显存。
- 用bf16或fp16混合精度,别默认fp32硬跑。
- 上LoRA或QLoRA,把可训练状态压下来。
- 用DeepSpeed ZeRO-2/ZeRO-3做状态分片,必要时加CPU offload。
- 打开Flash Attention,降低长序列的激活占用。
- 设置环境变量减少显存碎片:
export PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True
操作路径建议:先用nvidia-smi看卡的基础占用,再用小样本跑10步,打印max_memory_allocated,然后逐步加batch或序列长度,纸面公式只能给方向,实测峰值才是准的。
Q&A:LoRA和全量微调显存怎么选?
LoRA微调显存一定比全量低吗?
多数情况下低,但不是绝对,序列特别长、rank特别大、batch开得高时,激活值会上升,全量微调如果用了ZeRO加offload,也能把单卡显存压下来,代价是速度和实现复杂度。
24GB显卡能做全量微调7B吗?
通常不能舒服地做,勉强用offload会非常慢,还容易OOM,更现实的选择是LoRA、QLoRA,或者直接上多卡。
全量微调显存需求怎么估算更准?
先按参数量算权重、梯度、优化器状态,再给激活值留出余量;然后用小batch实际跑一段,看torch.cuda.memory_summary()的峰值,显存需求最终由模型规模、精度、序列长度和并行策略共同决定。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/789093.html