zao服务器制作量过大,先别急着加机器:把任务队列、GPU/CPU瓶颈、限流降级、存储带宽四条线同时拉直,通常比盲目扩容更快止血。 制作量冲上来时,服务器最怕的不是“算得慢”,而是所有请求一起挤进来,把GPU、磁盘和带宽互相拖死,下面按运维实操顺序拆开讲,能落地的命令和操作路径直接给。
zao服务器制作量过大怎么优化:先做瓶颈定位再动手
制作量过大先定位瓶颈,别凭感觉扩容,zao类制作链路通常包含上传、检测、换脸、合成、转码、回调六段,堵点可能不在GPU。
用三条命令看穿是GPU、CPU还是队列堵了
登录制作节点后,先跑一轮基础采集:
uptime看1分钟、5分钟、15分钟负载是否持续爬升。top -H找CPU热点线程,重点看FFmpeg、模型推理进程是否吃满。nvidia-smi dmon -s u -d 1看GPU利用率和显存占用,连续观察几分钟。iostat -x 1看磁盘await和%util,素材盘和结果盘分开看。docker stats --no-stream看容器级CPU、内存、网络。redis-cli llen queue:render或rabbitmqctl list_queues name messages consumers看队列积压和消费者数量。
判断口径可以简单点:GPU利用率连续10分钟高于85%且队列等待P95超过2分钟,更像算力不足;GPU不高但队列猛涨,更像消费者卡住或下游存储慢;CPU打满、磁盘await高,先查转码和素材读写。队列深度、任务等待时长、P95制作耗时比单看CPU更有意义。
先把“制作量”拆成可观测指标
在Prometheus/Grafana里至少加这些指标:queue_depth、task_wait_seconds、gpu_util、gpu_mem_used、render_p95_seconds、http_5xx_rate、egress_mbps,没有监控就先在应用日志里打点,按用户、任务类型、分辨率、时长分桶,制作量过大时,先看是短视频模板集中爆发,还是长视频转码拖尾,不同任务对GPU和CPU压力完全不同。
zao服务器制作量过大需要扩容还是限流:成本与地域节点对比
这是最容易拍脑袋的决策,扩容解决持续增长,限流解决突发峰值;两者不是二选一,常见做法是“限流止血+扩容补量”。
限流降级适合突发高峰
在Nginx入口做粗粒度限流,配置文件通常在/etc/nginx/conf.d/zao.conf:
- 定义
limit_req_zone $binary_remote_addr zone=zao:10m rate=5r/s; - 在制作接口加
limit_req zone=zao burst=10 nodelay; - 超限返回
429或503,并带重试提示。
应用层再做用户级、设备级令牌桶,把免费用户和付费用户分队列,降级策略要提前写死:低优先级任务降分辨率、降帧率、关闭实时预览图、结果改为异步通知。限流的目标不是拒绝用户,而是让队列等待可控。
扩容适合持续增长
如果连续多天队列在高峰后仍不回落,说明制作量是趋势性增长,扩容优先加GPU池和转码worker,不要只加Web层,Kubernetes环境可看kubectl get hpa,按队列深度或自定义指标扩副本;虚拟机环境先把制作节点做成镜像,按“GPU机型+对象存储挂载”批量拉起,不同地域机房在GPU供给、带宽成本和回源延迟上差异明显,华东、华南节点适合靠近用户做上传接入,中西部节点可承接离线转码,具体选哪个地域要看任务类型和预算。
| 方案 | 适用场景 | 主要动作 | 风险 | 成本量级 |
|---|---|---|---|---|
| 限流排队 | 突发高峰、短时超卖 | Nginx限流、应用令牌桶、优先级队列 | 用户体验下降 | 低 |
| 横向扩容 | 持续增长、GPU长期吃满 | 加GPU worker、转码节点 | 闲置浪费 | 中到高 |
| 架构优化 | 重复制作多、链路长 | 缓存、预生成、分队列 | 改造成本 | 中 |
| 混合策略 | 多数生产环境 | 先限流再按监控扩容 | 需调参 | 可控 |
短视频团队zao服务器制作量过大怎么处理:把制作链路拆开
短视频团队常见场景是模板集中上线,几十个达人同时套模板,制作请求瞬间翻倍,此时最有效的是拆链路,不让一个队列扛所有任务。
上传、检测、换脸、合成、转码分队列
把queue:upload、queue:detect、queue:render、queue:transcode、queue:callback分开,每个队列独立消费者和并发上限,上传走对象存储直传,别让制作服务器中转大文件;换脸和合成用GPU worker;转码用CPU worker;回调失败进重试队列,这样GPU堵了不会把上传也堵死。
缓存与预生成减少重复制作
同一模板、同一素材、同一参数的结果可以做短期缓存,命中后直接返回结果URL,热门模板提前预生成低清预览,用户确认后再出高清。缓存命中率每提高一档,GPU压力就少一截,素材和模型文件放本地NVMe或高性能云盘,结果文件及时转对象存储,别让系统盘被写满。
本地部署zao服务器制作量过大怎么办:容量规划与监控告警
本地部署没有云上弹性,制作量过大时更容易被机房带宽和GPU数量卡住,先把容量账算清,再谈买卡。
用P95和队列深度算GPU池
可用一个粗算公式:所需GPU数 ≈ 峰值并发任务数 × 单任务平均GPU占用时长 ÷ 目标排队等待窗口 ÷ GPU利用率安全系数,单任务平均GPU占用时长从监控里取P95,不要取平均值,目标排队等待窗口按业务定,比如高峰允许等几分钟,安全系数留出模型加载、显存碎片和突发重试空间,行业共识认为,制作类业务的容量规划要按P95而不是均值做,否则高峰必堵。
监控告警至少设置:队列深度连续增长、P95等待超阈值、GPU显存接近上限、5xx比例抬升、对象存储写入延迟升高,告警落到值班群,附上队列长度和最近扩容记录,业内专家指出,制作链路的扩容决策应绑定队列等待指标,而不是只看单机负载。
zao类视频生成服务器租用价格怎么看:不只看GPU单价
租用价格容易被“GPU每小时单价”带偏,zao类制作的真实成本还包括对象存储、公网带宽、转码CPU、快照和日志。
计费项拆解
- GPU按小时或包月计费,按需适合峰值,预留适合稳定底量。
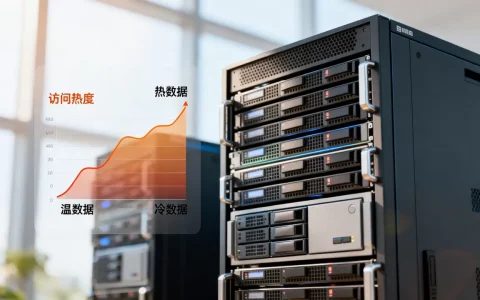
- 对象存储按GB月计费,结果文件多时冷热分层。
- 带宽按Mbps或流量计费,上传和回源是常被忽略的大头。
- 转码CPU和内存按实例规格计费,长视频转码吃CPU。
- 不同地域节点价格差异较大,靠近用户的地域带宽贵,离线转码地域可能更划算。
据工信部公开的云计算相关统计,弹性资源和按需计费已是常态,但制作类业务更应关注“单位有效制作成本”,也就是一次成功制作摊到的GPU、存储、带宽和重试成本,价格对比时把重试和失败任务算进去,账才接近真实。
zao服务器制作量过大怎么办:常见问题解答
zao服务器制作量过大怎么判断是GPU还是队列问题?
先看nvidia-smi dmon和队列等待P95,GPU利用率高且队列持续涨,偏算力不足;GPU不高但队列涨,查消费者卡死、下游存储慢或锁竞争,再看iostat -x 1排除磁盘瓶颈。
zao服务器制作量过大需要扩容还是限流?
短时突发先限流排队和降级,连续多天高峰不回落再扩容,扩容优先加GPU worker和转码节点,同时保留入口限流,避免扩容期间被打穿。
本地部署zao服务器制作量过大怎么办?
先拆队列、加缓存、做优先级限流,再按P95耗时和队列深度扩GPU池;本地机房要同步检查带宽和存储写入上限,本地部署场景下,先做队列和限流,再按GPU池扩展,是更稳妥的顺序。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/789519.html