EC服务器闪退,多数情况下不是机器坏了,而是内存分配、Mod/插件版本或世界存档这三处出了问题,先翻 crash-reports 和 logs/latest.log,再核对启动参数,最后做一次干净启动,通常当天就能定位到病根。
闪退先看日志,别急着重装系统
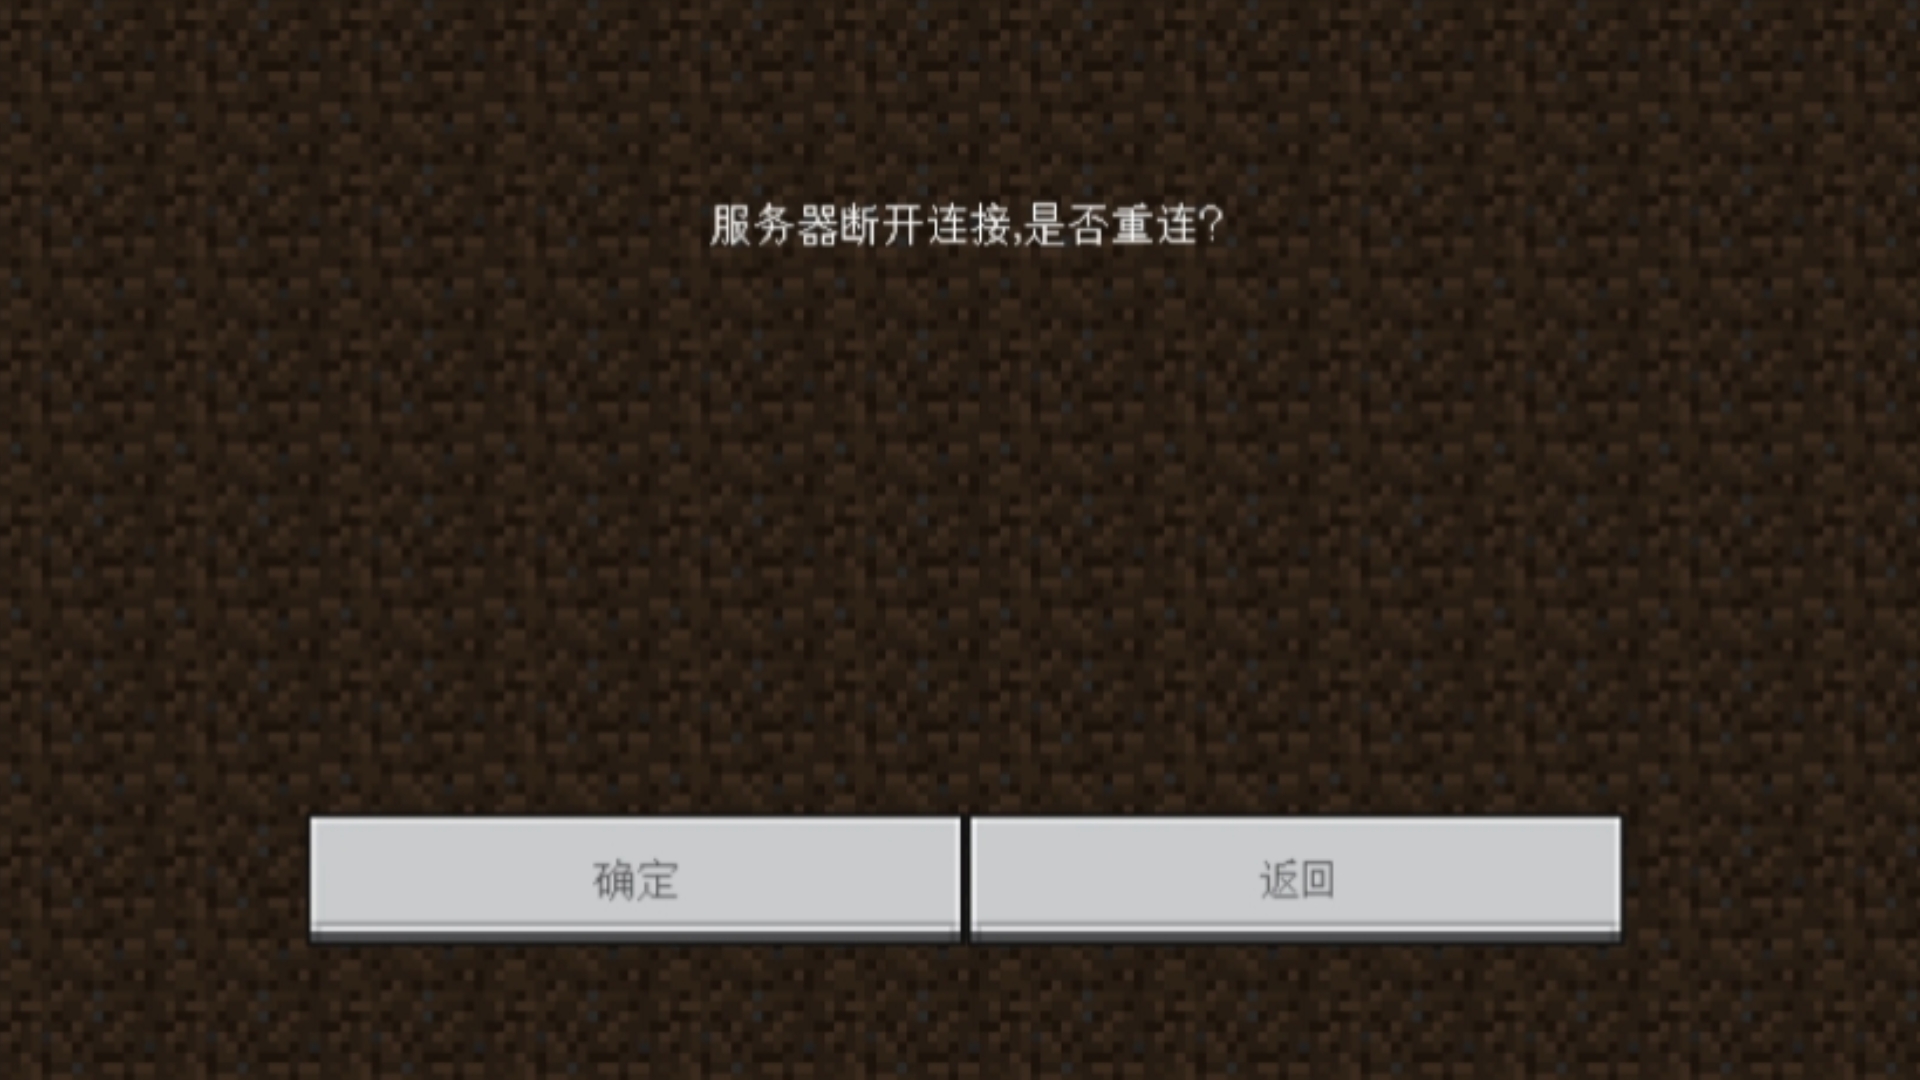
服务器“啪”一下没了,控制台刷一行红字就断开,很多人第一反应是重装,重装能解决的只是环境损坏那一小部分问题,剩下的大头,日志里写得清清楚楚。
我的世界EC服务器闪退怎么解决:从日志开始查
进服务端根目录,找两个地方:
logs/latest.log:这次启动到崩溃的完整输出,最后几十行最关键crash-reports/:Java 层面抛出异常时才会生成,文件名带时间戳
按关键词对号入座,比盲目改配置快得多:
| 日志特征 | 大概率原因 | 处理方向 |
|---|---|---|
java.lang.OutOfMemoryError: Java heap space |
堆内存不够 | 调 -Xmx,减 Mod、减视距 |
The server has not responded for 60 seconds / Watchdog |
主线程卡死 | 查实体堆积、区块加载、插件死循环 |
NoSuchMethodError / NoClassDefFoundError |
Mod 或插件版本不匹配 | 对齐版本、删冲突项 |
UnsupportedClassVersionError |
Java 版本太低 | 换 Java 17 或 21 |
Exception ticking world / Ticking entity |
某个实体或方块实体出错 | 定位坐标清掉它 |
Address already in use |
端口被占 | 换端口或杀掉残留进程 |
| 没有任何 crash-report,进程凭空消失 | 被系统 OOM Killer 杀掉 | 查面板内存上限与物理内存 |
最后一行那种“无声消失”的情况,在面板服上特别常见,下面单独说。
EC服务器闪退和内存不足有关系吗?关系很大,但坑不在数字大小
面板的“内存上限”和 -Xmx 是两码事
这是面板服最容易踩的坑,面板里填的“内存限制 2G”,是操作系统给这个进程画的红线;而 server.properties 同级的启动脚本里写的 -Xmx4G,是 Java 自己以为能用的堆上限,Java 觉得有 4G 可用,系统只给 2G,超出的那一刻内核直接把进程干掉,日志里一行报错都没有,面板上只显示“已停止”。
行业共识认为,面板内存限制应当比 -Xmx 高出 1G 左右,留给 JVM 元空间、线程栈、直接内存这些堆外开销,填 4G 上限,-Xmx 就给 3G 到 3.5G。
给多少内存算合适
内存不是越多越好,超过物理内存反而会触发换页和 OOM,参考这个区间:
- 原版或轻量插件服,10 人以内:2G 到 4G
- Paper 插件服,20 人左右:4G 到 6G
- 百余个 Mod 的整合包,5 到 10 人:6G 到 8G
- 两三百个 Mod 的大型包:8G 到 12G 起步
启动参数别只写 -Xms 和 -Xmx,加一组 G1 回收参数,长时间运行的抖动会小很多:
java -Xms4G -Xmx4G -XX:+UseG1GC -XX:+ParallelRefProcEnabled \
-XX:MaxGCPauseMillis=200 -XX:+DisableExplicitGC \
-jar server.jar nogui
-Xms 和 -Xmx 设成一样,避免堆反复伸缩。
Mod 和插件对不上,是整合包服闪退的高发区
做一次“干净启动”,十分钟锁定嫌疑人
- 把
mods或plugins整个文件夹移出去,只留服务端核心,启动 - 能稳定跑,说明问题在这些扩展里
- 一半一半往回放,哪批放进去就崩,问题就在那批
- 继续二分,通常三四轮就能揪出具体文件
客户端能进、服务端一闪就退,八成是客户端装了服务端没有的 Mod,或者两边版本号差了一个小版本,Forge、Fabric、NeoForge 三者互不通用,核心和 Mod 必须同门同版本。
Java 版本也要对上:1.17 之后基本要求 Java 17,1.20.5 之后要求 Java 21,用 java -version 确认,别让面板默认的老版本 Java 背锅。
存档越玩越卡、越玩越容易闪退,问题在世界数据里
开服第一周好好的,第三周开始一天崩三次,这类情况多半跟世界本身有关。
实体堆积与区块损坏
- 大量掉落物、经验球、掉落的箭堆在同一区块,主线程 tick 直接拉满
- 红石机器高频循环、刷怪塔没做上限,实体数量滚雪球
- 异常断电或强杀进程,
region文件写坏,加载到那块就抛异常 - 用 ClearLag 这类插件定时清掉落物,给实体加数量上限
- 定期把
world文件夹打包备份,出问题时能回滚到上一个正常点
区块损坏可以用 Region Fixer 之类的工具扫描修复,修不好就删掉那一块让服务器重新生成,总比整个存档报废强。
我的世界EC服务器长期稳定运行设置清单
想让服务器少崩,日常这几项值得调:
server.properties里view-distance调到 6 到 8,simulation-distance调到 4 到 6,视距是性能杀手- Paper 端改
paper-world-defaults.yml,收紧entity-activation-range和mob-spawn-range - 面板开启定时重启,比如每 12 小时一次,能缓解内存缓慢泄漏
- 物理内存吃紧时加 2G 到 4G Swap 兜底,但别指望它替代加内存
- 装 spark 或 timings 做性能采样,看清是哪个插件在吃 tick
升级配置还是换服务商,先算清楚账
EC服务器升级配置多少钱,值不值得升
面板服的配置一般按档位走,加内存、加 CPU 核心各是一档价,低配档位月付多在几十元区间,中高配到一两百甚至更高,具体看服务商档位表,判断标准很简单:日志里反复出现 OutOfMemoryError,减了 Mod 和视距还是崩,那就是真缺内存,升档划算;日志里是 Watchdog 超时,升内存基本没用,真正缺的是单核性能和优化。
国内EC服务器哪家稳定,看三个硬指标
一是 CPU 单核性能,Minecraft 主线程吃单核,核心多但单核弱等于白搭;二是内存是否独享,超售严重的机器晚高峰 TPS 掉得厉害;三是磁盘是不是 NVMe,区块加载速度差一截,另外确认服务商允许自定义 JVM 参数、提供自动备份,这两条直接决定你排查问题时有没有退路。
我的世界EC服务器闪退常见问题
我的世界EC服务器闪退怎么解决,最快的一步是什么
打开 logs/latest.log 拉到最底部,看最后一条异常,有 OutOfMemoryError 就调内存,有 NoSuchMethodError 就对齐版本,有 Watchdog 就查实体和插件,九成闪退,日志第一眼就能给出方向。
EC服务器闪退和内存不足有关系吗,加到多少才够
有关系,而且面板内存上限与 -Xmx 不匹配引发的“无声闪退”占比不低,给多少取决于玩法:原版十几人 2G 到 4G,插件服 4G 到 6G,大型整合包 8G 以上,并且面板上限要比 -Xmx 高约 1G。
重装系统能彻底解决EC服务器闪退吗
只能解决环境损坏、Java 装错、核心文件缺失这几类问题,据公开的服务器运维实践,Mod 冲突、存档损坏、内存不足导致的闪退,重装后原样复现,因为配置文件和你拷回去的存档一起回来了,先定位,再决定要不要重装。
说到底,EC服务器闪退是能被日志翻译出来的故障,不是玄学,把“看日志、对参数、查存档”这三步走顺,绝大多数崩溃都能在半小时内锁定原因。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/789912.html