按小时租用GPU算力时,单价由硬件型号、租用时长、计费模式和平台运营成本共同决定,其中GPU型号和是否使用竞价实例是影响价格的两大核心变量。
GPU算力租赁市场的定价逻辑是什么
GPU云服务器的定价机制与传统的包年包月模式有本质区别,小时计费模式的单价并非简单的“月价除以720小时”,而是云厂商基于GPU损耗、电力成本、运维投入和市场竞争态势动态调整的结果。
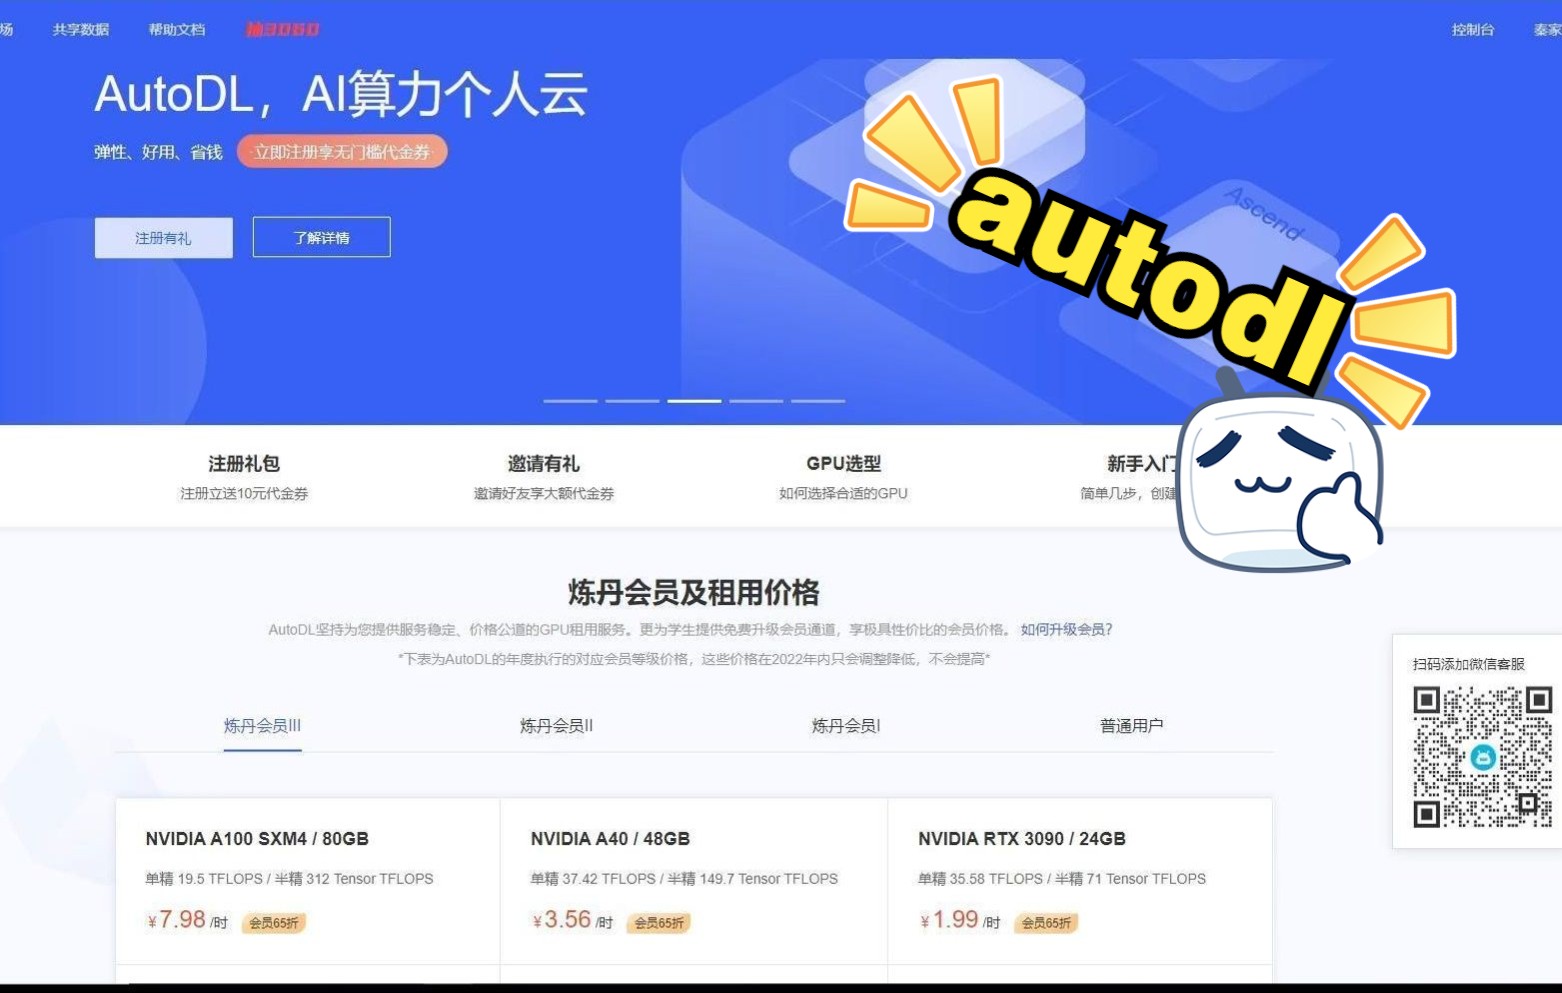
硬件型号决定价格上限
不同代际的GPU芯片,其算力性能和采购成本差距悬殊,以行业常见的几款GPU为例:
| GPU型号 | 显存容量 | 典型应用场景 | 参考小时单价区间 |
|---|---|---|---|
| NVIDIA T4 | 16GB | 轻量推理、视频转码 | 较低 |
| NVIDIA A10 | 24GB | 中型训练、AI绘画 | 中等 |
| NVIDIA A100 | 40GB/80GB | 大模型训练、科学计算 | 较高 |
| NVIDIA H100 | 80GB | 顶尖大模型预训练 | 很高 |
业内专家指出,A100和H100这类高端算力芯片的采购成本、散热要求和电力消耗都远超消费级显卡,这部分硬件成本会直接传导到小时单价上,多数云平台会依据GPU的代际划分价格梯度,同品牌下H100的按小时租用GPU算力单价可能是T4的5至8倍。
配置组合影响实际支付金额
按小时租用GPU算力时,用户看到的单价通常是“计算实例”的整体价格,而非单纯一张显卡的价格,实例配置包含:
- CPU核心数与主频:搭配的CPU越强,单价越高
- 内存容量:DDR4与DDR5内存的成本差异明显
- 本地存储:SSD类型和容量会折算进实例价格
- 网络带宽:按流量计费或按固定带宽计费,影响最终账单
- 附加服务:快照、镜像、安全组件等增值服务费用
这就解释了为什么在GPU租用价格对比中,同样标注“A100显卡”,不同平台的每小时费用可能相差不少,有的平台给出的是裸金属物理机价格,有的则是虚拟化实例价格,两者包含的资源边界完全不同。
计费模式改变价格结构
云厂商通常提供多种计费方式,按小时租用只是其中一种:
- 按量付费:即按小时计费,随开随停,灵活性最高,但单价通常最贵
- 包周/包月:以小时价为基础打一定折扣,适合长期稳定使用的任务
- 竞价实例:平台利用空闲算力,以远低于按量付费的价格出租,但实例可能被随时回收
- 预留实例:提前锁定资源,价格介于按量付费和竞价实例之间
从使用成本角度看,深度学习训练一小时多少钱,很大程度上取决于用户是否愿意接受竞价实例的不确定性,对于可中断的批处理任务,竞价实例能节省一半以上的费用;对于需要持续训练数天的大模型任务,包周或包月则更划算。
影响GPU算力单价浮动的主要因素
按小时租用GPU算力单价并非一成不变,而是受到供需关系、地域分布和平台策略的多重影响。
供需关系引发价格波动
近年来,大模型创业潮和AI应用落地导致GPU算力需求爆发式增长,当热门型号供不应求时,部分云平台的按量付费价格会上调;当算力闲置率上升时,平台会通过降价或推出促销活动来吸引用户。
用户在实际使用中可以观察到,在工作日的白天时段,GPU实例的库存相对紧张,价格坚挺;而在深夜或周末,部分平台会下调竞价实例的价格以提升资源利用率。
地域差异带来价差
GPU租用价格对比不能只看型号,还得看地域,国内主流云平台在不同城市部署了算力中心,价格存在一定差异:
- 一线城市(北京、上海、广州):网络延迟低,但电力成本和机房租金高,单价相对较高
- 中西部地区(贵州、内蒙古、甘肃):气候凉爽利于散热,电力资源丰富,单价较低
- 海外地域(新加坡、美西、法兰克福):以美元计价,汇率波动会影响实际支付成本
对于对延迟不敏感的训练任务,选择在价格洼地的地域创建实例是降低成本的常用手段。
平台定价策略与活动
各云厂商会不定期推出新用户优惠、充值返赠、特定机型限时折扣等活动,这些活动会直接影响用户实际支付的按小时租用GPU算力单价,企业认证用户通常能享受协议价,用量越大,折扣力度越高。
大平台与中小型算力租赁商之间的价格差异也比较明显,大型云厂商基础设施完善但定价体系相对刚性,中小型服务商或算力聚合平台为了吸引客户,往往给出更低的价格,但需要注意其服务的稳定性和数据安全能力是否可靠。
如何计算一次训练任务的实际GPU成本
了解了单价构成后,用户更关心的是深度学习训练一小时多少钱的实际花费,从实际操作层面来看,计算总成本需要拆分多个维度。
从计费时长规则入手
按小时租用GPU算力时,多数平台以“秒”为单位计费,但账单按小时展示,这里有几个计费规则会影响实际支出:
- 实例创建后即开始计费,无论是否提交了训练任务
- 停机但未释放实例,仍会收取存储费用,部分平台甚至继续计算实例费用
- 使用镜像和快照会产生额外的存储费用,虽然单价很低,但积少成多
- 公网流量通常单独计费,下载数据集和上传模型权重都会消耗流量
一个典型的成本拆解示例
假设用户需要训练一个中小规模的深度学习模型,选用单张A100 80GB显卡的实例:
- 实例单价:假设为每小时数十元(不同平台差异较大,以实际询价为准)
- 训练时长:约8小时完成一轮完整训练
- 数据上传与下载:消耗约100GB公网流量
- 快照存储:保留3天,占用200GB存储空间
实际支付费用 = 实例费用(8小时 × 每小时单价) + 流量费用 + 存储费用,从这个例子可以看出,GPU计算的费用占大头,但周边资源的使用也会产生一笔不容忽视的开销。
查看账单与成本优化建议
在云平台控制台的“费用中心”或“账单明细”中,用户可以按实例ID查看每小时的扣费记录,建议在创建实例前做好以下操作:
- 估算训练所需的GPU数量和数据量,选择合适的实例规格
- 开启“竞价实例”或“Spot实例”选项,前提是训练任务支持断点续训
- 将训练数据提前上传到对象存储,并使用内网传输至计算节点,节省公网流量费
- 训练完成后立即释放实例并删除无用快照,避免闲置扣费
按小时租GPU算力平台的选择参考维度
面对市场上众多GPU租赁平台,用户进行GPU租用价格对比时,应从综合成本而非单纯小时单价出发。
价格之外的隐性指标
- 实例开机速度:高峰期能否快速创建实例,直接影响排队等待的时间成本
- 内网传输速度:数据集加载速度决定了GPU的利用率,慢速存储会让昂贵的计算资源处于等待状态
- 技术支持响应:遇到驱动或环境问题时的解决速度,对于按小时计费的用户来说,每一次故障都在产生费用
- 退费机制:实例因平台故障中断时,是否自动退还故障时段的费用
不同使用场景的选型建议
对于个人开发者或学生群体,预算有限且任务较零散,可以优先考虑:
- 支持竞价实例的平台
- 提供“按需付费”且无最低消费门槛的服务
- 有免费额度或新用户试用资源的平台
对于企业用户,训练任务规模大且对数据安全要求高,建议选择:
- 自研底层基础设施的大型云厂商
- 支持专有网络和资源隔离的方案
- 可签订合同并获得专属折扣的商务模式
据统计,选择按小时租用GPU算力的用户中,相当一部分人最终会因为稳定性和数据安全因素,从低价小型平台迁移到主流云服务商,这说明单价不是唯一的决策依据,服务的可持续性同样重要。
常见问题解答
按小时租用GPU算力单价为什么比包月折算价贵
按小时计费本质上是“即开即用”的灵活性溢价,用户无需承诺长期使用,平台则承担了资源闲置的风险,因此单价自然高于包月折算价,如果训练任务预计持续超过一周,通常建议改为包月或包周计费,能明显降低单位时间成本。
在GPU租用价格对比中,如何判断一个平台的定价是否合理
合理的参考方式是先确定所需GPU型号,然后对比至少三家平台的同配置实例价格,同时查看该平台是否额外收取镜像、存储或带宽费用,将计算实例费用加上预估的周边资源费用,得出总成本后再做判断,价格显著低于市场平均水平的平台,需要仔细考察其服务协议和用户评价。
深度学习训练一小时多少钱的预算如何控制
建议从四个方面压缩成本:一是选择竞价实例处理可中断任务,二是尽量使用内网传输数据减少流量费,三是训练完成后立即释放资源并清理存储,四是在非高峰时段运行任务以获取更低价格,将这几个动作落实到位,实际支出往往能比默认配置节省三成左右。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/790024.html