GPU算力租用的费用通常由计算资源、存储、网络、软件平台、服务运维和隐性成本六部分构成,只盯每小时GPU单价,很容易漏算后面几项。 下面按账单里真实出现的条目拆开讲,顺带把选租期、核账单的操作路径说清楚。
GPU算力租用费用由哪几部分构成
业内专家指出,GPU租用报价通常只覆盖计算实例本身,存储、网络和平台服务往往另计,你打开账单时,先别只看“GPU单价”那一列,按下面六项逐条对,基本能把费用还原出来。
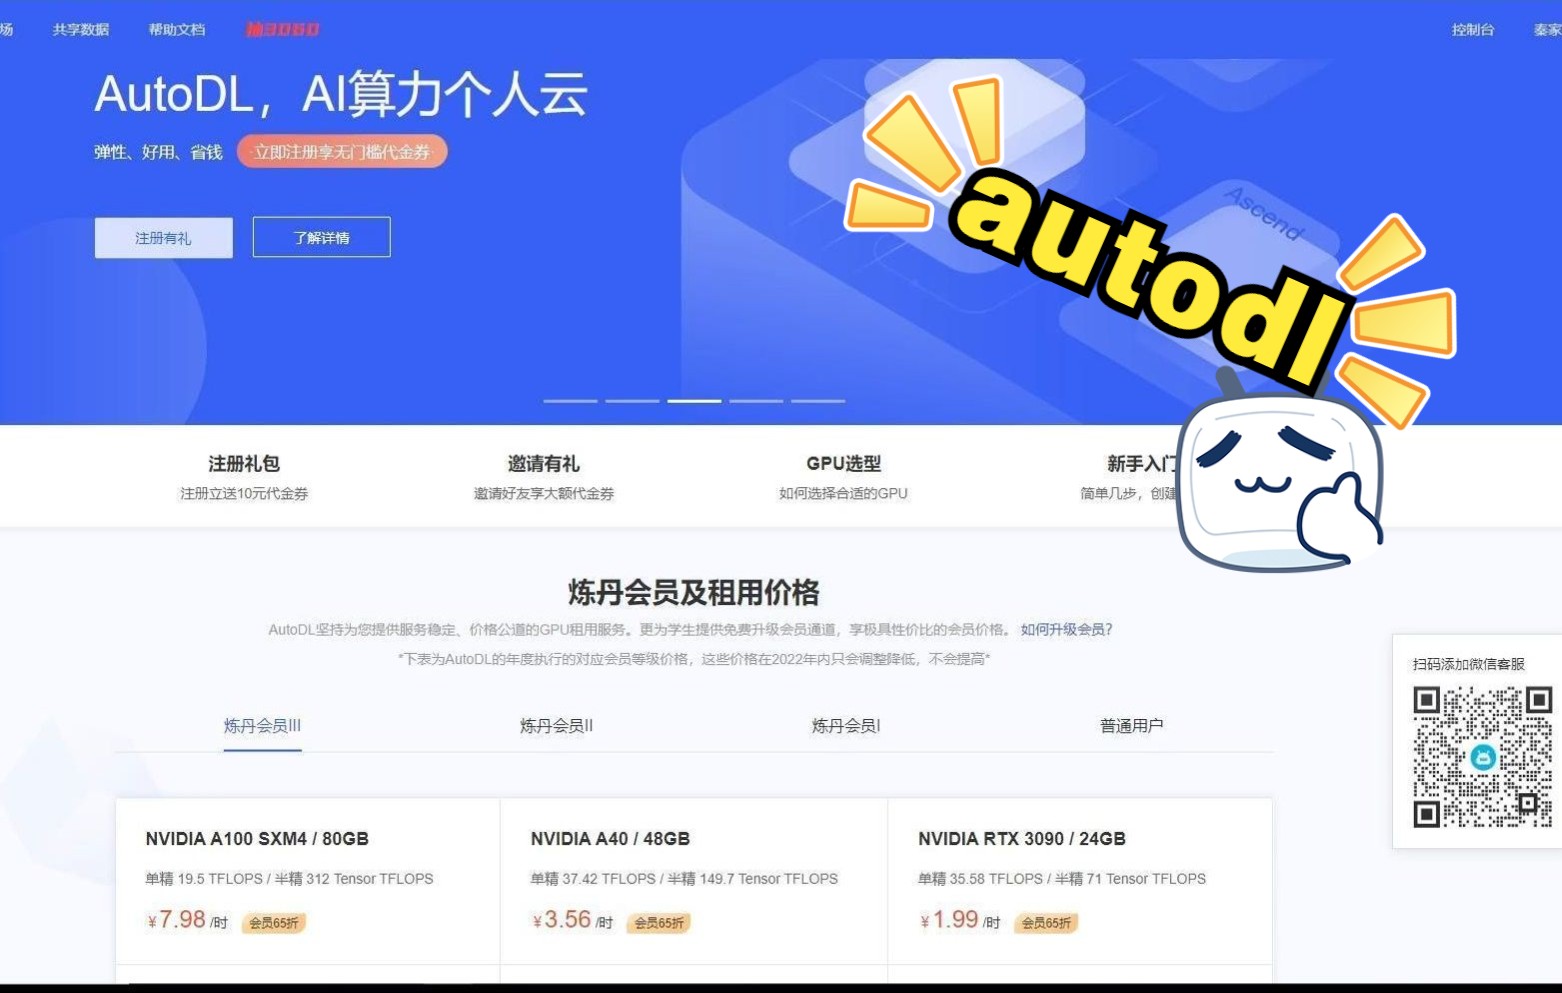
计算资源费:GPU卡型和实例规格决定大头
计算资源费是通常占大头的部分,它不只按“一张卡多少钱”算,还受这些因素影响:
- GPU型号与显存:训练看显存和卡间互联,推理看显存和并发承载。
- 卡数:单机多卡、多机多卡会带来互联和调度成本。
- 实例规格:CPU核数、内存容量、本地NVMe盘是否搭配合理。
- 独占还是共享:独占实例价格高,共享/抢占实例价格低但稳定性不同。
- 计费方式:按量、包月、包年、竞价、预留,单价和灵活性不一样。
实操上,先登录实例跑三条命令确认规格有没有买偏:
nvidia-smi
lscpu
free -h
nvidia-smi看卡型和显存,lscpu看CPU,free -h看内存,如果CPU或内存长期吃满、GPU利用率却上不去,说明规格配比不合适,钱花在了短板上。
存储费:系统盘、数据盘、快照和镜像都算钱
存储费经常被忽略,因为它不跟GPU单价放在一起展示,常见计费项包括:
- 系统盘:随实例创建,部分平台关机后仍按容量计费。
- 数据盘:按容量计费,挂载不挂载都可能产生费用。
- 对象存储:按存储量、请求次数和流出流量计费。
- 快照:按增量容量计费,保留越多越容易累积。
- 自定义镜像:占用存储空间,长期保留会持续产生费用。
实操路径:在云控制台进入“云硬盘”核对未挂载盘,进入“快照”清理旧快照,进入“镜像”删除不再使用的自定义镜像,实例内用df -h看挂载和使用率,用du -sh /data/定位大目录,冷数据尽量放对象存储,热数据放数据盘,别把所有数据都塞在系统盘里。
网络费:公网带宽和跨地域流量最容易被忽略
网络费主要有几类:
- 公网带宽:固定带宽或按流量计费,推理服务对外提供接口时尤其明显。
- 跨地域流量:数据从A地域传到B地域的GPU实例,可能产生流量费。
- NAT网关、负载均衡、弹性公网IP:按实例或按流量另计。
- 内网流量:同地域内网通常更便宜,甚至免费,但跨地域不适用。
实操建议:把训练数据、对象存储和GPU实例放在同一地域;优先走内网endpoint拉取数据;数据集先压缩再上传;推理服务按实际并发选带宽,不要一上来就开大带宽,控制台路径一般是“费用中心→账单明细→按产品筛选→公网流量/带宽”。
软件与平台费:镜像、调度、商业授权不一定含在单价里
基础镜像通常不额外收费,但下面几类可能单独计价:
- 商业深度学习镜像或预装环境。
- 容器平台、调度平台、AI开发平台的服务费。
- 商业软件License,比如某些数据库、推理加速工具。
- 托管运维、监控告警、日志服务。
下单前看价格页的“包含/不包含”说明,别把平台服务费当成GPU单价,自建调度和官方基础镜像通常更可控,但需要自己维护环境。
服务与运维费:托管、技术支持和安全合规
这部分不是每个用户都会买,但企业场景常见:
- 7×24技术支持、专属运维、迁移协助。
- 安全加固、审计日志、等保合规相关服务。
- 备份、容灾、高可用架构带来的额外实例和存储。
个人和小团队可以先用基础支持,把预算留给计算和存储;企业长期跑生产服务,再按需买运维支持。
隐性成本:闲置、中断、迁移和调试
隐性成本不直接出现在单价里,却会实实在在推高总花费:
- GPU利用率低:卡开着,任务在等数据、等调试、等排队。
- 竞价实例中断:任务重跑,时间成本翻倍。
- 数据迁移和冷启动:大模型加载慢,环境反复装。
- 忘记释放资源:测试实例挂几天,账单持续走。
用这条命令持续看利用率:
nvidia-smi --query-gpu=utilization.gpu,memory.used --format=csv -l 1
如果利用率长期偏低,先查数据管道和CPU瓶颈,再考虑降配或换调度方式,竞价实例一定要把checkpoint定期写到对象存储,中断后可恢复。
GPU云服务器租用价格对比:按量、包月、包年怎么选
行业共识认为,长期稳定负载用包年包月更经济,但前提是利用率能撑起来,下面这张表不写具体价格,只对比费用逻辑,方便你按场景选。
| 计费方式 | 适合场景 | 费用特点 | 容易踩的坑 |
|---|---|---|---|
| 按量计费 | 调试、短任务、突发推理 | 灵活,单价相对高 | 忘记关机或释放,持续计费 |
| 包月 | 稳定训练、持续推理 | 单价通常低于按量 | 任务提前结束,资源闲置 |
| 包年 | 长期固定负载 | 折扣空间更大 | 锁定周期长,变更不灵活 |
| 竞价实例 | 容错训练、批处理 | 价格随供需波动 | 中断重跑,checkpoint没存 |
| 预留实例 | 可预测的长期用量 | 承诺用量换价格优惠 | 承诺量估高,浪费额度 |
如果你在纠结“GPU算力租用按量计费和包年包月哪个划算”,先算总拥有成本:计算费+存储费+网络费+闲置浪费+迁移调试时间,短任务按量更稳,长任务包月包年更省,但闲置率高时包月反而贵。
大模型训练GPU算力租用多少钱一小时受什么影响
同一张卡在不同平台、不同地域、不同租期的报价可能差出一截,主要看:
- 卡型和卡数:高端训练卡、显存大小、卡间互联方式。
- 租期长短:按量、包月、包年的单价梯度。
- 地域供需:一线城市机房资源紧,价格和可用性会波动。
- 是否含存储和网络:有的报价只含实例,盘和带宽另算。
- 平台服务:镜像、调度、技术支持是否打包。
询价时统一口径:同卡型、同卡数、同地域、同租期、同存储和带宽,再比总价,只看“每小时多少钱”容易比偏。
北京GPU算力租用价格为什么和别的城市不一样
北京GPU算力租用价格通常受机房等级、网络资源、供需关系、电价和合规要求影响,一线城市网络条件好、客户集中,资源紧的时候价格更坚挺;中西部机房可能便宜些,但你要考虑数据在哪、用户在哪、延迟能不能接受,选地域时先问三个问题:训练数据存放在哪,推理用户集中在哪,业务有没有地域合规要求,数据与GPU同地域,能省掉一笔跨地域流量费。
租用GPU算力怎么核对账单:实操步骤
下单前用价格计算器拆项
- 选地域、卡型、卡数、租期。
- 加系统盘、数据盘容量。
- 选公网带宽或流量计费方式。
- 勾选快照、镜像、负载均衡等附加项。
- 看总价里是否含公网IP、NAT、对象存储请求费。
把计算器结果截图保存,后面账单对不上时能快速定位。
运行中看监控和账单
- 控制台路径:费用中心→账单明细→按产品/按实例筛选。
- 给实例打标签,按项目或团队分账。
- 设置预算告警,超过阈值先收到通知。
- 用
nvidia-smi和云监控看GPU利用率,低利用率就查数据管道或缩容。
结束时清理资源
释放实例只是第一步,还要检查:
- 云硬盘:卸载后删除,避免空转计费。
- 快照:保留策略按需设置,旧快照及时清。
- 自定义镜像:不用的删掉。
- 弹性公网IP、NAT网关、负载均衡:按需释放。
- 对象存储:冷数据转低频存储或清理。
别把“关机”当成“停止计费”,不同平台规则不一样,以账单明细为准。
把GPU单价放回总成本里看,先算计算、存储、网络、软件、服务和隐性成本,再决定按量还是包年,账单才不容易失控。
GPU算力租用费用常见问题Q&A
GPU算力租用费用为什么不同平台报价差很多?
卡型新旧、是否独占、存储和网络是否包含、租期长短、运维服务、地域供需都会影响报价,比较时统一口径:同卡型、同地域、同租期、同存储带宽,再看总价,不要只比每小时单价。
包年包月一定比按量计费便宜吗?
多数情况下长期稳定负载包月包年更划算,但短任务、调试、突发推理用按量更合适,如果包月实例利用率低,闲置浪费可能把折扣吃回去,先估利用率,再选租期。
租用GPU算力时哪些费用最容易被忽略?
存储盘和快照、公网带宽与跨地域流量、商业镜像或平台服务费、竞价中断后的重跑成本、闲置GPU,账单里通常同时出现计算、存储、网络三类条目,逐项核对才能还原真实单价。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/790265.html