训练和推理的算力需求差异极大,训练动辄需要数百上千张AI加速卡持续运行数周,而推理往往单卡甚至CPU就能完成一次响应,两者差距可达几个数量级。
为什么训练和推理的算力差距如此悬殊
理解这个差异,得先看清两个阶段干的事情完全不同,训练阶段像“刷题备考”,模型要把海量数据反复咀嚼成千上万遍,才学得会规律,推理阶段像“上场答题”,模型拿着已经学好的本领,根据新输入快速给出答案。
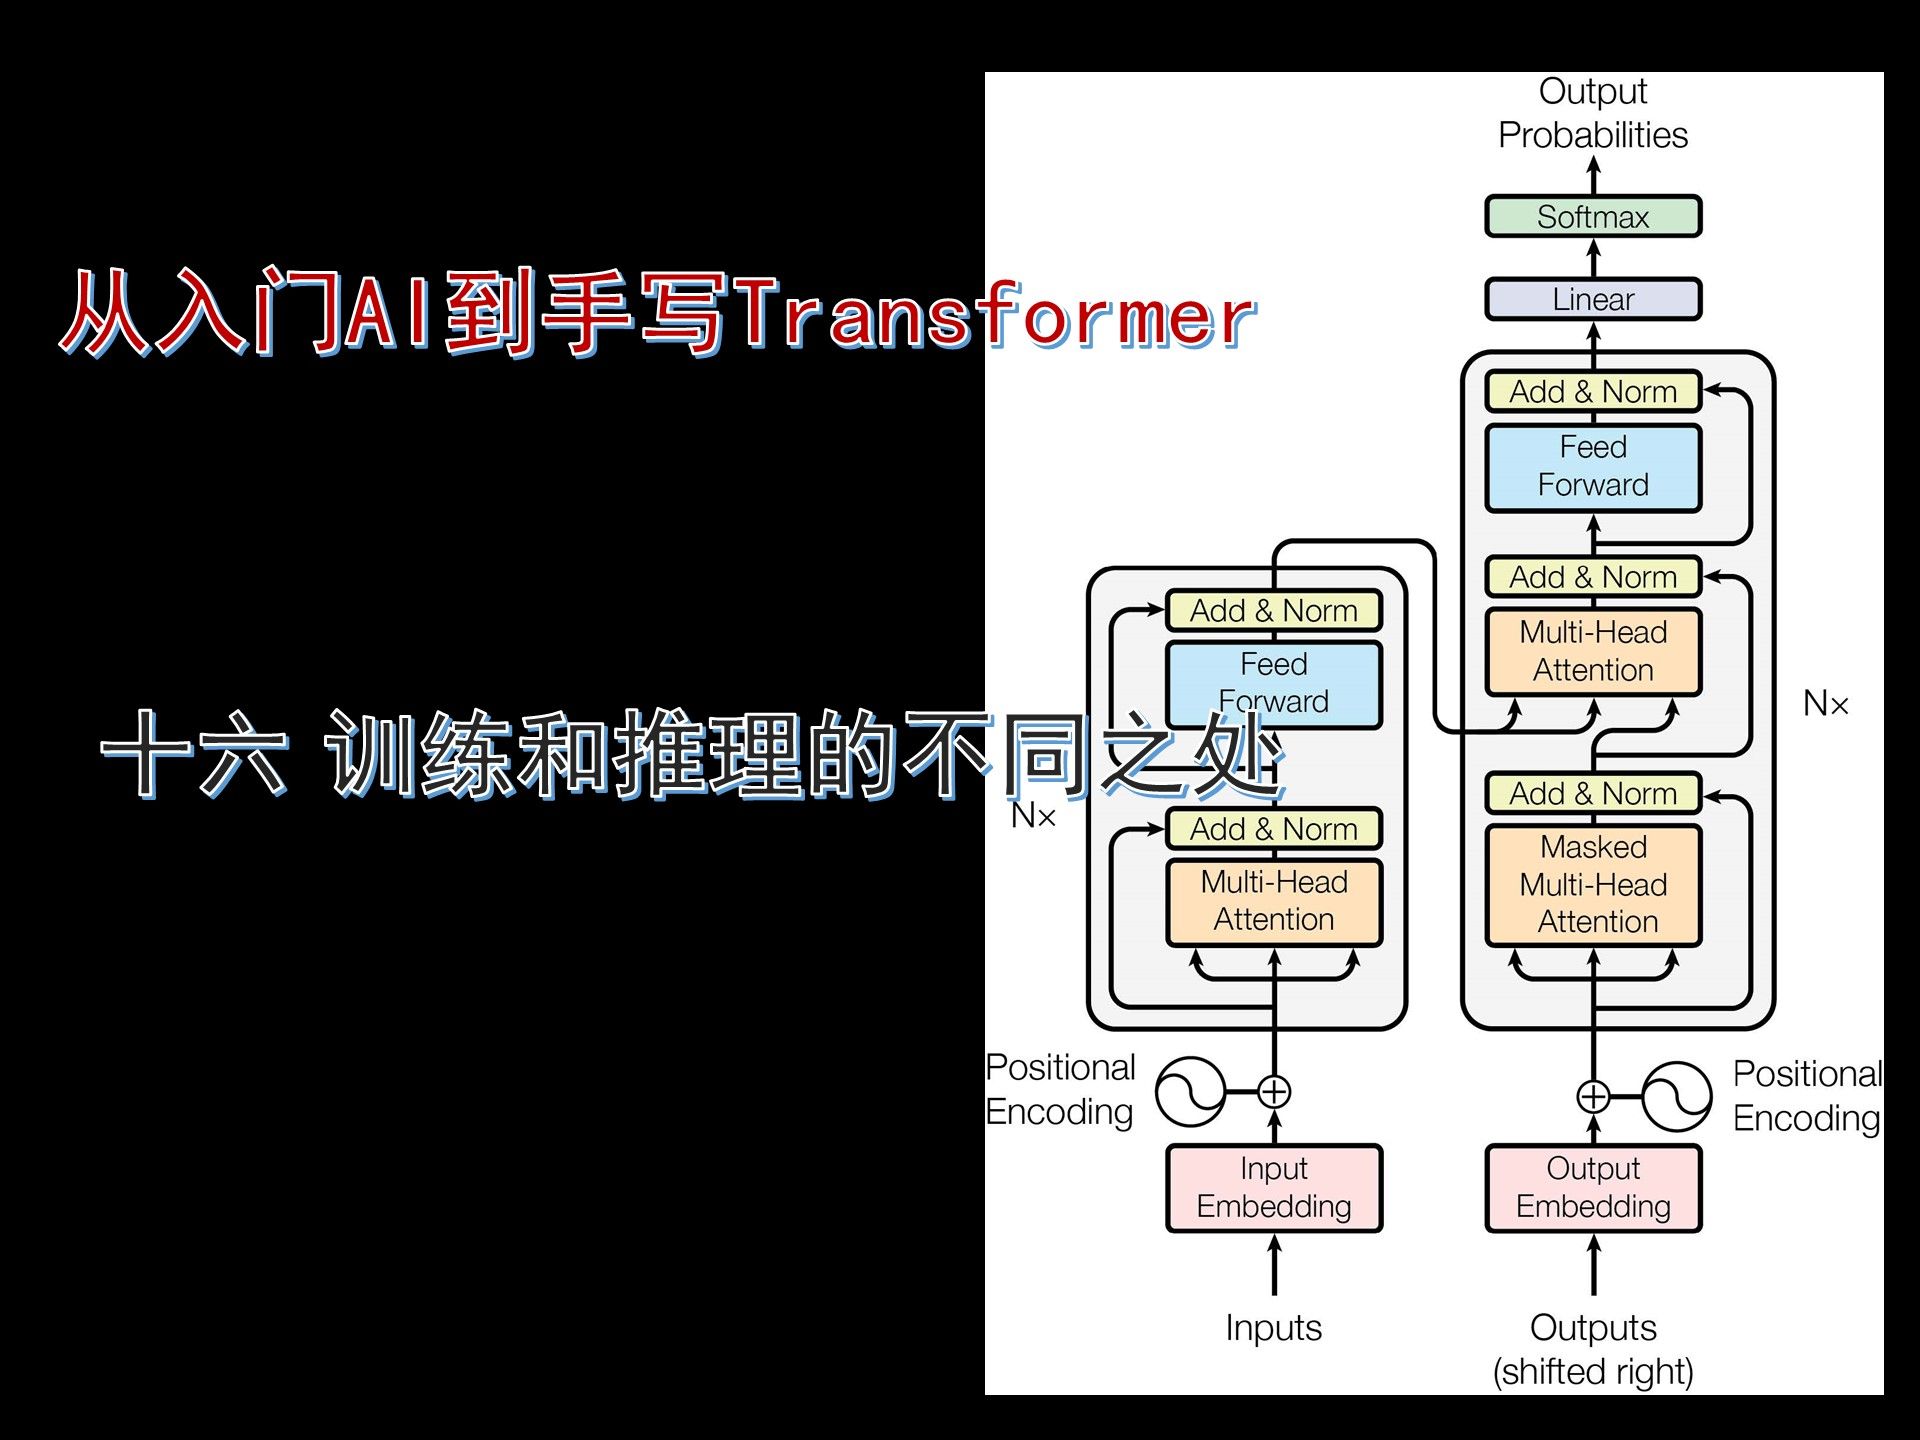
训练是“暴力计算”,推理是“快速反应”
训练一个百亿参数级别的大模型,业内专家指出,算力消耗的绝大部分集中在反向传播和梯度更新,每看一遍数据,模型都要调整几十亿甚至上千亿个参数,计算量是前向传播的两到三倍,而推理只做前向计算,参数固定不动,输入一段文字,跑一遍网络就出结果。
举个直观对比:
- 训练GPT-3级别的模型,据行业公开信息,需要数千张A100显卡连续跑几十天,总算力消耗以“百亿亿次浮点运算”为单位。
- 推理同样的模型,回答一个问题只消耗一次前向传播的算力,单张消费级显卡每秒能处理几十个词,延迟控制在毫秒到秒级别。
数据量放大算力鸿沟
训练要“喂”足够多数据,高质量数据集动辄数TB,每token都要参与多轮迭代,推理阶段每次请求只有几十到几百个token,按训练token总量与单次推理token量的比值,差距轻松达到百万倍以上,即便把训练成本摊到无数次推理上,单次成本也远低于训练单次样本的成本。
算力需求差异背后的三个核心维度
训练和推理不只差在“量级”,在硬件选型、计算特性、工程优化上都完全不同。
并行策略不同:训练靠集群,推理靠单卡
训练必须把模型切分到多卡甚至多机,依赖张量并行、流水线并行、数据并行组合,卡间通信量巨大,对NVLink和InfiniBand带宽极度敏感,推理则更看重单卡算力与显存容量,能用单卡跑通就尽量不跨卡,因为跨卡通信会显著拉长延迟。
| 对比项 | 训练阶段 | 推理阶段 |
|---|---|---|
| 核心指标 | 吞吐量(每秒处理样本数) | 延迟(首字响应时间) |
| 硬件形态 | 大规模集群,H100/A100千卡起步 | 单卡/双卡服务器,甚至CPU就能跑 |
| 内存需求 | 需要存储梯度、优化器状态,显存是参数的十几倍 | 只需存参数权重,显存占用约为参数大小 |
| 是否允许高延迟 | 可以,任务跑几周没问题 | 不允许,用户等不了几秒 |
| 性价比优化方向 | 提升算力利用率,减少空闲 | 降低单次成本,提高并发 |
显存占用差一个数量级
训练时格外耗显存,一个10亿参数的模型,用FP16存储权重才占2GB,但训练时还需要存梯度(2GB)、优化器状态(Adam优化器要存两个动量,共4GB),加上中间激活值,实际轻松超过10GB,是推理时的五倍以上,推理时可以直接加载FP16或INT8量化权重,一个10B模型单卡即可部署。
精度要求不同
训练普遍用FP16或BF16混合精度,后向传播需要动态范围大、稳定性高,推理则可以用INT8、INT4量化,精度损失一点,但显存减半、速度翻倍,这也是为什么推理端经常看到“量化部署”的玩法,训练团队则很少冒险低精度训练。
训练算力成本是推理的多少倍
行业内有个粗略但普遍认可的说法:训练成本占总算力成本的70%-80%,推理占20%-30%,这还不是最极端的,前沿大模型开发中,算上数据清洗、实验调参、多版本试错,训练成本占比会更高。
一个实际的成本感受
训练一个中等规模的垂直模型,租用8卡A100服务器,按2026年国内常见行情,每卡每小时租金在20-40元左右,训练跑一周的成本大概7万到8万元,而推理部署,用一张消费级显卡甚至纯CPU就可用量化模型服务几百个用户,单次问答电费成本不到一分钱。
为什么推理总成本反而可能更高
虽然单次推理便宜,但推理是持续运转的,一个日活百万的对话机器人,每天处理数百万次请求,按每token电费折算,年推理成本轻松超过一次训练成本,杭州一家AI创业公司算过账:他们训练一个30亿参数的客服模型,花了几十万元,但上线后每月推理的服务器租用费就要十几万,训练是“一次性付全款”,推理是“分期付款”,真要比总花费,得看业务量。
不同场景下算力配置的差异
实际落地时,不同规模模型和业务类型,训练与推理的配置差距感受完全不同。
小模型场景:差距在缩小
参数量低于7B的模型,比如BERT、T5-small,训练用单卡或双卡即可完成,推理更轻量,对于这类模型,训练和推理的差异没有大模型那么夸张,有时CPU推理和GPU训练混着用都行。
大模型场景:训练是“基建”,推理是“运营”
百亿参数以上模型,训练必须上集群,涉及网络设计、并行策略、容错检查点保存等技术细节,推理则要解决“看起来能用”和“跑得便宜”的平衡。
- 训练集群要配高速互联网络,8卡服务器之间用NVLink,跨机用RoCE或IB网络。
- 推理服务器更看重显存带宽和并发能力,大显存、高内存带宽的卡更吃香。
- 训练工程师写代码关注MFU(模型算力利用率),推理工程师关注TTFT(首token延迟)和吞吐量。
推理优化的实操思路
如果你要部署自己的模型,几个可验证的步骤能显著降低推理算力成本:
- 量化:将FP16权重转为INT8或INT4,用GPTQ或AWQ工具,通常显存减少一半以上,速度提升两倍左右。
- 批处理:把多个请求合并成一个批次推理,GPU吞吐量能提高数倍,延迟略微增加但可接受。
- 蒸馏:用大模型生成的小模型做学生模型,训练一个小而精的版本,推理成本直接降一个数量级。
- KV Cache优化:对话场景下缓存历史token的key/value,避免重复计算,长对话速度提升明显。
训练算力需求怎么估算,推理算力需求怎么估算
搞清楚两者的估算方法,才不会在采购或租用机器时踩坑。
训练侧的估算法则
估算训练所需算力,行业通用的近似公式是:
训练算力 ≈ 6 × 模型参数量 × 训练token数
这个6倍系数包含了前向和后向的计算量,比如一个70亿参数的模型,训练1000亿token,所需总算力约2×10²¹次浮点运算,用单张A100的FP16算力(约3×10¹⁴ FLOPS)除以得到秒数,再除以显卡数,就能粗略算出训练时长,实际还要打折,因为卡间通信和波次损失通常会让MFU只有40%-60%。
推理侧的估算法则
推理算力看的是单次响应成本,核心公式:
- 每token计算量 ≈ 2 × 模型参数量(推理只需前向,系数是2)
- 显存需求 ≈ 参数量 × 每参数字节数(FP16是2字节,INT8是1字节)
实操中直接看模型卡得动不:7B模型FP16需要14GB显存,配24GB显卡就能跑;70B模型FP16需要140GB显存,一张卡不够,得用4张80GB卡或多张卡分片。
为什么许多企业开始“重推理轻训练”
过去大家觉得训练才是门槛,但现在风向变了,训练模型有开源社区大量成熟底座可用,行业共识认为,微调和推理部署反而成为多数企业真正持续花钱的地方。
复现和微调成本远低于预训练
真正从零训练的预训练模型,成本动辄千万级,只有少数大厂和头部科研机构玩得起,大多数企业直接用开源模型如Llama、Qwen、DeepSeek,做LoRA微调,几卡几小时就能搞定,而推理服务却要长期运行,按调用量付费。
端侧推理将进一步挤压训练算力比重
手机、PC、智能音箱上的大模型已开始跑在本地,不依赖云端,端侧推理用的是厂商自研NPU和量化模型,算力需求进一步降低,这也是为什么业内普遍看好推理算力市场的长期增长,甚至认为推理算力需求终将超过训练。
常见问题解答
训练算力和推理算力哪个更贵?
训练贵在“集中爆发”,一次投入巨大;推理是“细水长流”,单次便宜但累计成本可观,如果模型服务用户量极大,年推理成本会超过训练成本,多数企业初期训练投入压力大,长期看推理预算占比持续上升。
一张显卡能做大模型训练吗?
能训,但只适合小模型或微调,比如7B参数模型用LoRA微调,单张24GB显存的消费级显卡可以跑,用时几小时到几天,但预训练70B模型就完全不现实,需要至少几百张卡协同训练,单卡显存和算力都不够。
为什么推理时模型还能比训练时“聪明”?
其实推理时模型没有变聪明,它只是把训练时学到的能力“提取”出来,推理阶段不需要更新参数,所以算力只用来做前向计算,速度自然比训练快几个数量级,这种感觉就像学生考前刷题很慢、很耗神,但考试时看到相似题型能快速作答,靠的是之前积累的成果。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/790584.html