Linux服务器之间拷贝数据库,最稳妥的办法是先用mysqldump或逻辑备份工具导出SQL文件,再通过scp或rsync传送到目标服务器执行导入,整个过程可以做到不停服、不丢数据。
选对拷贝方式比敲命令更重要
很多新手一上来就想着直接复制数据库目录,比如把/var/lib/mysql整个打包拷走,这种做法在数据量小、版本一致时勉强能用,但只要MySQL还在运行,拷贝出来的文件大概率是损坏的,因为内存中的数据页还没来得及落盘,行业共识认为,数据库拷贝必须区分场景来选择方案,而不是凭感觉操作。
常见的Linux服务器之间拷贝数据库,主要分三种思路:
- 逻辑备份:用mysqldump、pg_dump等工具生成SQL文本,跨版本、跨架构兼容性最好
- 物理备份:用xtrabackup等工具直接拷贝数据文件,速度快,但要求MySQL版本和系统架构基本一致
- 文件传输:无论哪种备份,最终都要把文件从源服务器搬到目标服务器,scp、rsync是主力
这三者不是互斥关系,实际项目中经常组合使用,下面逐一拆解。
linux服务器之间拷贝数据库用什么命令
如果你只是想快速把一个小型数据库(几GB以内)从一台Linux服务器搬到另一台,标准做法是mysqldump加scp的组合,这也是百度上搜索量最大的场景之一。
导出SQL文件并压缩传输
假设源服务器IP是168.1.10,目标服务器是168.1.20,数据库名是mydb,在源服务器上执行:
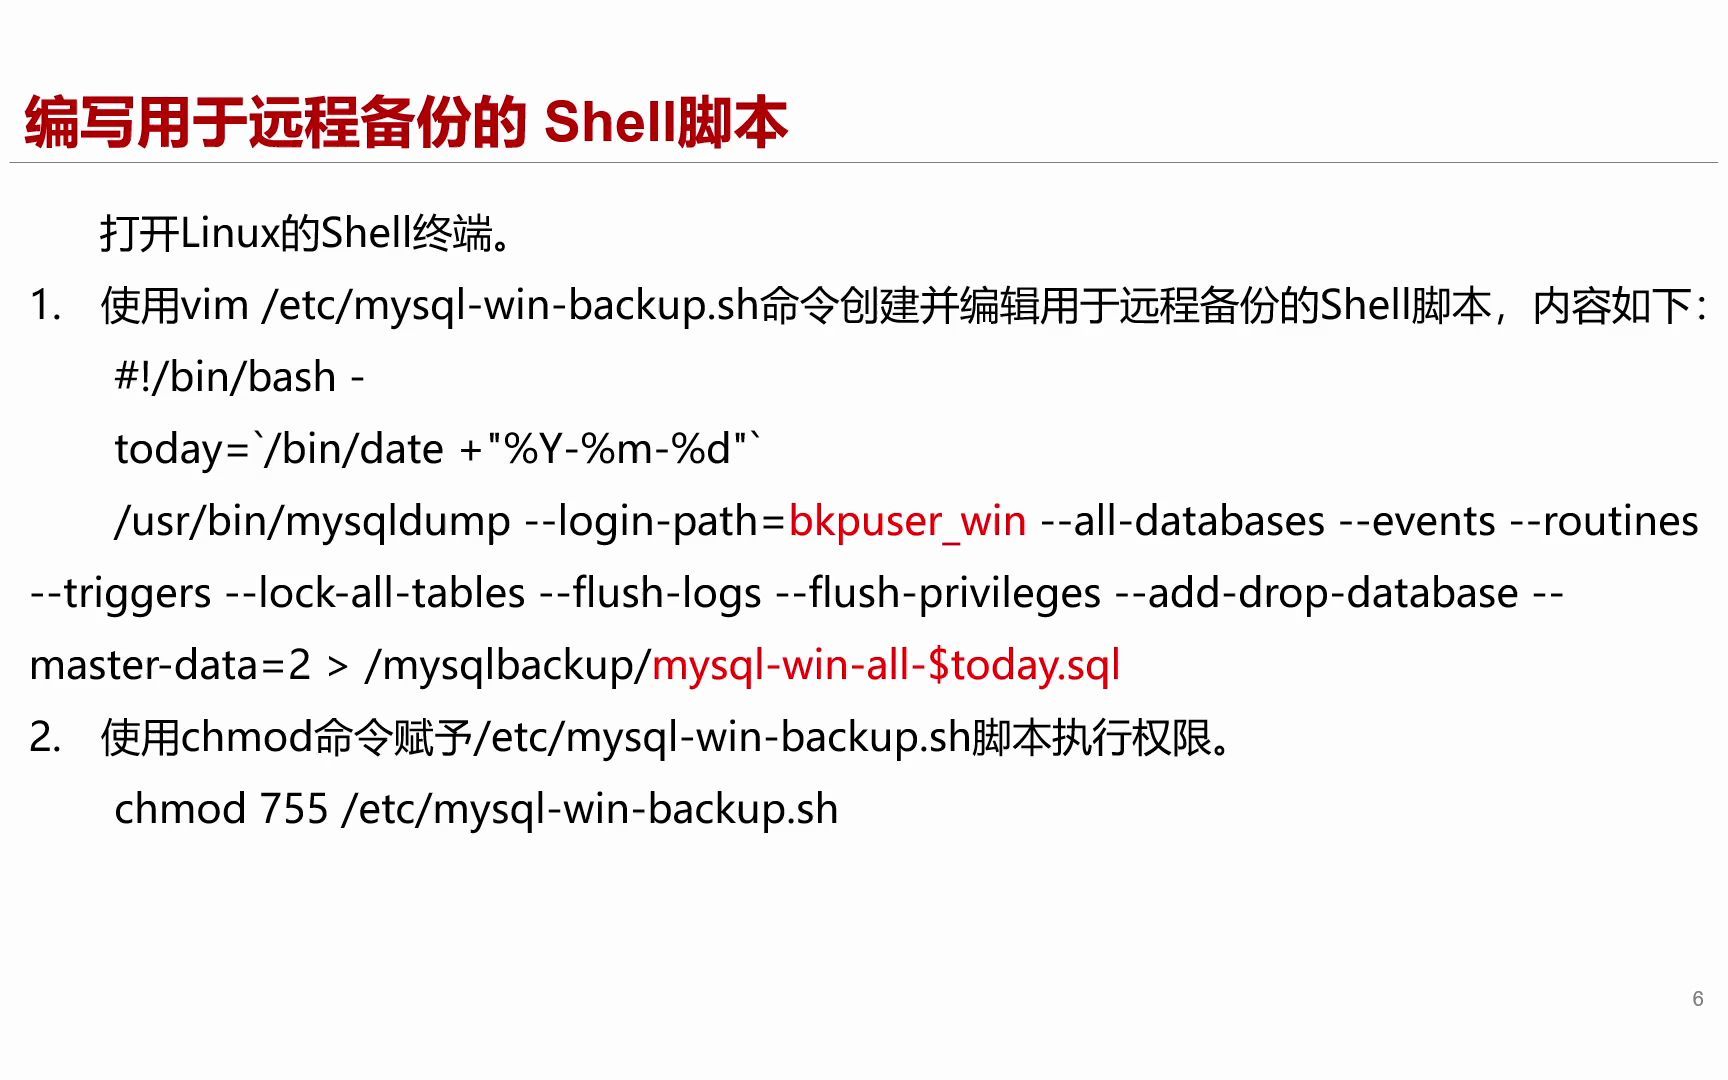
mysqldump -uroot -p --single-transaction --routines --triggers mydb > mydb.sql
--single-transaction参数很关键,它通过InnoDB的事务特性实现一致性快照,备份过程中不影响线上读写,如果不加这个参数,备份期间的表会被锁住,业务直接卡死。
接下来用gzip压缩,再用scp传过去:
gzip mydb.sql
scp mydb.sql.gz root@192.168.1.20:/root/
如果担心网络中断导致传输失败,改用rsync更稳:
rsync -avz --progress mydb.sql.gz root@192.168.1.20:/root/
rsync最大的好处是支持断点续传,传了一半断了,重新执行命令会从断点继续,不用从头再来,对于几十GB的备份文件,这个特性意义重大。
目标服务器导入SQL文件
登录目标服务器,解压并导入:
gunzip mydb.sql.gz
mysql -uroot -p mydb < mydb.sql
导入前记得先创建好同名数据库:
mysql -uroot -p -e "CREATE DATABASE mydb DEFAULT CHARACTER SET utf8mb4;"
字符集这里容易踩坑,源库如果是utf8mb4,目标库建成了utf8,中文和emoji必然乱码,建议导入前用SHOW CREATE DATABASE mydb查看源库的字符集配置,照抄到目标库上。
mysqldump备份和物理文件拷贝哪个更快
上面这套组合拳逻辑清晰,命令简单,但速度确实一般,mysqldump本质是生成SQL语句再逐条执行,数据量超过50GB时,导出和导入都要耗费大量时间。
相比之下,物理备份直接拷贝数据文件,速度能快出一个数量级,业内专家指出,生产环境中数据量在百GB级别以上,多数团队优先考虑物理备份方案。
xtrabackup物理备份实操
xtrabackup是Percona推出的开源物理备份工具,能在不锁表的情况下完成InnoDB数据文件的一致性备份,安装方式:
# CentOS/RHEL
yum install percona-xtrabackup-80
# Ubuntu/Debian
apt install percona-xtrabackup-80
备份命令:
xtrabackup --backup --target-dir=/backup/mydb_full --user=root --password=yourpass
传输到目标服务器:
rsync -avz --progress /backup/mydb_full root@192.168.1.20:/tmp/
目标服务器上执行恢复前准备:
xtrabackup --prepare --target-dir=/tmp/mydb_full
最后停掉MySQL,替换数据目录:
systemctl stop mysqld
rm -rf /var/lib/mysql/
xtrabackup --copy-back --target-dir=/tmp/mydb_full
chown -R mysql:mysql /var/lib/mysql
systemctl start mysqld
注意,xtrabackup要求源服务器和目标服务器的MySQL大版本一致,比如都是8.0.x,跨大版本恢复,比如从5.7恢复到8.0,大概率会报错。
物理拷贝与逻辑备份的取舍对比
| 对比维度 | mysqldump逻辑备份 | xtrabackup物理备份 |
|---|---|---|
| 备份速度 | 慢,逐行读取生成SQL | 快,直接拷贝数据页 |
| 恢复速度 | 慢,逐条执行SQL | 快,文件复制后即可用 |
| 跨版本兼容 | 好,5.7备份可恢复到8.0 | 差,要求大版本一致 |
| 跨平台兼容 | 好,Windows备份Linux可恢复 | 差,依赖字节序和文件格式 |
| 备份时锁表 | 默认锁表,加参数可避免 | 不锁表,基于MVCC机制 |
| 适合场景 | 中小数据量、版本升级 | 大数据量、同版本机房迁移 |
如果你的数据库在100GB以内,mysqldump完全够用;超过这个量级,直接上xtrabackup,别浪费时间。
大数据量数据库迁移到新服务器的完整流程
真实生产环境中,数据库拷贝从来不是一条命令的事,而是一整套流程,下面这套步骤是我在实际项目里反复验证过的,适用于TB级数据量,目标服务器为全新环境的情况。
第一步:评估数据量并选择窗口期
先登录源服务器查看库大小:
SELECT table_schema AS '数据库', ROUND(SUM(data_length + index_length) / 1024 / 1024 / 1024, 2) AS '大小GB' FROM information_schema.tables GROUP BY table_schema;
数据量在几十GB以内,业务低峰期直接mysqldump;上百GB甚至TB级,建议用xtrabackup做物理备份,同时准备一个业务低峰期或维护窗口,因为xtrabackup虽然不锁表,但备份过程中的I/O消耗会影响线上服务性能。
第二步:迁移前检查目标服务器环境
这一步很多人会跳过去,出问题后又回来排查,建议按下面清单逐项核对:
- 磁盘空间:目标服务器磁盘剩余空间至少是数据量的1.5倍,因为要同时容纳备份压缩包和解压后的数据文件
- MySQL版本:执行
mysql --version查看,最好和源库一致 - 字符集配置:检查
/etc/my.cnf中的character-set-server配置项,和源库保持一致 - 内存和CPU:导入过程中,MySQL的buffer pool会吃大量内存,建议目标服务器内存不低于源服务器的八成
- 防火墙和SSH权限:确认源和目标之间22端口互通,且你有目标服务器的root权限
第三步:执行数据拷贝
按前面介绍的方法,数据量小用mysqldump加rsync,数据量大用xtrabackup加rsync,这里补充一个rsync的进阶用法,通过SSH隧道直接传输,避免中转文件占用磁盘:
mysqldump -uroot -p --single-transaction mydb | gzip | ssh root@192.168.1.20 "gunzip | mysql -uroot -p mydb"
这条命令直接在源服务器上导出、压缩,通过SSH管道传给目标服务器并解压导入,全程不落地磁盘,如果网络质量好,这是最省事的方式;但如果网络差,中途断了整个流程就要重来,所以推荐在网络稳定的内网环境使用。
第四步:校验数据一致性
导入完成后,在目标服务器上执行:
mysql -uroot -p -e "SELECT COUNT() FROM mydb.users;"
和源服务器的结果对比,表行数应该完全一致,如果有差异,检查mysqldump输出有没有报错,或者用pt-table-checksum做深度校验。
最后检查一下视图、存储过程、触发器是否完整:
mysql -uroot -p -e "SHOW PROCEDURE STATUS WHERE db='mydb';"
mysql -uroot -p -e "SHOW TRIGGERS FROM mydb;"
这些对象不会跟着SELECT FROM table走,容易遗漏,务必单独确认。
第五步:切换业务连接
确定数据无误后,把应用服务器的数据库连接配置从源库IP改成目标库IP,重启应用,观察一段时间,建议保留源库一周再下线,万一目标库有问题还能随时回切。
不停服进行linux服务器之间数据库同步的方案
有些场景下,你不仅要做一次性拷贝,还需要两台服务器上的数据库保持实时同步,比如做读写分离或者机房迁移过渡,这时手动拷贝就行不通了。
基于主从复制的持续同步
MySQL主从复制是解决这个问题的标准方案,把源服务器配置为主库,目标服务器配置为从库,主库的写操作会通过binlog实时同步到从库,配置流程:
在主库的/etc/my.cnf中加入:
[mysqld]
server-id=1
log-bin=mysql-bin
binlog_format=ROW
在从库的/etc/my.cnf中加入:
[mysqld]
server-id=2
relay-log=relay-bin
然后在从库上执行:
CHANGE MASTER TO
MASTER_HOST='192.168.1.10',
MASTER_USER='repl',
MASTER_PASSWORD='yourpass',
MASTER_LOG_FILE='mysql-bin.000001',
MASTER_LOG_POS=154;
START SLAVE;
查看同步状态:
SHOW SLAVE STATUS\G
关键看两个字段:Slave_IO_Running和Slave_SQL_Running,都是Yes说明同步正常,这套方案需要提前在源库创建复制专用账号:
CREATE USER 'repl'@'%' IDENTIFIED BY 'yourpass';
GRANT REPLICATION SLAVE ON . TO 'repl'@'%';
主从复制有一个前置条件:从库需要先有一份主库的完整数据快照,你不能直接从零开始同步历史数据,所以实际操作流程是:先用mysqldump导出主库数据,导入从库,然后再配置主从复制。
主从复制和手动拷贝的区别
主从复制的优势在于传输的是binlog增量日志而不是整个数据文件,网络开销极小,每秒同步几千条事务都很轻松,但它也有维护成本,比如主从延迟问题,在跨机房场景下,专线带宽不够或延迟过大时,从库的数据会明显滞后主库,查询量较大的低频业务还能接受,但高频交易类业务通常不会让从库直接承接读流量,而是引入分库分表中间件做精细化路由。
如果只是做一次性数据迁移,不需要长期保持主从关系,迁移完成后执行STOP SLAVE并记录同步位置,再RESET SLAVE即可解除复制关系。
常见问题解答
两台linux服务器之间拷贝数据库一定要停服吗
不必停服,mysqldump加--single-transaction参数,xtrabackup本身就不锁表,两种方式都能在数据库持续读写的情况下完成备份和拷贝,但要注意,拷贝过程中的I/O消耗可能导致查询响应变慢,所以建议在业务低峰期操作,如果数据量极大且业务对性能高度敏感,可以考虑搭建主从同步让数据慢慢追平,最后平滑切换,只是配置周期会拉长。
scp和rsync拷贝数据库文件有什么区别
scp适合一次性传输,命令简单,但中断后要重新开始,rsync支持增量传输和断点续传,适合大文件和多轮同步场景,传输数据库备份文件时,rsync是更好的选择,尤其当备份文件有几十GB、网络又不太稳定时,rsync能显著降低失败重试的成本。
物理备份的文件能直接替换目标服务器的数据目录吗
不能直接替换,需要先用xtrabackup --prepare对备份文件做恢复前准备,应用日志中的事务,把数据文件恢复到一致状态,然后停掉目标服务器的MySQL,清空数据目录,再用xtrabackup --copy-back把文件复制回去,最后启动MySQL,全程操作顺序不能颠倒,否则启动时大概率报错。
数据库拷贝这件事,选对工具是前提,走对流程是保障,无论数据量大小,先确认两台服务器的MySQL版本和磁盘空间,再用mysqldump或xtrabackup配合rsync完成传输,最后做好行数和存储过程的校验,这个框架能覆盖绝大多数linux服务器之间拷贝数据库的需求。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/793000.html