目前市面上说的“联合渲染服务器”,实际上覆盖了三种形态:商业云渲染平台、通用GPU云服务器集群、本地自建联合渲染集群。 它们都能做到多台机器协同渲染同一项目,但入口、计价方式、适合人群完全不同,本文把这三种形态全部拆开,讲清楚各自的服务商、适用场景、价格逻辑和搭建路径。
主流的联合渲染服务器有哪些
商业云渲染平台(最省心的联合渲染方式)
这类平台把渲染服务器做成了“上传即渲染”的SaaS服务,你不需要关心底层有多少台机器,只需要把项目文件传到平台,它会自动分布式拆分任务,调度后台成百上千台服务器协同计算。
国内常用的有瑞云渲染、炫云、渲云,海外则以Chaos Cloud、Amazon Thinkbox(Deadline的云端版) 为代表,这类平台的核心优势是“算力弹性极大”,一部动画电影单帧切成多个区块,交由不同服务器同时渲染,能实打实缩短出图时间,据行业共识,商业云渲染平台在高峰期可调度的节点数达到数万个,远超普通工作室自建规模。
通用GPU云服务器(灵活度最高的联合渲染)
如果你希望完全掌控渲染资源,而不是把项目文件交给第三方平台,可以考虑用通用云服务器自己搭建渲染集群,简米云、酷番云、华为云、AWS的GPU实例(如A100、V100、RTX 4090云主机)都可以作为渲染节点。
操作路径是:在三到五台(或更多)云服务器上安装操作系统和渲染软件(如Blender Cycles、V-Ray、Redshift),再通过调度软件(如Deadline、Cgru)把任务分发到各台实例上,这种方式的优点是数据安全可控,按量付费,随时扩容;缺点是运维成本较高,需要自己处理共享存储、任务调度、故障恢复等问题。
本地自建联合渲染集群(大工作室的标配方案)
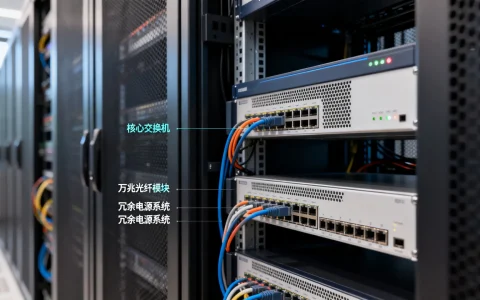
在自己的办公环境里把多台工作站或机架式服务器串联起来,通过局域网(万兆)连接共享存储,搭配调度软件构成小型渲染农场,这套方案在影视后期公司、建筑可视化公司、高校实验室中非常常见。
比较典型的做法是:一台“主控机”安装Deadline或Royal Render的调度器,其他机器安装客户端程序;做项目时,把渲染任务推送到中央队列中,调度器根据每台机器的CPU/GPU空闲情况自动分配任务帧。
联合渲染服务器怎么选才能不踩坑
按项目类型匹配选型
不同项目的渲染负载差异极大,没有一套方案能通吃所有场景。
- 室内设计效果图:单帧渲染时间通常在10分钟到2小时之间,用商业云渲染平台按张收费最划算,不用养设备。
- 影视级动画长片:需要大批量并发渲染,自建集群+云渲染混合模式是主流,日常负载用本地机器,突发峰值溢出到云平台。
- 短视频/广告特效:渲染量小但迭代频繁,适合用GPU云服务器按小时租用,渲染完就释放实例,成本可控。
- 科研或高校教学:预算有限的情况下,用多台普通台式机装Octane或Blender的分布式渲染插件即可,不需要购买专业服务器。
优先看调度软件兼容性
联合渲染服务器的核心不在于硬件本身,而在于调度引擎能否兼容你正在使用的三维软件和渲染器,比如Deadline支持Maya、3ds Max、Cinema 4D、Houdini、Blender以及V-Ray和Redshift;Cgru则偏重开源影视流程,选购或自建之前,先列一份你的软件清单,再反向筛选调度工具。
判断服服务器之间的通信稳定性
联合渲染的前提是节点间能稳定读取共享文件,如果部分节点在渲染中途读不到贴图或缓存文件,整个任务就可能卡住,选择方案时,可以要求服务商提供同区域节点的内网互通能力(云平台VPC),或者本地自建时使用万兆内网交换机和NAS存储。
本地搭建一套联合渲染服务器的具体路径
硬件准备
- 主控机:普通配置即可,主要用于跑调度软件和任务列表,不需要高端显卡。
- 渲染节点:根据常用渲染器决定偏CPU还是GPU,V-Ray CPU渲染优先堆核心数(AMD Threadripper或Intel Xeon),Redshift/Octane渲染则优先堆NVIDIA显卡显存和CUDA核心数。
- 共享存储:一台至少万兆网卡的网络存储(NAS)或云存储挂载,所有节点必须能同时读写项目盘。
软件部署流程
这里以开源的Cgru和商业的Deadline为例,给出通用操作步骤:
- 在主控机上安装调度服务端,设置好工作目录(建议放在共享存储盘内)。
- 每台渲染节点安装相同版本的渲染软件,并安装调度客户端,开机自启动服务。
- 在调度器管理界面添加节点,确认状态显示为“空闲(Idle)”。
- 在本地工作站中提交一段3~5帧的测试项目,验证节点是否能正确拉取工程文件并回传成品。
- 确认无报错后,再正式提交完整任务,由调度器自动分配帧数给各节点。
最大链路瓶颈排查
本地联合渲染最容易出的问题不是机器性能,而是网络带宽,当多台机器同时读取共享存储中的大体积贴图时,千兆网络会严重拖慢加载速度,行业共识认为,万兆内网是基本配置;如果预算确实有限,至少在项目交付前把贴图打包缓存到各节点本地盘,而不是全部实时访问共享目录。
联合渲染服务器价格体系与实际成本
商业云渲染平台的计费方式
大多数云渲染平台按“核时”计价:1个核时即1个CPU核心运行1小时,GPU渲染任务则按“卡时”(1张显卡运行1小时)计费,不同的软件和渲染器的单价不一样,且一般有“最低消费帧数”或“起步价”。
在一个常规室内效果图项目中,用云渲染平台渲染单张4K分辨率图片,单价通常在十几元到几十元不等,渲染一个几百帧的动画镜头,费用可能达到几百元到上千元,具体取决于分辨率、采样值和渲染器种类。新手尤其要注意,渲染器参数设置不当会让费用暴涨数倍。
自建联合渲染服务器的成本结构
自建方案前期投入较高,一个五节点(每台配RTX 4090显卡)的入门级渲染集群,硬件总成本约为十几万到二十万元,后续还需要考虑机柜空间、空调散热、电费以及硬件折旧,电费是长期支出的主要部分,如果每天满负荷运行8小时,五台高配GPU服务器的月电费大概率在数千元级别。
这里把两种模式的核心成本做成对比表格,看起来更直观:
| 对比维度 | 商业云渲染平台 | 本地自建联合渲染集群 |
|---|---|---|
| 前期投入 | 零成本,按需充值 | 单节点数万元起步,整体投入较高 |
| 单次项目花费 | 按核时/帧计费,项目型支出 | 主要是电费和硬件折旧,无单帧费用 |
| 算力上限 | 极高,可弹性调动海量节点 | 受限于自购硬件数量 |
| 运维门槛 | 几乎为零,网页端上传任务即可 | 需自行解决调度、存储、故障排查 |
| 数据安全 | 依赖平台安全和账号管理 | 数据完全在本地,安全性靠自身掌控 |
混合架构是当前主流趋势
大趋势上看,自建+按需上云的双模式混合调度已经非常成熟,多数制作公司的做法是:把日常稳定负荷留在本地,把临时大任务或截稿高峰期任务外发给商业云渲染平台,这样既不会因为长期闲置浪费硬件资源,也不会因为突发需求而被迫采购新设备。
不同场景下的联合渲染服务器推荐组合
建筑可视化公司(侧重稳定性和成本)
这类团队以3ds Max + V-Ray为主力工具,渲染任务量大且帧数多,本地搭建4~8节点的CPU渲染集群(多核高频CPU),再配合云渲染平台处理紧急镜头,是比较务实的组合,很多建筑可视化公司在重庆、成都等地采用这个模式,本地电费便宜,自建集群回本周期较短。
影视特效和动画工作室(高吞吐量需求)
项目规模大、时间紧、数据文件体积惊人,一般会优先选用支持多机分布式渲染的云渲染平台,比如瑞云渲染,后端调度的节点规模远超普通工作室能自建的数量,值得注意的是,影视项目保密等级较高,需要仔细看平台的数据隔离协议和文件加密机制。
中小型广告制作和个人设计师(性价比优先)
小型团队或个人设计师不太适合自建联合渲染,硬件利用率太低,直接在云渲染平台充值,按项目付费反而是最优路径,导出工程前,可以先使用平台自带的渲染参数设置建议,避免因为参数配置问题试错浪费费用。
关于联合渲染服务器的几个常见疑问
联合渲染服务器和普通电脑渲染的区别是什么?
普通电脑渲染是单机处理,CPU/GPU全部资源只服务当前这一帧或这一个任务,联合渲染服务器把任务拆成多份,由多台机器并行运算,比如渲染100帧动画,自建一台电脑需要渲染100分钟,联合渲染调度5台机器后,理论上每人分20帧,20分钟就能完成全部任务,核心差异在于帧级或块级并行,适用重点是大分辨率静态图(切片渲染)和动画序列帧(分帧渲染)。
渲染速度的提升能达到什么水平?
大部分情况下,联合渲染的提升是几倍到几十倍,甚至更高,具体取决于节点数量和任务的并行化程度,如果项目文件存在全局关联(如光学传递、毛发缓存),部分节点需要反复读取依赖文件,实际提速会低于线性增长,建议用测试帧做短时跑分,再估算整体完成时间。
低配置电脑能不能加入联合渲染网络?
能,旧电脑或低配置机型可以作为辅助节点加入联合渲染集群,前提是操作系统版本匹配、安装对应客户端且能正常访问共享存储,在调度软件中设置该节点的优先级为“低”或“当空闲时才参与渲染”,就能让它成为不耽误日常办公的备用算力,对于Blender用户,还可以用Sheepit这类社区联合渲染平台,把多台个人电脑组成共享渲染池,完全不依赖商业服务。
联合渲染服务器的本质是用多机器并行换时间,选择商业云平台还是自建集群,取决于你的项目体量和长期使用频率。主流做法是商业云渲染处理突发峰值,本地集群消化日常负荷,两者结合才能在成本和速度之间找到平衡点。 先把软件兼容性和数据吞吐量理清楚,再决定走哪条路,就不会在采购和部署上做无用功。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/793273.html