把鉴权和限流前置到CDN边缘节点,是目前投入产出比最高的一道防线。 请求在离用户最近的节点就被判定掉,非法流量根本走不到源站,回源带宽和源站CPU都能省下来。
为什么要把校验和限流推到边缘
源站扛不住的往往不是正常流量
多数被拖垮的API,问题不在业务量增长,而在无效请求,刷接口的脚本、爬虫、被复用的测试Token、配置错误的前端轮询,这些请求有个共同点:它们不需要业务逻辑,只需要被识别并拒绝。
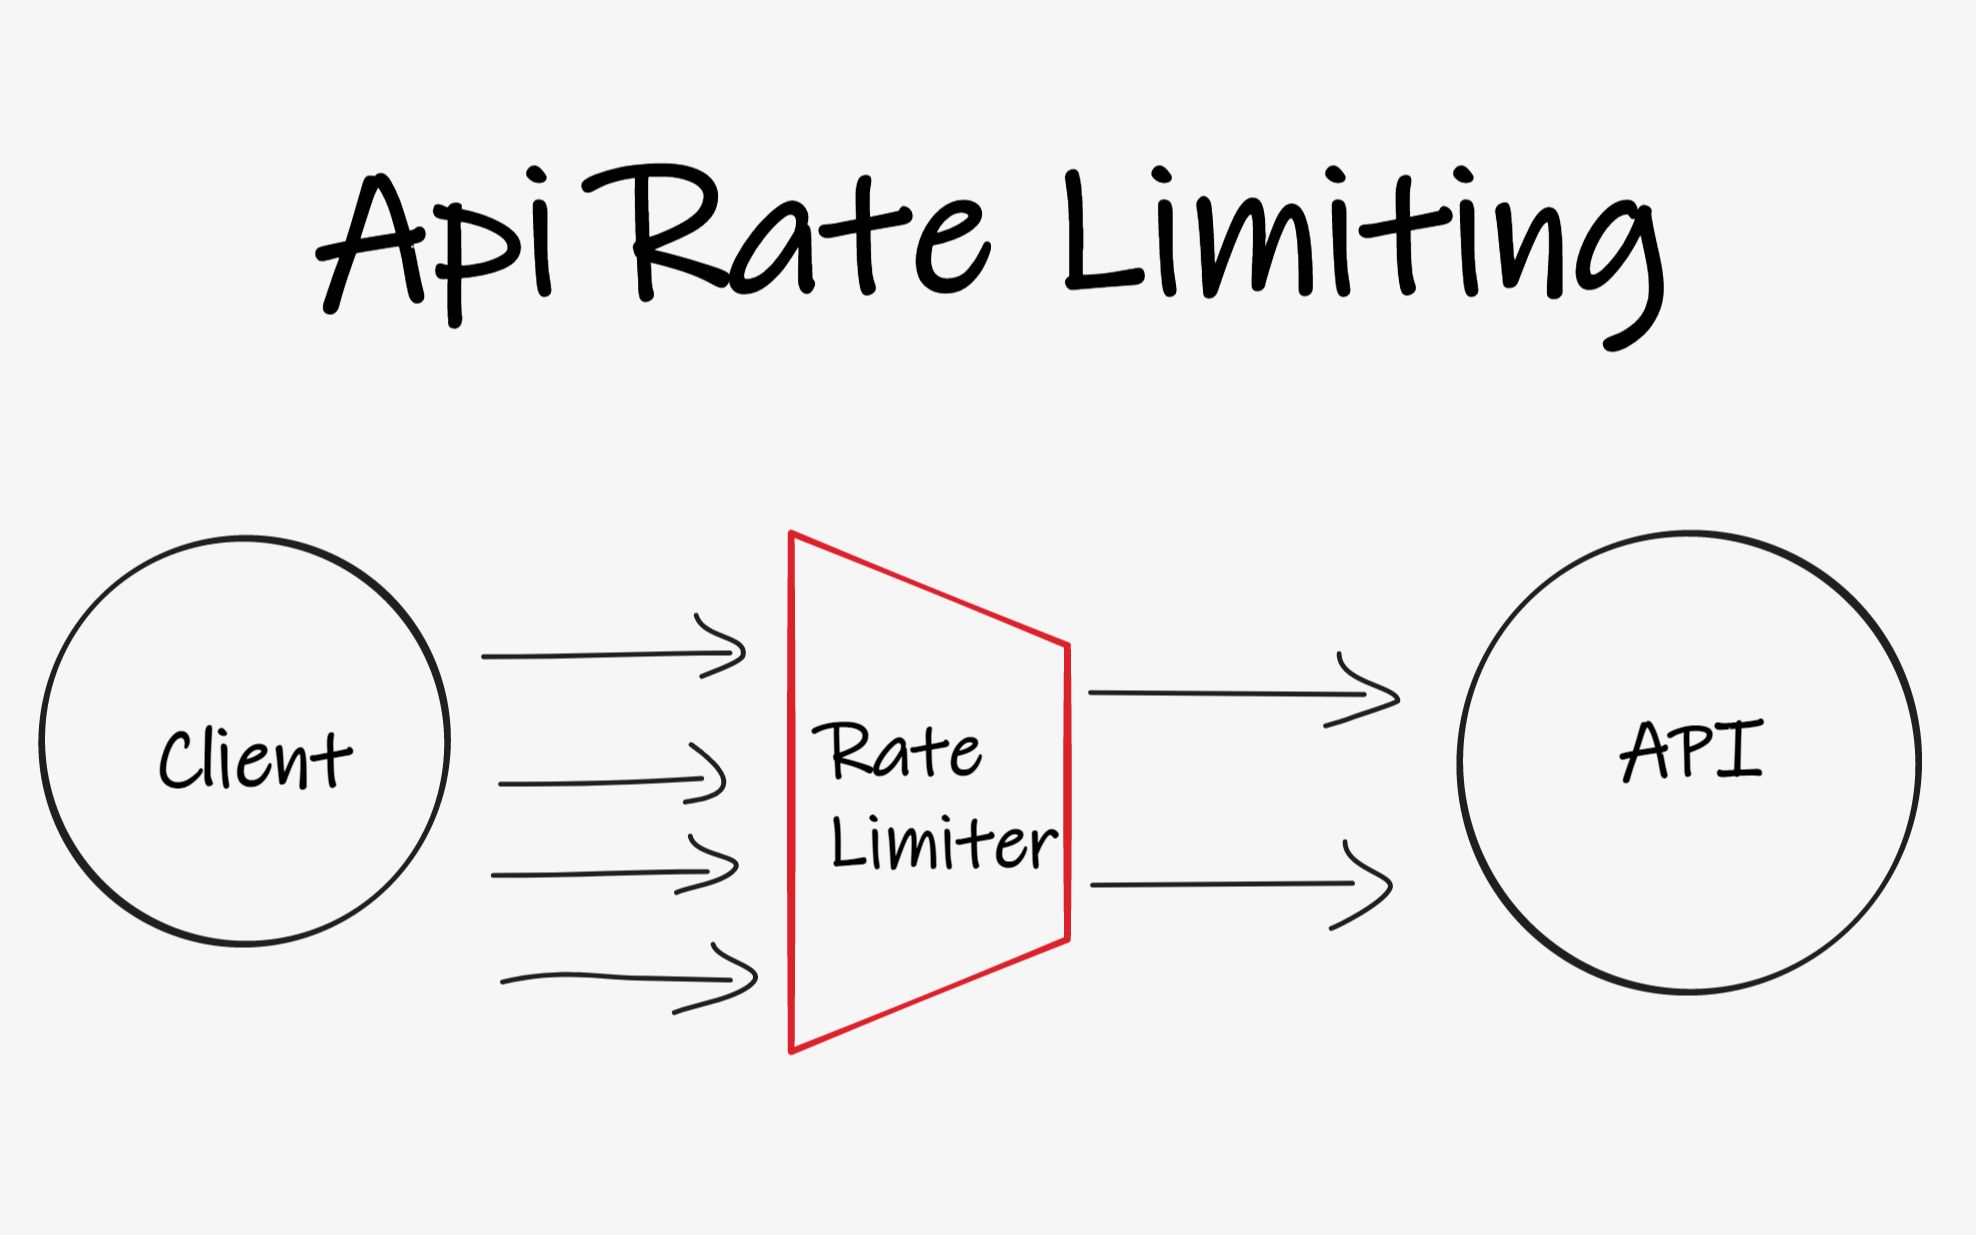
放在源站做这件事的代价很高,每拦截一次,都要占一个连接、过一次框架路由、查一次数据库或Redis,拦得越多,源站越忙,这显然是反的。
边缘拦截的三个直接收益
- 回源量下降:非法请求在边缘返回401或429,不出机房。
- 响应变快:边缘节点到用户的物理距离远小于源站,拒绝也比接受快。
- 源站更稳:突发流量被削峰后,源站的扩容节奏更从容。
据公开的CDN行业资料,API类流量在整体回源请求中的占比逐年上升,边缘可编程能力(边缘函数、边缘KV)的开放,是这两年CDN厂商集体发力的方向。
边缘校验:三层校验按成本从低到高排
校验不要一上来就写复杂逻辑,顺序错了,性能全浪费在小事上。
第一层:静态规则校验
不写代码就能配的部分,优先交给WAF和CDN控制台。
- 校验
Referer和User-Agent白名单,挡掉明显不是客户端发来的请求。 - 校验请求方法,把
TRACE、DELETE等业务用不到的方法直接拒绝。 - 校验路径和参数格式,
/api/v1/order/{id}里id必须是纯数字,正则不匹配就返回400。 - 限制请求体大小,超过阈值的直接断开,挡掉表单轰炸。
这一层几乎零成本,能过滤掉相当一部分低质量流量。
第二层:签名与Token校验
真正的身份判断放在边缘函数里做,边缘函数跑在CDN节点上,支持标准的WebCrypto,可以验证JWT签名,也可以做HMAC摘要比对。
// 边缘函数伪代码:校验JWT签名,不查库
async function verify(token, secret) {
  const [h, p, s] = token.split('.');
  const data = `${h}.${p}`;
  const key = await crypto.subtle.importKey(
    'raw', new TextEncoder().encode(secret),
    { name: 'HMAC', hash: 'SHA-256' }, false, ['verify']
  );
  const sig = Uint8Array.from(atob(s.replace(/-/g,'+').replace(/_/g,'/')), c => c.charCodeAt(0));
  const ok = await crypto.subtle.verify('HMAC', key, sig, new TextEncoder().encode(data));
  if (!ok) return { code: 401, msg: 'invalid signature' };
  const payload = JSON.parse(atob(p.replace(/-/g,'+').replace(/_/g,'/')));
  if (payload.exp  1000 < Date.now()) return { code: 401, msg: 'token expired' };
  return { code: 200, payload };
}
关键点:签名验证不需要回源,也不需要查数据库,密钥下发到边缘函数的环境变量里,节点本地就能算完。
第三层:需要状态的业务校验
有些判断绕不开状态,比如Token是否被主动吊销、用户是否被封禁、API Key的剩余额度,这类校验有两个选择:
- 边缘KV或边缘Redis,做近似判断,容忍秒级延迟。
- 直接回源,让源站判断,但只对高风险接口这么做。
行业共识认为,边缘层适合做无状态或弱状态的判断,强一致的业务状态仍然应该留在源站,硬把状态搬到边缘,最终会换来一堆数据同步问题。
CDN边缘计算怎么做API限流:三种常见落地方式
用CDN控制台自带限流策略
简米云、酷番云、Cloudflare等平台的控制台里都有现成的限流配置,按IP、按URL、按Header维度设置QPS上限。
优点是配置五分钟就能生效,不用写代码,缺点是维度固定,通常只到IP和路径级别,做不了”按API Key + 接口”这种复合维度,适合快速止血。
在边缘函数里做令牌桶
需要复合维度时,令牌桶写在边缘函数里最直接,核心是三件事:取令牌、判断余量、写回计数。
// 令牌桶:rate=每秒补充量,burst=桶容量
function allow(count, lastTs, now, rate, burst) {
  const delta = Math.max(0, (now - lastTs) / 1000);
  const tokens = Math.min(burst, count + delta  rate);
  if (tokens < 1) return { ok: false, tokens };
  return { ok: true, tokens: tokens - 1 };
}
计数存在边缘KV里会有一致性问题,多个节点各自计数,实际放行量可能超过设定值,所以边缘函数里的令牌桶,适合做粗粒度兜底,或者配合中心计数的定期同步使用。
回源前用共享存储做分布式计数
要求精确控制时,边缘函数不自己计数,而是把请求转给一个集中的限流服务,或者直接访问源站的Redis,代价是多一次网络往返,通常有几毫秒到十几毫秒的延迟。
折中方案挺常见:边缘做IP维度的粗限流,放行后再由源站或API网关做精确的账号维度限流,两层配合,各管一段。
限流响应要规范,返回429并带上标准头,客户端才知道怎么退避:
HTTP/1.1 429 Too Many Requests
Retry-After: 1
X-RateLimit-Limit: 100
X-RateLimit-Remaining: 0
X-RateLimit-Reset: 1730000000
API网关和CDN边缘校验有什么区别
这两个东西经常被拿来比较,其实定位不同。
| 对比项 | CDN边缘校验 | API网关 | 源站中间件 |
|---|---|---|---|
| 部署位置 | 离用户最近,全国多节点 | 区域入口,通常单区域或双活 | 应用进程内 |
| 网络延迟 | 最低 | 中等 | 最高 |
| 鉴权能力 | 无状态签名、静态规则 | 完整,支持多协议和插件 | 完全自定义 |
| 限流精度 | 节点级,近似 | 集群级,较精确 | 集群级,最精确 |
| 成本 | 边缘函数调用费 + 流量费 | 实例规格费 | 服务器成本 |
| 适合场景 | 挡脏流量、削峰 | 统一治理、计费、审计 | 业务级精细控制 |
结论很清楚:不要用边缘校验去替代API网关,让它管好第一道门就够了,谁负责挡人,谁负责管人,分工别混。
电商大促场景下的API接口限流配置清单
一个可复用的维度组合
大促期间流量结构很不一样,单一维度肯定不够,建议按这个顺序配:
- 全局总QPS上限,防止CDN整体被打爆。
- 按IP限流,阈值要放大,因为存在大量NAT出口共用IP。
- 按API Key或用户ID限流,这个才是真正的业务配额。
- 按接口路径限流,下单和查询的阈值必须分开。
- 按地域限流,识别异常来源集中的区域。
维度之间是”与”的关系,任何一层不通过就返回429。
CDN边缘限流服务多少钱一年
这也是被问得最多的问题,实际情况是,主流CDN厂商一般不对边缘限流单独收费,费用主要落在三个计费项上:
- 边缘函数的调用次数和执行时长;
- CDN的出流量,拦截掉的请求不计或者少计流量;
- 部分平台对边缘KV的读写次数单独计费。
所以年成本不是一个固定数字,取决于API请求量级和边缘函数的复杂度,想控成本有个朴素的办法:把静态规则放在边缘函数之前,让函数只处理真正需要算的请求。
地域节点与回源链路
地域这层容易被忽略,华北、华东、华南的节点密度不同,同一条限流规则在节点少的地方更容易误伤,配置时建议先看监控里的节点分布,对节点稀疏的区域把阈值适当放宽,同时把回源超时调长一点,避免网络抖动被当成拒绝而重复重试。
上线后怎么验证和调参
配完不等于结束,限流规则最怕两种情况:太松没拦住,太紧误伤用户,上线后看这几个信号:
- 429占比:突然升高说明阈值偏紧,或者被攻击了。
- 回源量变化:边缘拦截生效后,回源QPS应明显下降。
- P99延迟:边缘函数引入的执行耗时要算进总延迟,超过预期就检查函数里有没有回源调用。
- 误伤投诉:抽样看被拒请求的IP和Header,判断是不是正常客户端。
调参顺序建议先放宽IP维度,收紧Key维度,因为IP维度最容易误伤,Key维度才是真正该管的。
关于API接口CDN边缘校验与限流的常见问题
边缘限流为什么会误伤正常用户?
最主要的原因是IP复用,企业出口、运营商NAT、移动网络共享IP,背后可能是成百上千个真实用户,按IP限流卡死,最后一个都进不来,解决办法是IP维度只做粗筛,阈值设得足够宽,真正的配额交给API Key或用户ID维度。
CDN边缘校验能完全替代API网关吗?
不能,也没必要,边缘节点擅长做无状态判断和快速拒绝,但涉及计费、审计、协议转换、多服务路由这些事,API网关更合适,业内专家指出,把边缘定位成”流量过滤器”而非”业务入口”,架构反而更清晰。
CDN边缘函数的限流计数,多个节点怎么保证一致?
严格一致做不到,边缘KV天生是最终一致的,可行的做法有三种:一是接受近似,把阈值设得比目标值保守一些;二是用中心化的限流服务做精确计数,代价是多一次往返;三是分层,边缘做粗限流,源站做精确限流,选哪种取决于业务对超发的容忍度。
最后再收一句:边缘校验是为了拦住不该进来的,边缘限流是为了让该进来的慢一点进来。 这两件事都不需要在源站做,越往前放,代价越小。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/793503.html