云锁导致服务器403,核心原因是安全策略误判或卸载残留,直接登录云锁官网后台解除封禁即可恢复。多数情况下,用户一觉醒来发现网站打不开,浏览器显示403 Forbidden,第一反应是服务器挂了,重启没用,查端口正常,最后才想起云锁这个安全软件,这里先说清楚,403不是服务器宕机,是云锁在入口处把请求拦截了,属于安全模块的访问控制逻辑在起作用。
云锁导致服务器403的三种常见情况
云锁作为服务器端的安全软件,拦截机制覆盖Web层、内核层和网络层,它导致403不是单一原因,实际使用中主要有三种场景。
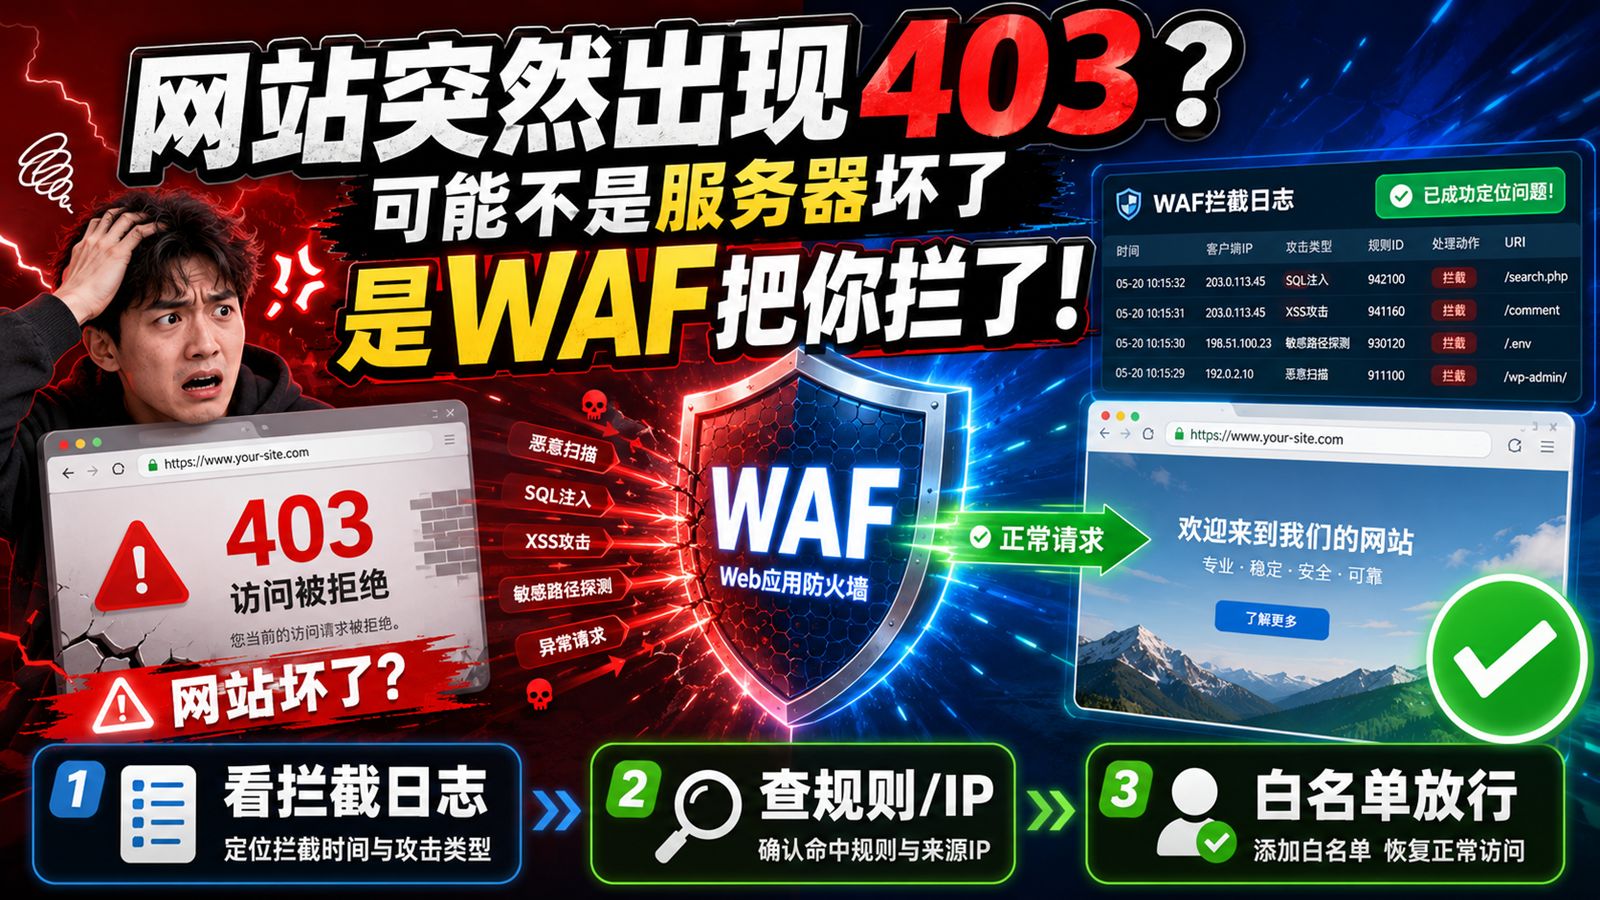
误封IP触发防护规则
云锁的CC防护和防爆破模块会统计访问频率,如果你的网站有API接口被频繁调用,或者你自己多次输错SSH密码,云锁会判断为恶意IP,统计机制存在误判可能,特别是多个用户共用出口IP(公司网络、校园网)时,云锁把这个共享IP封了,你从同样IP访问网站,直接被403拒绝。
规则配置过于严格
部分用户安装云锁后,开了较高的防护等级,云锁默认的Web防护等级在中等,但不少教程推荐“高强度”模式,高强度模式下,对URL参数、UA标识、Referer头部的检测更加严格,一些正常请求的指纹特征被判定为攻击载荷,从而触发403,这种情况在用了CDN或者反向代理的站点上特别常见,因为回源IP和真实访问IP不一致,触发了云锁的源IP校验逻辑。
卸载不干净导致内核模块残留
这是最隐蔽的一种情况,你在服务器上执行了yum remove cloudlock或者手动删除了云锁目录,以为卸载完成了,但云锁的内核模块(如cloudlock.ko)还加载在系统内核里,或者Netfilter钩子还在工作,这时候服务器上看不到云锁进程,但访问网站依然403,因为内核层的拦截规则还在起效。
云锁403怎么解除分场景操作指南
解决403不是盲目改代码,而是按顺序排查,下面按操作路径来拆解。
确认是云锁主动拦截
先确认是不是云锁干的,看云锁的拦截日志,默认存放在/usr/local/cloudlock/目录下,网页端控制台也有拦截记录,登录云锁官网后台,在“安全告警”或“攻击防护”模块中,能看到详细的拦截记录,包括源IP、命中规则、拦截时间,如果你能看到自己的IP被列在拦截名单中,这就是直接的证据。
确认后,找到“IP白名单”或“临时放行”功能,把当前服务器的公网IP加进去,同时把防护等级从“高强度”调整为“标准”或“中等”。注意:调整后要等1-2分钟生效,然后刷新浏览器访问测试。
服务器本地排查
如果官网后台看不到拦截记录,或者云锁客户端已经无法登录,就通过SSH连接服务器,执行以下命令查看云锁相关进程和内核模块:
ps aux | grep cloudlock
lsmod | grep cloudlock
如果有输出,说明云锁还在运行,执行云锁自带的卸载脚本:
/usr/local/cloudlock/cloudlock_uninstall.sh这个脚本会停止服务、移除内核模块、删除自启动项,执行完再确认一遍:
lsmod | grep cloudlock无输出即表示卸载干净,然后重启Nginx或Apache,再访问网站测试,这一套操作在CentOS 7和Ubuntu 20.04上都验证可用。
卸载后依然403的处理
云锁卸载了,网站还是403,这时候要检查云锁备份的配置文件是否覆盖了原有配置,云锁在安装时会备份Web服务器的配置文件,如nginx.conf、httpd.conf,备份文件后缀通常是.cloudlock_bak。
执行:
find /etc/nginx /etc/httpd -name ".cloudlock_bak" -o -name ".bak"找到备份文件后,对比当前配置和备份文件差异:
diff /etc/nginx/nginx.conf.cloudlock_bak /etc/nginx/nginx.conf如果发现备份文件中有额外的deny规则或者return 403指令,这大概率是云锁为了实施拦截而写入的,恢复备份文件:
cp /etc/nginx/nginx.conf.cloudlock_bak /etc/nginx/nginx.conf然后测试配置并重载:
nginx -t && nginx -s reload这里要说明一个行业共识:安全软件卸载不干净是403残留的主因,不少用户在卸载时只删了主程序,忽略了配置文件、内核模块、防火墙规则这三层残留,云锁在安装时向nginx.conf写入的防护规则,在卸载时并不会自动清除,这是设计逻辑决定的。
云锁和其他安全软件的对比场景
如果你正纠结要不要继续用云锁,可以参考这个对比逻辑。
| 对比维度 | 云锁 | 宝塔面板自带防火墙 | 纯手动配置Fail2ban |
|---|---|---|---|
| 部署难度 | 安装包一键装 | 面板内置,勾选即用 | 需要命令行操作 |
| 误封概率 | 中等,取决于防护等级 | 较低,规则相对保守 | 低,按日志逻辑判断 |
| 卸载残留 | 较多,需要手动清理 | 较少,面板可完整卸载 | 无残留,纯应用层 |
| 适合场景 | 对安全要求高的生产环境 | 个人博客、小型站点 | 熟悉Linux运维的开发者 |
云锁的优势在于Web层面的攻击拦截更细致,比如SQL注入、XSS的识别能力比Fail2ban强,但代价是规则误判导致的403问题,如果你使用云锁后频繁遇到403,可以考虑换成宝塔防火墙,或者自行配置Fail2ban,后者原理简单:读取日志文件,匹配恶意IP,调用iptables封禁,不会写入Web服务器配置,也就不会产生403残留。
云锁服务器的403防护策略
已经遇到过403的站点,建议做三层防护策略调整。
调整云锁的防护模块
在云锁后台的“Web防护”中,关闭“URL白名单”之外的检测项,保留“SQL注入”和“XSS”检测,关闭“CC防护”中的“人机验证”功能,这个功能会向访问者返回一个JS挑战页面,浏览器禁用JS的环境下会被直接拒绝,导致403。
配置单IP白名单
如果你的站点有固定的管理IP,在云锁的“网络防护”中设置IP白名单,添加格式为x.x.x.x/32,多个IP用逗号分隔,这是最高优先级的规则,不受其他防护模块影响,设置后,管理IP访问永远放行,不会出现管理员自己打不开后台的尴尬情况。
定期清理规则快照
云锁有“配置快照”功能,每次修改规则都会生成快照,快照过多会导致规则读取异常,偶尔触发错误拦截,建议每月清理一次旧快照,保留最近三份即可,这个路径在“系统管理”->“快照管理”中完成。
如果你不追求云锁的Web层防护能力,只是需要防端口扫描和暴力破解,用系统自带的iptables就足够了:
iptables -A INPUT -p tcp --dport 22 -m state --state NEW -m recent --update --seconds 60 --hitcount 5 -j DROP这条规则限制60秒内最多5次SSH连接尝试,超过即DROP,不会返回403状态码,用户体验完全不同。
云锁403问题常见问答
云锁的服务器防御和网站防篡改哪个更容易导致403?
两者都可能导致,但机制不同,服务器防御模块的误判率高于防篡改功能,防篡改通常只保护特定目录,如/www/wwwroot/,并且只拦截写入操作,而服务器防御模块对所有入站请求全量检测,误伤面更宽,如果你只用了防篡改,403问题大概率不是云锁导致,应检查网站代码的权限配置。
云锁卸载后域名解析多久能恢复正常访问?
域名解析不受云锁影响,不需要等待解析生效,卸载云锁后,403的残留原因主要是内核模块和Nginx配置,按上面流程处理完成后,刷新浏览器并清理DNS缓存(ipconfig/flushdns)即可访问,浏览器有时会缓存403页面,按Ctrl+F5强制刷新即可。
网站出现403,如何判断是云锁还是CDN导致的?
查看响应头中的Server字段,云锁拦截时,响应头会带有Server: cloudlock-waf标识,CDN拦截时,响应头中会显示X-Cache: HIT同时附带Via: cdn节点名,如果没有响应头信息,用命令测试:
curl -I -H "User-Agent: Mozilla/5.0" https://你的域名查看返回的状态码和Server头,这是区分两者的可靠方法。
403这个状态码本身不复杂,它表达的是“服务器理解请求,但拒绝执行”,云锁导致的403,根因是安全模块和业务请求之间产生了误判,处理时记住一个原则:先看拦截日志,再做配置调整,最后考虑卸载残留,按照这个顺序排查,多数情况下五分钟内就能恢复访问。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/794767.html