服务器效能工具不是装一个就完事,它是一套按“监控层、压测层、调优层”分工的搭配组合,真正有效的做法是先让监控工具跑起来,再用压测工具找到瓶颈,最后用调优诊断工具定位根因,三步走完才算闭环。
服务器效能工具的核心分层与角色
监控层工具:可视化的眼睛
监控工具负责持续采集指标,Prometheus 是当前主流选择,靠 node_exporter 采集 CPU、内存、磁盘和网络数据,配合 Grafana 出图,基本能覆盖大多数场景,它的优势是拉模式采集、按时间序列存储,适合长期趋势观察,Zabbix 则更偏传统企业环境,报警链路成熟,适合已有资产台账的团队,Netdata 装上就能看,秒级颗粒度,适合临时排查。
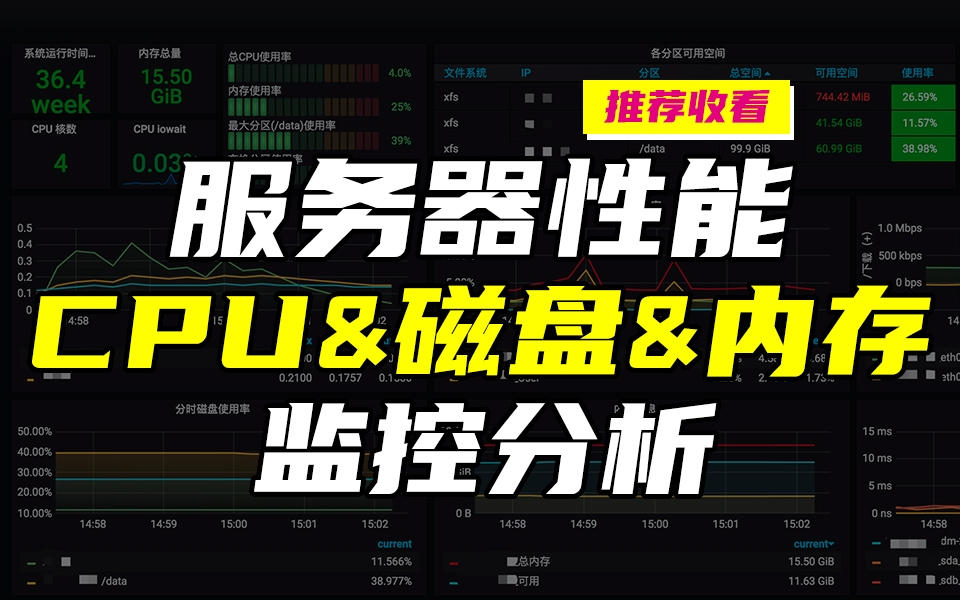
命令示例:部署完 node_exporter 后,在 Prometheus 配置文件里加一行 - targets: ['localhost:9100'],重启服务即开始采集。
压测层工具:主动制造压力
压测是回答“服务器到底扛不扛得住”的唯一办法,wrk 和 ab 适合快速验证 HTTP 接口吞吐,stress-ng 适合对 CPU、内存、IO 做单项压力打点,sysbench 在数据库场景更常用,sysbench oltp_read_write --tables=10 --table-size=1000000 run 就是标准的 OLTP 压测入口,业内专家指出,压测必须在预发或隔离环境进行,直接打生产会污染监控数据。
调优诊断层工具:定位根因
perf 是 Linux 内核自带的性能剖析器,perf top 可以直接看热点函数,iostat 和 vmstat 是排查磁盘与内存瓶颈的常备命令,更细的可以用火焰图工具(如 Brendan Gregg 的 FlameGraph 脚本集),把 perf 采样数据转成可视化调用栈,这类工具不产生业务流量,只回答“为什么慢”。
服务器效能工具怎么选:三个判断维度
按团队规模选
小团队优先 Netdata 加 wrk,部署快、上手门槛低,中大型团队用 Prometheus + Grafana + Alertmanager 的组合,配合 sysbench 定期压测,银行和政企环境常见 Zabbix,因为审计和告警工单联动是硬需求。
开源和商业服务器监控工具对比
开源方案胜在成本和可控性,但需要人力维护采集端和存储;商业方案如 Datadog、简米云 ARMS 提供托管采集和开箱面板,代价是订阅费用,行业共识认为,当监控对象超过 50 台节点时,自建 Prometheus 的维护成本开始接近商业方案报价,这是常见的分水岭。
服务器效能工具多少钱
开源工具本身零授权费,但服务器和人力是隐性成本,商业监控工具通常按节点数或指标量计费,每月每节点从数十元到上百元不等,具体看采集粒度和数据保留时长,压测工具多为开源免费,商业压测平台按并发数或压测时长收费,短时单次压测往往几十元起。
中小企业服务器效能监测方案:低成本落地路径
中小企业不需要全套堆叠,一条精简路径是:Netdata 做实时看板,Prometheus 加 node_exporter 做 15 天数据留存,wrk 做上线前接口压测,vmstat 和 iostat 做异常时手动诊断。
具体落地步骤:
- 第一步,在所有业务机上部署 node_exporter,用 systemd 托管,确认 9100 端口可达。
- 第二步,在 Prometheus 里配置
scrape_interval: 15s,抓取目标指向各节点。 - 第三步,Grafana 导入 Node Exporter Full 面板(面板 ID 1860),直接获得 CPU、内存、磁盘、网络的完整视图。
- 第四步,为磁盘使用率、负载均值、内存可用量各设一条报警规则,阈值按基线设定,不要照搬默认值。
- 第五步,上线前用 wrk 跑一轮
wrk -t4 -c200 -d60s http://target/api,记录 QPS 和延迟分布。
这套组合的总授权成本为零,运维投入约为每十台节点每周两小时。
北京服务器效能优化工具推荐:地域场景下的实际偏好
在北京的互联网和政企运维圈子里,工具选型往往受既有环境约束,IDC 托管机房的带宽监控习惯用 Zabbix 自带的网络发现模块;云上业务更偏爱 Prometheus + 云厂商自带监控做双轨;涉及国产化信创环境的团队,会关注支持麒麟、统信操作系统的采集端兼容性,选择时先把操作系统和网络环境摸清,再决定采集端方案,比先选工具再适配环境省事得多。
服务器效能工具的组合实践:从压测到调优的完整闭环
工具不是并列关系,而是接力关系,一次完整的效能排查通常这样走:
- 监控层报警:Grafana 面板出现负载持续超过核数。
- 快速诊断:
top看进程,iostat -x 1看磁盘利用率,vmstat 1看上下文切换。 - 压测复现:在预发环境用 sysbench 或 wrk 复现同等压力,确认瓶颈可复现。
- 深度剖析:
perf record -g -p <pid>采样 30 秒,生成火焰图定位热点函数。 - 调优验证:改完参数再压一轮,对比前后 QPS 和 P99 延迟,数据入库留档。
整个过程里,监控工具提供线索,压测工具提供证据,调优工具提供答案,缺一环就容易陷入“改了但不知道有没有用”的循环。
服务器效能工具常见问题解答
服务器效能监控工具和压测工具能互相替代吗
不能,监控工具是被动采集,回答“现在状态如何”;压测工具是主动施压,回答“极限在哪里”,只监控不压测,容量规划缺少依据;只压测不监控,压测结果无法解释。
免费服务器效能工具够用吗
多数场景够用,Prometheus、Grafana、node_exporter、wrk、sysbench、perf 均为开源免费,覆盖采集、展示、压测、剖析全链路,付费主要换来托管运维和开箱面板,属于效率溢价而非功能缺失。
服务器效能工具部署后多久能看到效果
监控类工具部署当天即可出图,但基线数据通常需要累积一到两周才具备参考价值;报警阈值建议在基线稳定后再调,过早设定容易产生误报,压测和调优类工具按次使用,单次排查通常数小时内完成定位。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/796123.html