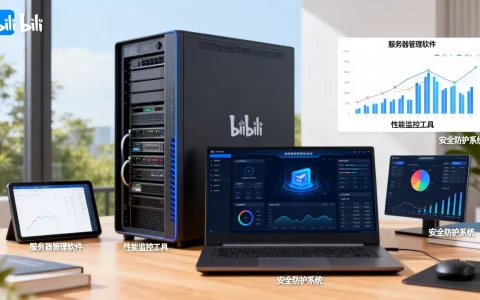
服务器监控的核心数据必须覆盖硬件资源、网络状态、应用性能和安全事件四个维度,缺一不可。只盯CPU和内存的监控方案,就像开车只看仪表盘上的转速表,迟早要出大问题,一套成熟的监控体系,应当让运维人员在服务器“生病”之前就收到预警,而不是等用户投诉了才去查日志。
硬件资源监控:服务器的“生命体征”
硬件是承载所有业务的物理基础,这部分监控数据直接反映服务器的“身体健康”状况,硬件资源监控是判断服务器是否稳定运行的基石,也是排查故障时最该优先检查的环节。
CPU使用率与负载均衡
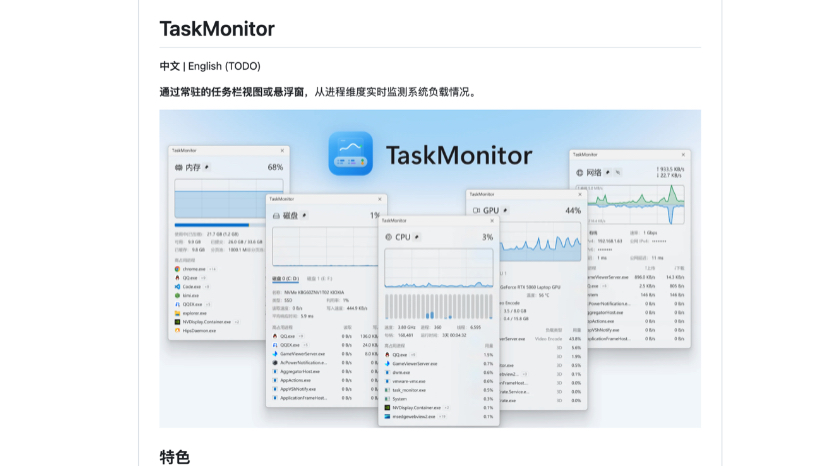
CPU是服务器的大脑。不建议只看单核使用率,要重点观察平均负载(Load Average)与CPU核心数的比值,如果负载长期超过CPU物理核心数,说明系统正在超负荷运转,在Linux系统中,你可以通过 top、htop 或 mpstat 命令实时查看,行业共识认为,对于线上生产环境,CPU平均使用率长时间超过85%就属于高危区间(注:此处85%为行业惯例参考值),具体需要根据业务场景判断,如果是处理视频转码或数据分析这类计算密集型任务,短时跑满也属正常。
内存使用率与交换分区
内存不足时,系统会使用交换分区(Swap)顶替,如果发现Swap使用率频繁波动且数值较高,说明物理内存已经捉襟见肘,监控内存不仅要看总量,更要关注可用内存和缓存(Buff/Cache)的回收情况,可以用 free -h 命令快速查看,更专业的做法是利用 vmstat 关注 si(swap in)和 so(swap out)两列数据,只要数值不为0,意味着频繁的磁盘读写正在拖慢应用速度。
磁盘空间与I/O吞吐
磁盘满会导致服务写入失败,甚至进程崩溃,监控磁盘时,建议覆盖三类指标:空间使用率、inode使用率、磁盘I/O等待时间,inode耗尽但空间未满,是运维人员常遇的隐形故障,对于数据库服务器,磁盘I/O等待时间(iowait)若持续偏高,往往说明磁盘性能成了瓶颈,需要评估是否升级为SSD或独立购买云盘,使用 iostat -x 1 可查看详细I/O状态。
网络与安全监控:服务器的“神经系统”
网络是服务器与外界沟通的唯一途径,网络监控的核心在于识别异常流量,而非单纯看带宽占满与否,安全层面,身份认证与日志审计早已成为服务器监控的必选项。
网络流量与连接数监控方案
服务器的网络连接数(TCP连接数)比带宽使用率更值得关注,比如一台Web服务器,如果TIME_WAIT状态的连接过多,说明请求处理速度可能跟不上,当网络连接数监控数据超过阈值时,优先检查是否遭到DDoS攻击或爬虫脚本骚扰。
- 出入带宽:可用
nload或iftop查看实时流量,结合企业带宽成本判断是否正常。 - TCP连接状态:重点盯
ESTABLISHED和TIME_WAIT两个值。 - 丢包率:作为判定网络稳定性的关键指标,持续丢包需立刻排查交换机或运营商线路。
安全事件与日志审计指标
安全监控是对系统防护能力的持续验证,不仅仅是装个防火墙就高枕无忧,需要重点监控的数据包括SSH登录日志、异常进程、文件完整性变更,具体操作方面,可以通过 lastb 命令查看失败的登录尝试记录,如果服务器监控数据中频繁出现来自陌生IP的密码爆破攻击,建议立即启用密钥登录并关闭口令登录,合规层面,安全日志留存周期需满足网络安全法要求,通常建议保留6个月以上(据网络安全法规定)。
应用与业务监控:服务器的“运行效率”
仅仅监控硬件层是不够的,服务器最终是为了跑业务,应用层的监控数据直接决定用户体验,业务数据通常通过接口或Agent采集,适合搭配APM(应用性能管理)工具使用。
进程状态与端口存活
服务器上的核心进程是否存活,比CPU使用率更能反映业务问题,需要监控Java进程、Nginx进程、MySQL进程等,专业的做法是监控进程数是否在合理区间,同时定期探测TCP端口(如8080、3306)是否正常监听,可以使用 ps -ef | grep 进程名 查看进程状态,或使用 ss -lntp 查看端口监听情况。
接口响应时间与错误率
接口响应时间急剧上升,通常意味着后端数据库查询变慢或代码出现死锁,建议将监控粒度细化到具体接口,例如将登录接口、支付接口的P99延迟(即99%的请求都在该耗时内完成)作为核心告警指标。相对于平均响应时间,P99值是更值得关注的监控数据,因为它能暴露最差的那部分用户体验,HTTP 500错误率上升往往比CPU跑满更具警示意义,说明后端逻辑可能出现了严重异常。
云服务器与物理服务器的监控差异及费用考量
很多用户在选型时会问“云服务器和物理服务器监控指标一样吗”,答案是底层指标相近但侧重点不同,如果公司采用云服务器,务必开启云厂商自带的安全告警和基础监控服务,同时将云监控数据接入自建平台。
- 云服务器:侧重网络带宽计费、云盘IOPS(每秒读写次数)、安全组策略控制,需额外关注云平台提供的“CPU积分”或“突发性能额度”消耗情况,这直接影响突发流量的应对能力。
- 物理服务器:侧重硬件故障预测,如硬盘SMART状态、内存ECC纠错、电源模块健康度,物理机需要配置带外管理系统(如IPMI)才能获取到硬件层面的底层监控数据。
价格层面,自建开源监控系统(Prometheus + Grafana)成本主要在于服务器资源和维护人力,而商业化监控产品(如监控宝、听云)通常按监控点数量收费,对于中小团队,建议先用云厂商自带免费监控额度,待规模扩大后再考虑付费方案,用户若在百度搜索“服务器监控软件种类有哪些”或“服务器监控告警阈值设置方案”,可以看到大量开源与商业工具的对比评测,选择时应优先考察与现有技术栈的兼容性。
监控数据采集后的告警与处理策略
采集监控数据不是目的,通过数据定位并解决问题才是目的,设置告警时,应该避免“一刀切”式的阈值,多数情况下,告警配置建议采用分级通知策略,防止服务器监控数据产生的告警轰炸导致运维人员“狼来了”疲劳。
- 紧急告警(短信/电话):CPU > 95%持续5分钟,磁盘使用率 > 92%,主进程宕机。
- 警告告警(邮件/钉钉):内存使用率 > 85%,接口P99延迟 > 2秒,出口带宽 > 80%。
- 信息记录(仅存档):登录失败次数增加、TCP重传率升高。
告警设置完毕后,建议每季度复盘一次“监控数据有效性”,具体到排查流程,当收到磁盘空间告警时,可执行 df -h 和 du -sh / 命令逐层定位大文件目录,再结合日志轮转策略进行清理,能够直接复制执行的排查步骤,远比长篇大论的理论分析更具实操价值。
关于服务器监控数据的常见疑问解答
问:监控数据需要存储多久比较合适?
监控数据本身也是数据,按主流实践经验,原始监控数据保留30天足够排查绝大多数问题,而聚合后的统计指标(如每周平均负载)可保留一年以上以便做容量规划,如果磁盘空间有限,可降低数据采样频率,例如将10秒一次的高频数据降为5分钟一次。
问:服务器监控数据种类越来越多,如何防止告警疲劳?
告警疲劳的根源是阈值设定不科学,建议优先治理告警源头,将重复告警合并发送,例如同一台服务器连续触发三次内存告警,只发送一条升级告警即可,可以用标签机制区分测试环境和生产环境,避免无效数据干扰判断,这样运维人员才会认真对待每一条告警信息。
问:服务器要监控哪些数据才能满足等保合规要求?
等保合规(即网络安全等级保护)对监控数据有明确要求,重点在于日志留存和审计,除了常见的CPU、内存、网络指标,必须额外采集登录日志、操作审计日志、安全设备日志应包含访问时间、源IP地址、操作账号、操作行为四大要素,具体到实践,需要开启系统日志服务和应用访问日志记录,并配置集中式日志收集平台保障数据不可篡改。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/796840.html