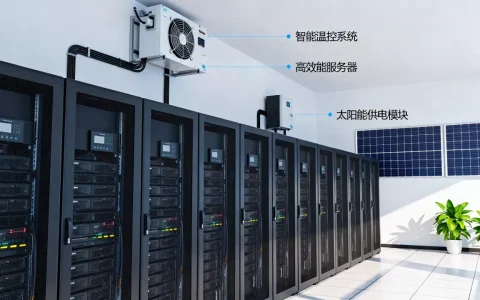
服务器维护的核心是围绕硬件健康、系统稳定、数据安全和性能优化四个维度展开的周期性动作,缺一不可。 它并非一次性任务,而是贯穿服务器整个生命周期的持续性工作,对于企业和站长而言,掌握一套科学的维护方案,远比出了问题再“救火”更重要。
硬件层面:摸清家底,防患于未然
服务器硬件是支撑所有业务的物理基础,多数企业服务器都部署在机房或机柜中,环境相对稳定,但硬件老化、积尘、散热不良等问题仍会悄然发生,硬件维护的核心目的,是赶在故障引发宕机之前发现问题。
硬盘健康状况的持续盯防
硬盘是服务器中最容易“暴毙”的部件,据统计,相当一部分服务器宕机事件都源于硬盘故障,日常维护中,我们需要重点检查硬盘的 SMART信息(自我监测、分析及报告技术)。
- 查看SMART状态: 在Linux系统中,可以安装
smartmontools工具,执行smartctl -a /dev/sda查看硬盘的通电时长、重映射扇区数、坏道计数等关键指标。 - 判断标准: 如果
Reallocated_Sector_Ct(重映射扇区计数)或Current_Pending_Sector(当前待映射扇区)数值持续上升,说明盘片物理介质正在退化,应尽快备份数据并申请更换。 - 阵列状态核查: 如果服务器配置了RAID(独立磁盘冗余阵列),需要定期登录阵列卡管理界面(如LSI MegaRAID),确认阵列状态是
Optimal(最佳)而非Degraded(降级),一旦处于降级状态,意味着有一块盘掉线了,此时需立即处理。
内存与CPU的隐性压力
内存泄漏和CPU占用异常是性能问题的常见诱因,维护时不能只看当前占用率,更要看趋势。
- 内存检查: 执行
free -h查看可用内存,长期运行的系统可用内存不应持续走低,如果Swap分区使用率居高不下,说明物理内存已严重不足。 - 负载观察: 使用
top或uptime命令观察load average(平均负载),该值长期超过CPU核心数(如4核CPU负载超过4.0),意味着系统已在高负荷下运行,容易出现请求超时。 - 温度与风扇: 带外管理系统(如iLO、iDRAC)中查看CPU温度和风扇转速,服务器过热会触发降频保护,导致处理性能大幅下降,行业共识是,CPU核心温度长期超过80℃,就需要检查散热硅脂或机房空调了。
系统与软件:打好补丁,升级底座
操作系统和核心软件是承上启下的关键层,老旧版本往往存在已知的安全漏洞和性能缺陷,系统维护的首要任务是保持基础环境的“新鲜度”。
安全补丁的及时更新
这是最基础也最容易被忽略的一环,很多管理员担心“打补丁导致业务不兼容”而长期不更新系统,这是极其危险的。
- Linux系统: 对于CentOS/Ubuntu等系统,建议每月至少执行一次
yum update(或apt update && apt upgrade),重点关注内核版本和OpenSSL、OpenSSH等基础组件的更新日志。 - Windows Server: 开启自动更新,并规划每月一次的补丁日(Patch Tuesday)检查,重启服务器前,务必确认非业务高峰时段。
- 操作建议: 在更新前,建议先在测试环境验证核心业务兼容性,若无测试环境,务必先创建快照(虚拟机)或备份重要配置,再执行更新。
日志审计与磁盘空间规划
日志文件是排查问题的第一现场,但也容易占满磁盘空间,磁盘满会导致数据库无法写入,甚至服务直接崩溃,这是服务器日常维护方案中必须包含的硬性指标。
- 关键日志路径: 重点关注
/var/log/messages(系统级日志)、/var/log/secure(安全认证日志,查爆破攻击)、Nginx/Apache访问日志和错误日志。 - 日志切割策略: 使用
logrotate工具,对日志按日期或大小(如每天切割或100MB切割)进行归档,并设定保留周期(如保留90天),防止日志无限膨胀。 - 磁盘空间检查: 使用
df -h命令查看分区使用率。当使用率超过85%时,需要及时清理临时文件或扩容,避免因空间不足引发连锁故障。
数据库与中间件优化
如果服务器承载了MySQL、Redis或Tomcat等中间件,维护工作需更深入一层。
- MySQL慢查询日志: 开启慢查询日志(
slow_query_log),分析执行时间超过1秒的SQL语句,优化频繁出现的慢SQL,对性能提升立竿见影。 - 连接数监控: 查看
max_connections(最大连接数)设置是否合理,若经常出现Too many connections报错,需要排查应用是否未释放连接,并适当调整连接池上限。 - 缓存命中率: 对于Redis,通过
INFO stats命令查看keyspace_hits和keyspace_misses,命中率低于90%说明缓存策略可能不太合理,需要优化数据淘汰策略。
安全维护:封堵漏洞,主动防御
安全维护在2026年的今天,已从“可选”变为必选,黑客攻击往往在几分钟内就能完成扫描和入侵,我们不能指望防火墙的默认策略就能高枕无忧。
账户与口令的强管控
服务器弱口令是导致入侵的最主要原因。
- 禁用Root远程登录: 修改
/etc/ssh/sshd_config,将PermitRootLogin设置为no,并修改默认SSH端口(如22改为高位数端口),能有效过滤掉大量定向扫描。 - 密钥认证取代密码: 使用RSA或ED25519密钥对进行SSH登录,关闭密码认证(
PasswordAuthentication no)。 - 定期审查用户权限: 删除不使用的僵尸账户,清理
/etc/sudoers中不必要的提权配置。
防火墙与入侵检测规则
仅靠系统自带防火墙是不够的,需要设置精细的访问控制。
- 最小化开放原则: 在防火墙(如
firewalld或iptables)规则里,仅放行业务必需端口(如80、443、数据库内网端口),对外网全部DROP。 - 入侵检测工具部署: 推荐安装
Fail2ban,它能通过分析日志,自动封禁多次密码错误的IP地址,这是防御SSH爆破攻击非常有效的工具。 - 定期检查安全更新公告: 关注Linux发行版或软件官方的安全通告(CVE漏洞),对于Nginx、Apache等对外服务,若出现远程代码执行漏洞,需在一周内完成升级。
数据备份:最后的生命线
安全维护做得再好,也敌不过误操作和勒索病毒,数据备份是服务器维护中最枯燥却最具救命价值的一环。
备份策略的3-2-1原则
行业公认可用的备份方案是“3-2-1原则”:核心数据保留3份副本,存储在2种不同介质上,其中1份存放在异地。
- 本地备份: 使用
rsync或crontab定时任务,将数据目录增量同步到本地另一块磁盘。 - 异地备份: 通过脚本加密压缩后,使用
rclone等工具同步到对象存储(如简米云OSS、酷番云COS)或另一台异地服务器,对于重要的数据库,建议每日凌晨进行全量备份,每6小时进行一次binlog增量备份,以便将数据恢复到任意时间点。
备份恢复演练
没有验证过可用的备份,等同于没有备份。 很多管理员设置了自动备份,但从未尝试恢复,建议每3个月进行一次随机恢复演练,确保备份文件的完整性和可用性。
- 在测试环境中恢复最新的备份文件。
- 检验恢复后的数据校验码是否一致。
- 计算从备份到恢复完好的总耗时(RTO,恢复时间目标),确认是否符合业务期望。
性能监控与巡检:从被动到主动
日常巡检不能依赖人工登服务器敲命令,那样效率低且容易漏项,一套完善的监控体系,能让我们在用户察觉问题之前就介入处理。
建立基础监控指标
使用开源监控工具(如Zabbix、Prometheus + Grafana)或云服务商自带的监控告警,重点关注以下指标:
- CPU使用率: 持续高于90%且无下降趋势,触发告警。
- 内存使用率: 持续高于90%,触发告警。
- 磁盘I/O等待(iowait): 数值长期过高,说明存储性能成为瓶颈。
- 带宽流入流出量: 接近峰值丢包时触发告警。
定期人工巡检清单
除了自动化监控,服务器日常巡检方案中还应包含每周或每月的人工例行检查,检查项包括听机房风扇噪音是否异常、登录带外管理系统查看有无硬件报错灯、检查机柜内是否有积尘或线缆松动。
| 巡检周期 | 核心检查项 | 检查手段 |
|---|---|---|
| 每日 | 磁盘空间、CPU负载、主要服务进程状态 | 监控面板查看 |
| 每周 | 检查系统日志错误、备份任务是否成功 | logwatch 或操盘日志 |
| 每月 | 系统补丁更新、更改重要服务密码、查看硬件生命周期 | SSH登录手动核对 |
服务器日常维护方案里容易忽略的“冷门”环节
在长期的维护工作中,有几个细节经常被新手忽略,但它们往往决定了故障恢复的速度。
- 时间同步(NTP): 如果服务器时间漂移严重,会导致数据库日志时间戳混乱、HTTPS证书验证失败,配置
chrony或ntpd服务,确保与权威时间源同步。 - 证书有效期巡检: 针对部署了HTTPS的服务器,证书过期将直接导致网站无法访问,99%的证书过期事件都是因为忘记了续期,建议在证书到期前30天设置日历提醒,或使用
acme.sh脚本自动续期Let’s Encrypt证书。
Q&A:关于服务器运维的常见疑问
问:服务器硬件维护检查项目具体有哪些?多久做一次比较合适?
答: 硬件检查项目主要包括硬盘SMART健康状态、RAID阵列状态、内存条(通过memtest86工具测试)、CPU散热风扇转速、主板电容是否鼓包、电源冗余模块是否正常,建议每月进行一次带外管理控制台的日志审查,每季度对服务器内部做一次清灰除尘,对于运行超过5年的机械硬盘,即便状态显示正常,也建议提前规划更换周期。
问:中小企业没有专职运维,如何应对服务器安全维护怎么做的问题?
答: 没有专职运维人员,更应采用“重武器”策略,建议直接采购云服务商提供的托管式安全服务,或者使用云防火墙、Web应用防火墙(WAF)等产品,在系统层面,务必启用操作系统的自动安全更新,并关闭不必要的端口和服务,务必购买云服务商提供的快照服务,做到每日快照,这是应对勒索病毒最稳妥的手段。
问:服务器维护需要做哪些内容能有效预防宕机?
答: 预防宕机的核心在于冗余和快速恢复,硬件层面,电源和网卡必须做成冗余(双电源、双网卡绑定),系统层面,合理配置RAID阵列,数据层面,确保备份自动化和恢复演练常态化,更为关键的是,在应用架构上,尽量避免单点故障,如果业务允许,使用负载均衡将流量分发到至少两台服务器上,任何一台物理机维护或故障时,业务均不受影响,做好了以上这些,自然就能最大程度降低业务中断风险。
服务器的维护是一场“持久战”,没有一劳永逸的灵丹妙药。把每一次巡检都当成一次阅兵,把每一次备份都当成最后的退路,把每一次补丁更新都当成加固城墙的砖石。 善用自动化监控工具,将精力聚焦在架构优化与应急预案上,这台“数字发动机”才能持续稳定地输出动力。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/798035.html