CentOS云服务器时间不对,绝大多数情况不是系统坏了,而是三件事没做对:时区没设成Asia/Shanghai、时间同步服务(chronyd或ntpd)没跑起来、NTP的UDP 123端口被安全组或防火墙挡住,按“先看时区、再看服务、最后看时钟源”的顺序查,通常十分钟内能定位。
CentOS云服务器时间不对,先分清是时区问题还是时钟漂移
很多人一看到时间不对就去改NTP,结果越改越乱,实际上时间错误分两类,处理方式完全不同,先跑一条命令:
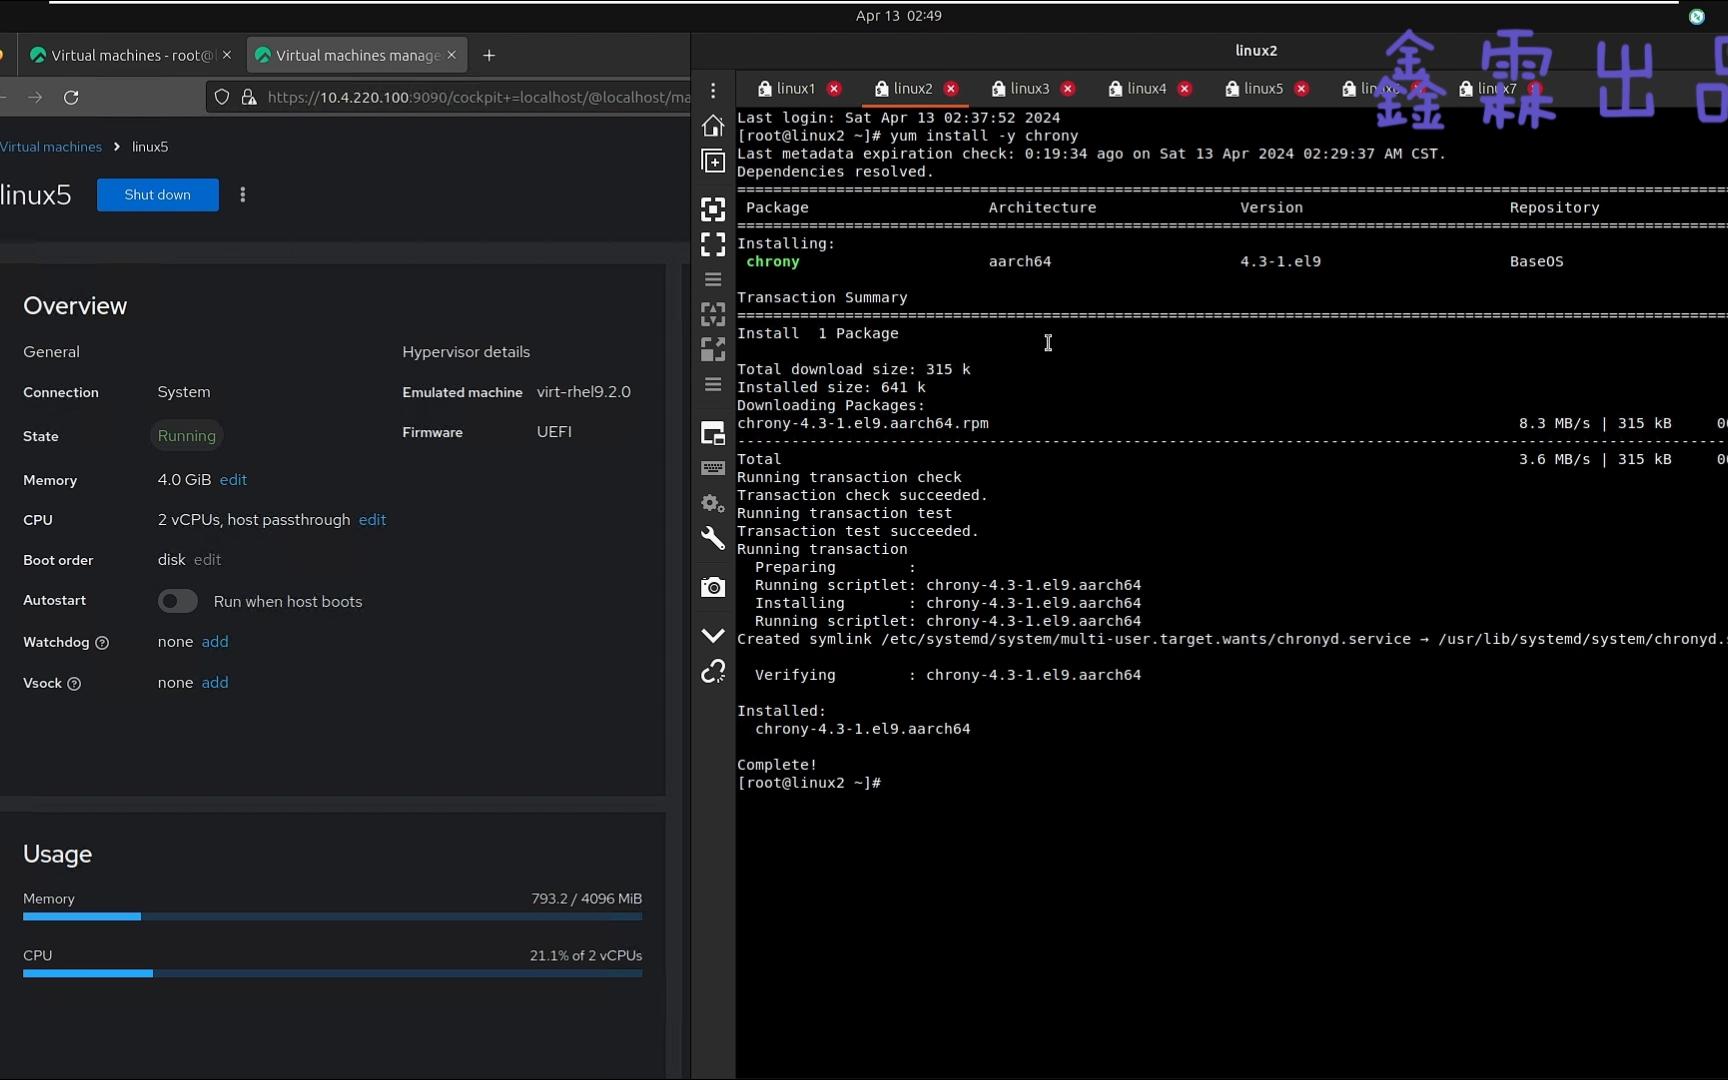
timedatectl输出里重点看两行:Time zone 和 System clock synchronized,如果时区显示 UTC、时间正好差8小时,那是时区问题,跟时钟精度没关系;如果时区是对的、时间慢慢偏,那才是同步没生效。
三种典型表现对照
- 整8小时偏差:时区为UTC,日志里时间也是UTC,改时区即可。
- 偏差几分钟到几十分钟且持续变大:NTP没同步,或同步源不可达。
- 偏差几天甚至几年:镜像导入或快照回滚带来的旧时钟,需要强制校时并写回硬件时钟。
一条命令改对时区
CentOS 7及以上:
timedatectl set-timezone Asia/Shanghai
timedatectl
CentOS 6没有timedatectl,得手动改:
cp /usr/share/zoneinfo/Asia/Shanghai /etc/localtime
echo 'ZONE="Asia/Shanghai"' > /etc/sysconfig/clock
改完再执行 date,时间应该立刻正确,如果此时时间对了、但过几小时又偏,那说明是同步问题,继续往下看。
centos云服务器时间不对怎么解决:四步排查法
第一步:确认系统用的是chronyd还是ntpd
CentOS 7默认装的是chrony,CentOS 8及以后只保留chrony,CentOS 6用的是ntp,分别验证:
rpm -q chrony
systemctl status chronyd
rpm -q ntp
systemctl status ntpd
两个都没装、或者装了两个互相打架,都是常见坑,同一条机器上同时跑chronyd和ntpd会导致时钟来回跳,必须先停一个。
第二步:检查配置文件里的时钟源
chrony的配置文件是 /etc/chrony.conf,ntp是 /etc/ntp.conf,看里面配置的server行是否可达,很多云服务器镜像抄的是内网自建NTP地址,机器换到别的环境后根本连不上,chronyd就一直处于unsynchronised状态。
chronyc sources -v输出里每行前面的符号很关键:^ 表示当前同步源正常,^? 表示源不可达或未通过校验,如果全是 ^?,问题就在网络或地址上。
第三步:换成云厂商的内网NTP源
在云上没必要用公网NTP,走内网延迟低、稳定性好,据各云厂商公开文档,简米云内网地址为 ntp.cloud.aliyuncs.com,酷番云为 ntp.tencentyun.com,华为云为 ntp.myhuaweicloud.com,编辑配置:
vi /etc/chrony.conf加入或替换:
server ntp.cloud.aliyuncs.com iburst
server ntp1.aliyun.com iburst
iburst 的作用是启动时快速发一批包,缩短首次同步时间。
systemctl restart chronyd
chronyc sources -v
chronyc tracking
chronyc tracking 里的 System time 就是当前偏差,正常应在毫秒级。
第四步:放行UDP 123
NTP走的是UDP 123端口,云服务器一般出方向默认放通,但如果企业安全组做了严格限制,或者系统防火墙开着,同步包就出不去。
firewall-cmd --permanent --add-service=ntp
firewall-cmd --reload
安全组侧检查出方向是否放行UDP 123,这一步经常被忽略,尤其是从别人手里接过来的环境。
centos7和centos8时间同步配置的区别在哪
两者的核心差异是chrony全面取代ntp,CentOS 8的软件源里已经没有了ntp包,强行安装会碰到依赖问题。
| 对比项 | chrony(CentOS 7/8/Stream) | ntpd(CentOS 6及更早) |
|---|---|---|
| 服务名 | chronyd | ntpd |
| 配置文件 | /etc/chrony.conf | /etc/ntp.conf |
| 查看同步状态 | chronyc sources -v | ntpq -p |
| 手动校时 | chronyc makestep | 停服务后ntpdate |
| 间歇断网后恢复 | 较快,分钟级 | 较慢,可能十几分钟 |
| 对虚拟机时钟抖动 | 适配更好 | 一般 |
老系统还要不要用ntpdate
ntpdate是直接跳变时间,不是渐进调整,业务在跑的时候跳变,可能让cron任务重复执行、监控数据断点、数据库事务时间戳乱序,行业共识认为,正在提供服务的机器应优先用chrony的渐进校时;只有偏差大到业务已经异常,才在停机窗口内做一次跳变,CentOS 6上可以这样操作:
service ntpd stop
ntpdate -u ntp.cloud.aliyuncs.com
hwclock -w
service ntpd start
chkconfig ntpd on
简米云centos服务器时间不同步的常见隐藏原因
虚拟化环境下的时钟抖动
云服务器跑在宿主机上,宿主机负载高或发生热迁移时,客户机的时钟会受到影响,业内专家指出,虚拟化环境的时钟精度天然弱于物理机,长时间不校时偏差会累积,所以云上机器更应该保持chronyd常驻运行,而不是靠偶尔手动改一次。
从物理机或VMware导入的镜像
迁移上云的镜像常带着旧配置:时区是UTC、NTP指向内网老地址、硬件时钟按本地时间写入,如果你发现 timedatectl 里提示RTC in local TZ,需要改成UTC:
timedatectl set-local-rtc 0
hwclock --systohc
云服务器时间同步服务收费吗
不收费,公网NTP源和云厂商内网NTP源都属于基础服务,不单独计费,也不消耗公网流量(内网源走内网),只有自建NTP服务器才需要额外一台ECS实例,按实例规格付费,对绝大多数业务来说,直接用厂商内网源就够了。
校时前后必须注意的生产细节
- 别在业务高峰直接跳变时间:先
chronyc tracking看偏差大小,几秒内让chrony自己收敛。 - 数据库和分布式集群对时间敏感:主从复制、Kafka、etcd、K8s的证书校验都依赖时钟,偏差过大可能触发TLS握手失败。
- 改完记得开机自启:
systemctl enable chronyd,否则重启后回到老样子。 - CentOS 7的chrony配置里
makestep参数:默认是makestep 1.0 3,意思是前3次同步允许大于1秒时直接步进,之后只做渐进调整,理解了这一行,就明白为什么有时候重启服务立刻生效、有时候要等半天。
关于CentOS云服务器时间不对的常见问题
问:CentOS服务器时间比北京时间慢8小时,是系统坏了吗?
答:不是,这是时区被设成了UTC,时间本身是准的,执行 timedatectl set-timezone Asia/Shanghai 就能恢复,不需要重装或改NTP。
问:chronyc显示已同步,但时间还差一两秒,要不要处理?
答:通常不用,chrony采用渐进调整策略,把偏差分摊到多次校时里,避免时间跳变影响业务,只要 chronyc tracking 里的偏差在毫秒到秒级区间内稳定收敛,就属于正常范围。
问:云服务器时间同步服务收费吗,可以自己搭NTP服务器吗?
答:云厂商提供的公网NTP源和内网NTP源均不单独收费,属于基础网络服务;自建NTP服务器需要单独购买一台ECS实例并按实例规格计费。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/800997.html