服务器故障不是单一问题,而是一个从硬件到软件、从网络到安全的完整故障链多数宕机由硬盘损坏、内存错误、系统崩溃、网络攻击和配置失误五类原因引发,其中硬件故障占比最大。 搞清楚这些故障的表现、成因和排查方法,比出了问题再慌乱更有意义。
现代业务几乎都跑在服务器上,从企业官网到电商平台、从数据库到容器集群,一旦服务器出问题,直接影响就是业务中断和收入损失,行业内有个常识:相当一部分服务器宕机事件与硬件老化有关,尤其是机械硬盘和电源模块,下面按故障类型拆开讲清楚,每个类型都给出可落地的判断方法。
服务器常见故障有哪些五类高发故障逐一拆解
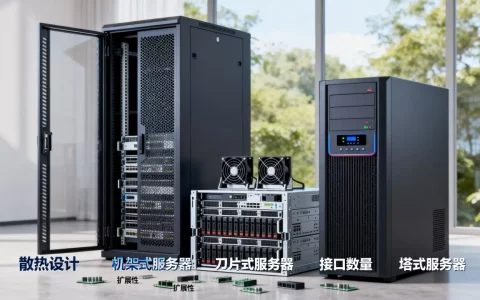
硬件故障:硬盘、内存、电源是三大高发区
这是服务器故障里最“实在”的一类,坏就是坏,不跟你商量。
硬盘故障是所有硬件中发生率最高的,机械硬盘有电机、磁头和盘片,长时间高负载运转后容易出现坏道,表现是读写速度骤降、文件无法打开、系统日志里出现大量I/O Error,固态硬盘虽然没有机械结构,但闪存颗粒有写入寿命上限,接近寿命时会出现只读状态,俗称“写保护”,据统计,超过三成的服务器硬件故障与存储设备有关。
判断方法很直接:登录系统的存储管理工具,查看硬盘健康状态,Linux下用smartctl -a /dev/sda查看SMART信息,如果Reallocated_Sector_Ct数值持续增长,说明盘在加速劣化,Windows服务器可在事件查看器中筛选“disk”来源的错误日志。
内存故障是个“伪装大师”,表现五花八门:系统频繁蓝屏、随机死机、进程无故被kill、数据库记录校验出错,因为内存是临时存储,出问题时数据不一定立刻损坏,但程序运行会变得极不稳定。
电源和散热故障常被忽略,却相当致命,电源老化后输出电压不稳,轻则重启,重则烧毁主板,散热风扇积灰转速下降,CPU温度飙升,触发过热保护自动关机,检查手段非常直接:进入BIOS看硬件监控页,或者用ipmitool sdr list读取传感器读数,重点关注CPU Temp和Fan RPM。
其他硬件故障还包括网卡失效导致的网络中断、主板上的电容鼓包爆浆、RAID卡电池耗尽导致缓存数据丢失,这些故障的共同特点是:出现前往往有征兆,但多数运维人员没当回事。
软件与系统故障:死机、崩溃、内核报错
硬件没坏,但服务器就是不安稳,问题大概率出在软件层。
操作系统崩溃是典型场景,Linux服务器可能出现Kernel Panic,屏幕上满屏报错,系统直接拒绝工作,Windows服务器则可能陷入蓝屏循环,反复重启进入不了桌面,行业共识认为,相当一部分系统崩溃与内核模块兼容性和驱动更新有关,尤其是非官方源安装的驱动。
软件冲突和资源耗尽是另一大来源,比如Java应用堆内存配置不当,出现OutOfMemoryError后频繁Full GC,CPU飙升到100%,整个系统响应迟缓,数据库连接池设置过大,把内存吃干净,其他应用全部排队等待,这类故障在业务量增长后特别容易爆发,属于典型的“慢刀子割肉”。
网络与安全故障:带宽耗尽、遭受攻击
服务器对外提供服务,网络就是生命线。
带宽耗尽最常见的元凶是业务突增、爬虫过度抓取、或日志同步把出口带宽打满,表现是用户访问缓慢、ping延迟飙升、带宽监控曲线拉平到峰值。
DDoS攻击更直接,流量洪水直接涌入服务器,让服务彻底瘫痪,攻击目标集中在Web端口、DNS服务或游戏服务器上,更隐蔽的是CC攻击,模拟正常用户请求,反复请求高消耗接口,让应用层资源耗尽。
系统入侵也在逐年增多,弱口令爆破、Redis未授权访问、WebShell上传后门,都是常见手段,服务器一旦被入侵,轻则被植入挖矿程序CPU飙升,重则数据被加密勒索。
配置与人为失误:最不该犯但最常犯的错
这类故障没有技术门槛,却远比硬件故障更频繁。“服务器故障怎么排查”时,第一步先问自己:最近改了什么配置?
运维行业多次出现这样的案例:线上服务器磁盘告警,值班人员为了“释放空间”,手误执行了rm -rf删除目录;数据库迁移时切换顺序出错,主从数据不一致;防火墙规则写错,放行端口没生效,业务直接断了,据工信部信息技术服务标准工作组的相关材料显示,较大比例的运维事故源于人为操作失误,而非硬件损坏。
服务器故障怎么排查从现象倒推根因
故障排查的核心思路就八个字:先看现象,再挖根因,不要一开始就猜哪个硬件坏了,按流程走效率最高。
第一步:确认故障影响范围
是单台服务器挂掉,还是整个机柜网络不通?是只有某个网站访问不了,还是所有服务全部瘫痪?先登录监控面板,看看是CPU、内存、磁盘还是带宽先到达瓶颈,这一步能给你一个初步判断方向。
第二步:查看日志定位具体报错
日志是故障现场的“录像回放”,Linux系统重点看/var/log/messages、/var/log/syslog、/var/log/dmesg,排查应用问题则看具体的应用日志目录,一条典型的内存故障内核日志会这样显示:Out of memory: Kill process,这基本上能锁定内存耗尽的方向。
第三步:针对硬件逐一测试
- 硬盘:执行
smartctl -a /dev/sda查看健康度,或用badblocks扫描坏道 - 内存:用
memtest86+启动测试工具运行两轮以上,报错即更换 - 电源:查看BMC/iLO/IDRAC的电源状态,关注电压是否波动
- CPU:查看
top中%wa(I/O等待)和%us(用户态占用)数值,结合温度判断是否降频
第四步:确认网络和外部攻击
用iftop看实时带宽占用,用ss -lntp查看当前连接数,如果某个IP连接数异常夸张,多半在遭受扫描或攻击。tcpdump抓包能精准看到异常流量特征。
服务器硬件故障有哪些典型表现如何提前预判
不同硬件故障的表现与处理优先级
| 故障部件 | 典型表现 | 预判信号 | 处理优先级 |
|---|---|---|---|
| 硬盘 | 读写慢、文件报错 | 坏道增多、SMART报警 | 极高,立刻备份更换 |
| 内存 | 随机死机、进程被杀 | 系统日志出现ECC报错 | 高,尽快更换 |
| 电源 | 无故重启、无法开机 | 风扇异响、电源指示灯闪烁 | 极高,需即时更换 |
| CPU | 性能骤降、过热关机 | 风扇狂转、温度居高不下 | 中高,清灰换硅脂 |
| 网卡 | 网络时断时续 | 丢包率异常 | 中,优先查驱动 |
提前预判的三个核心指标
磁盘使用率超过80%、CPU温度持续高于75度、内存占用率长期接近100%,出现这三个信号,意味着服务器随时可能罢工,不要等到报警才动手,定期巡检比故障后的“救火”更有价值。
如何降低服务器故障率做好这三件事
建立硬件冗余和备份机制
重要的业务服务器至少采用双电源、RAID1或RAID10磁盘阵列,数据库服务器可采用一主一从,发生故障时自动切换,核心业务必须做异地备份,备份是最后一道防线,没有备份谈故障处理都是空话。
配置监控和告警系统
使用Zabbix、Prometheus或云厂商自带的监控产品,监控CPU、内存、磁盘、带宽和关键进程,告警规则要设置合理的阈值,比如CPU超过85%持续5分钟就推送通知,磁盘剩余空间低于20%就发出警告,监控的价值在于让你在故障发生前有干预时间。
变更管理和操作审计
所有配置文件修改、软件升级、防火墙规则变更,都要有记录和回滚方案,重要的操作先在测试环境演练,再在线上执行,行业共识认为,严谨的变更流程能减少大部分人为故障,这不是流程束缚,而是保护团队。
常见故障处理场景问答
服务器突然无法远程登录,怎么处理?
先从宿主机或机房管理平台查看服务器是否在线,如果系统运行中但网络不通,可能是防火墙规则变更或网卡驱动异常,登录物理控制台检查网络配置,ping网关测试链路,大概率能定位问题所在。
服务器频繁自动重启是什么原因?
优先怀疑电源模块老化或电压不稳,其次排查CPU过热、内存故障和系统更新冲突,查看系统日志中重启前的最后记录,如果没有任何明确报错就突然断电,硬件问题的可能性更大,电源故障是网站服务器故障原因中的高发项,这点在运维圈已有较多共识。
服务器故障处理流程有没有通用步骤?
有,常规流程是:先确认故障范围和影响程度,再查看监控与日志定位故障类型,硬件问题按备件更换流程处理,软件问题优先尝试快速恢复手段(如重启服务、回滚配置),最后恢复业务后补写故障报告并优化监控,这套流程在大多数场景下都能兜底,关键执行要快。
服务器故障从来不是“会不会来”的问题,而是“什么时候来”的问题。把常见的故障类型、排查路径和预防手段装进脑子里,遇到状况时才不会手忙脚乱。 硬件该换就换,配置该审就审,备份该做就做,这三条做到位了,服务器故障率自然大幅下降。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/802429.html