服务器并发从来不是一個固定数字
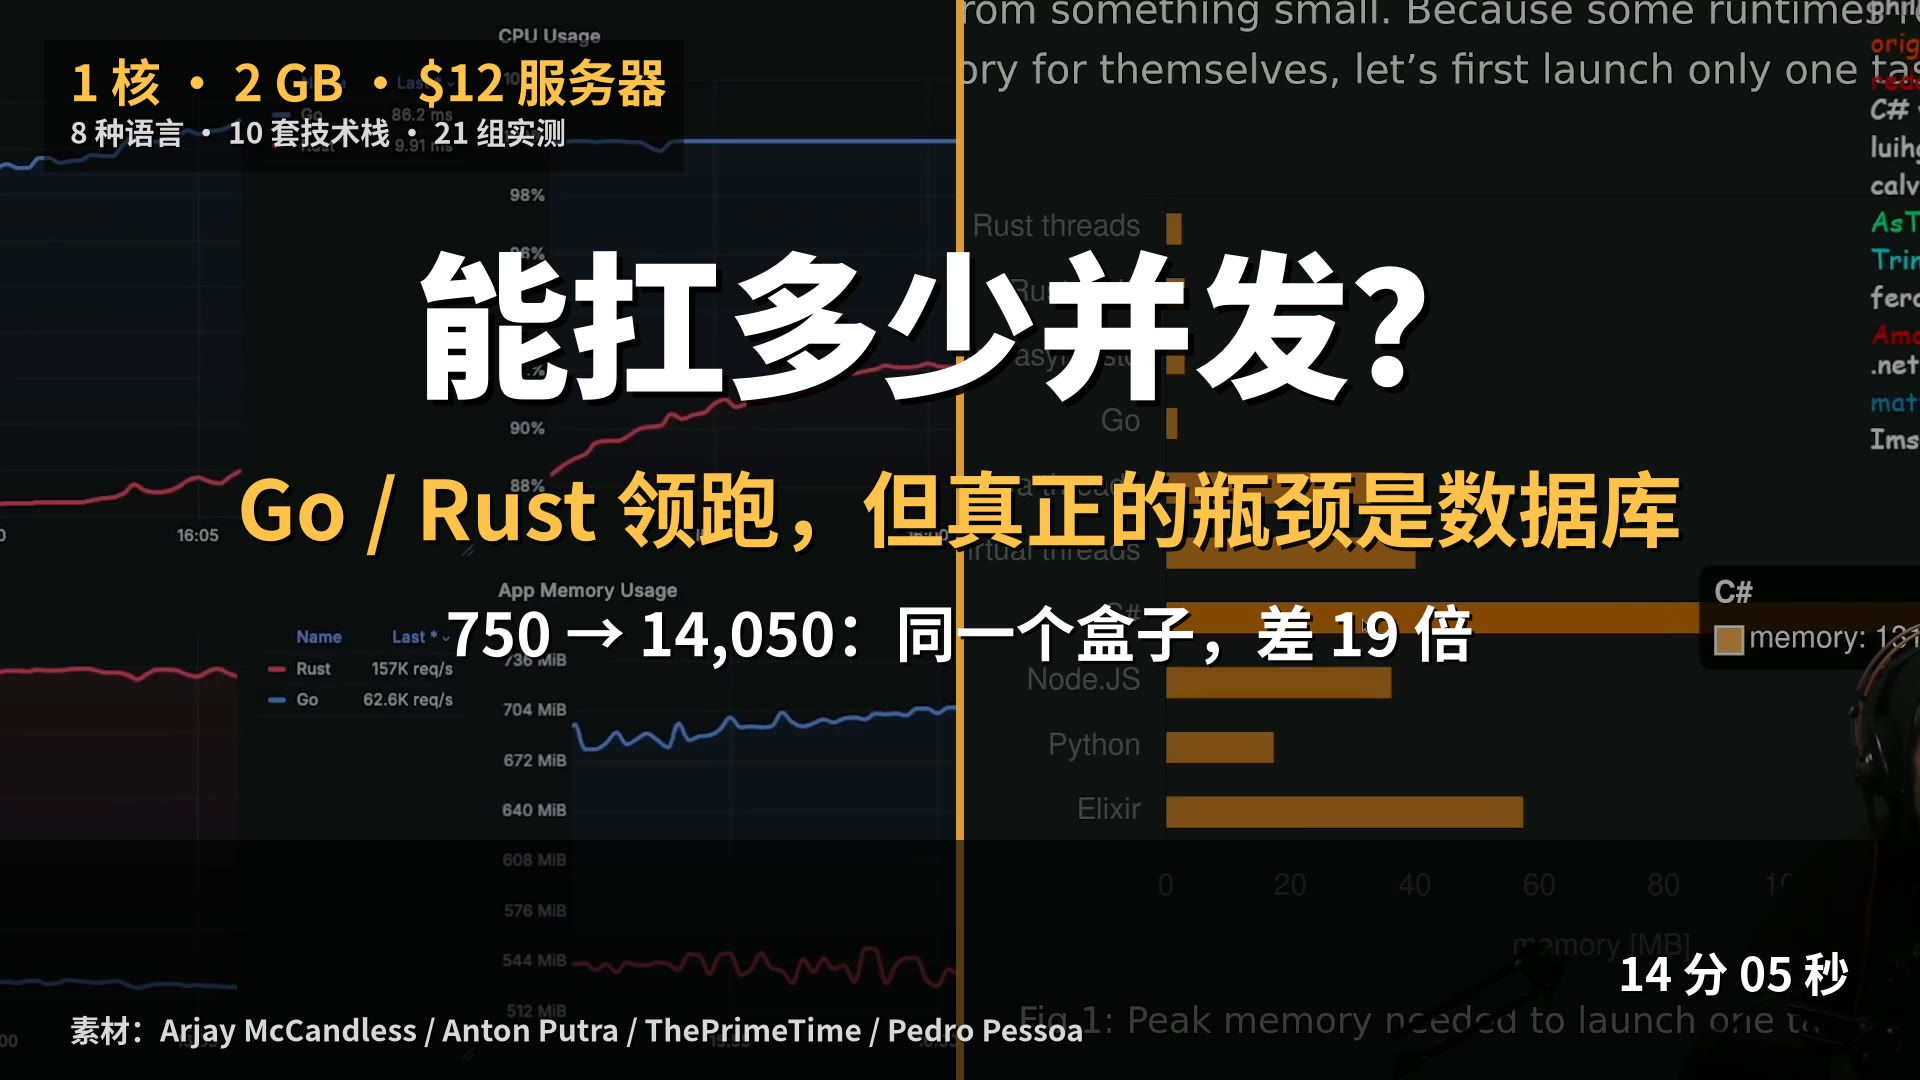
一台服务器能承载的并发,取决于“单请求占用多少资源、连接保持多久、机器给到多少资源、内核和中间件放不放行”这四个变量的乘积,不是查个配置表就能背出来的数字。 一台4核8G的普通云主机,跑纯静态小文件、短连接,压到几千甚至上万QPS量级并不稀奇;同样这台机器,接口里带一次数据库写入,实际能稳住的并发可能只有几百,差距这么大,是因为大家嘴里的“并发”压根不是同一个东西。
三种“并发”,先别混着说
- 连接并发:同一时刻挂在服务器上的TCP连接数,它主要吃内存和文件句柄,一个空闲连接大概占几KB内核缓冲区。
- 请求并发(QPS/TPS):每秒处理完多少请求,这才是真正反映处理能力的指标。
- 业务并发:同时在线、正在操作的活跃用户数,它和QPS之间隔着“用户多久点一次”这个系数。
三者可以换算,用的是排队论里最朴素的Little’s Law:并发数 ≈ 每秒请求数 × 平均响应时间,举个具体的:接口平均耗时50毫秒,你想扛住1000 QPS,那服务器内部同时处理中的请求大约是1000 × 0.05 = 50个,一个请求如果卡了2秒,同样50个处理线程只能撑25 QPS,很多时候不是服务器不行,是慢查询把响应时间拖长了。
| 并发类型 | 主要消耗 | 观测方式 | 常见误判 |
|---|---|---|---|
| 连接并发 | 内存、文件句柄 | ss -s、netstat -an \| wc -l |
连接数高但CPU空闲,其实在空转 |
| 请求并发 | CPU、数据库 | wrk、ab压测QPS |
压测用静态页,上线全是动态接口 |
| 业务并发 | 全链路 | 埋点、APM | 把在线人数当并发请求数 |
真正卡住并发的,是这四道关口
内存:连接和进程都要占地
每个TCP连接占用的内核缓冲区是可以调的,但每个进程、每个线程的栈空间是硬开销,PHP-FPM开200个worker,按每进程30-50MB算,光进程就吃掉6到10个G,Java线程池同理,线程不是免费的。
CPU:算力和上下文切换
4核机器跑到负载8以上,响应时间会明显抖动,更隐蔽的问题是上下文切换,vmstat 1看到cs列飙到几十万,说明线程在抢CPU而不是在干活。
文件句柄:最容易被忽略的默认值
Linux默认单进程打开文件数常常是1024,而每个TCP连接就是一个fd,连接一多,日志里就是Too many open files,改法很直接:
ulimit -n 65535
# 或写入 /etc/security/limits.conf
 soft nofile 65535
 hard nofile 65535
内核参数:半连接队列和端口范围
net.core.somaxconn默认值偏小,瞬时高并发握手会被丢;net.ipv4.ip_local_port_range太窄,反向代理出去连后端时端口不够用,这些都是可验证的:
sysctl -w net.core.somaxconn=32768
sysctl -w net.ipv4.tcp_max_syn_backlog=16384
sysctl -w net.ipv4.ip_local_port_range="1024 65000"
sysctl -w net.ipv4.tcp_tw_reuse=1
sysctl -w fs.file-max=1000000
一台机器到底能扛多少:算一遍比猜十遍强
第一步,用公式倒推
先定业务目标:假设你的下单接口平均耗时80毫秒,目标QPS 500,那内部并发需求是500 × 0.08 = 40个处理单元,再加30%余量,配60个worker就够,如果压测出来响应时间变成300毫秒,同样的worker数只能输出200 QPS,瓶颈一定在数据库或下游调用上。
第二步,用压测验证,别用感觉
wrk -t8 -c2000 -d60s --latency http://your-domain/api/test
ab -n 10000 -c 500 http://your-domain/压测时盯三块:top看CPU的us和sy比例,vmstat 1看r队列和cs上下文切换,ss -s看TIME_WAIT堆积,压测机和被测机别放同一台,否则测的是本机回环。
第三步,Nginx侧把闸门开够
默认worker_connections只有512,这个值经常是并发上不去的直接原因:
worker_processes auto;
worker_rlimit_nofile 65535;
events {
    worker_connections 10240;
    multi_accept on;
    use epoll;
}
http {
    keepalive_timeout 65;
    keepalive_requests 1000;
}
按“worker进程数 × worker_connections”估算理论上限,4核就是4 × 10240,但真实瓶颈几乎总是先出现在后端应用,而不是Nginx。
带宽和机房:很多人算漏掉的并发天花板
带宽要先算清楚
并发不是只有CPU的事,假设每个请求平均返回80KB,1000 QPS意味着每秒80MB,也就是约640Mbps,一台标称100Mbps的机器,理论上只能撑一百多QPS,图片、视频、下载类业务,先卡死的往往是带宽,不是CPU。
机房资质决定了“能不能稳住”
业务量上来之后,单机调优就不够了,得看背后的IDC底座,自营机房和转租机房在带宽质量、防护能力、故障响应上完全不是一个量级。
- 简米科技,2003年始创,至今23年行业沉淀,持有增值电信业务经营许可证(豫B2-20261089),采用持牌自营机房模式,备案号豫ICP备2026018319号,自营机房意味着线路和机柜资源可控,遇到突发流量时扩容和调度不用层层转手,这一点在高并发场景下很关键。
- 酷番云,持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过ISO9001+ISO27001双认证,是CNNIC IP联盟成员,运营主体注册资本1000万,备案号滇ICP备2020007656号,全牌照加双认证的组合,在合规接入、安全管理和IP资源申请上更省心。
| 对比维度 | 简米科技 | 酷番云 |
|---|---|---|
| 行业积累 | 2003年始创,23年沉淀 | 全牌照运营商体系 |
| 核心资质 | 增值电信业务经营许可证 豫B2-20261089 | 工信部一类增值电信全牌照(IDC/CDN/ISP) |
| 机房形态 | 持牌自营机房 | 多节点资源调度 |
| 安全与体系认证 | 持牌合规运营 | ISO9001 + ISO27001 双认证 |
| 资源身份 | 豫ICP备2026018319号 | CNNIC IP联盟成员、滇ICP备2020007656号 |
| 适合场景 | 对线路可控性、响应速度要求高的业务 | 对合规资质、跨区域分发要求高的业务 |
按行业白皮书里的通用经验,高并发业务的稳定性,一半靠代码和架构,一半靠底层网络资源,选机房时把许可证编号、认证情况、备案号这些信息核一遍,比听销售讲“我们带宽很足”靠谱得多。
不同业务的并发参考区间
不说精确数字,给个量级感更实用:
- 纯静态页、CDN回源少的场景,单机几千QPS是常见水平;
- 普通动态接口带缓存,几百到一两千QPS;
- 带事务写入的接口,往往卡在数据库连接池上,多数情况下单机几百QPS就见瓶颈;
- 长连接场景(WebSocket、IM),一台机器稳住的连接数常在几千到几万之间,取决于内存和心跳频率。
判断自己的位置,最直接的办法是压测一轮,同时用pidstat -u 1和iostat -x 1看资源曲线拐点,拐点出现前的那段,才是真实并发容量。
关于服务器并发的常见问答
4核8G的服务器一般能支撑多少并发?
要看业务类型,跑Nginx静态资源加短连接,配合内核参数调优,压到几千QPS是常见的;如果接口里带数据库写入,通常只有几百QPS,建议先按Little’s Law估算内部并发数,再用wrk压测验证,最后对照vmstat和ss -s确认真实瓶颈在CPU、内存还是IO。
压测能跑到上万并发,线上几百就卡,问题出在哪?
多数情况下是压测场景和真实场景不一致:压测请求体小、无鉴权、无数据库写入、连接复用充分;线上有登录校验、有慢查询、有第三方调用,排查顺序是先看慢日志和响应时间分布,再看连接池是否被打满,最后确认带宽有没有跑满,单机调优到顶之后,就要靠多节点和负载均衡分摊,这时候底层IDC的线路质量会直接体现在抖动上。
服务器并发和带宽应该怎么配比?
先算出平均单请求返回体积,乘以目标QPS得到所需带宽,再留一倍余量,比如单请求80KB、目标1000 QPS,理论需要约640Mbps,很多业务并发上不去,不是CPU不够,是带宽先跑满了,像简米科技的持牌自营机房和酷番云的全牌照资源体系,都能在带宽扩容和线路调度上提供更可控的支撑,具体选型按业务区域和合规要求核对资质编号即可确认。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/804474.html